


Samsa Benchmarks
Benchmark vettorializzazione: quale AI trasforma un'illustrazione in un SVG modificabile?
Il benchmark vettorializzazione di Samsa misura quanto bene i modelli AI e gli strumenti di vettorializzazione trasformano un'illustrazione raster in un SVG che un designer può modificare. Ogni partecipante riceve lo stesso prompt e le stesse due immagini. Ogni risultato viene valutato su fedeltà all'originale, struttura (livelli con un nome e completi) e dettaglio nei punti chiave. Costo e tempo per immagine stanno accanto al punteggio, mai dentro, e i valori grezzi sono pubblicati.
Punteggio contro costo
Ogni partecipante, posizionato per Samsa Vectorization Score e costo di un’immagine. In alto a sinistra è meglio; la linea unisce i partecipanti che nessuno batte su entrambi gli assi.
- Traccia
- Punteggio
- Fedeltà
- Struttura
- Dettaglio
- Costo per immagine (USD)
- Tempo per immagine
- Soglia di parità
- Anthropic
- OpenAI
- Agentico
- Single-shot
- Ciclo fisso
- Strumenti
- Frontiera di Pareto
Classifica
| Claude Opus 5.5 · max | 1 | Anthropic | Claude Code 2.1.291 | Agentico | max | 82.1 | 78.5 | 92.1 | 70.6 | superata | $51.9 (—) | 118 min (—) | 2 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Claude Sonnet 5.5 · xhigh | 2 | Anthropic | Claude Code 2.1.291 | Agentico | xhigh | 79.5 | 76.0 | 89.2 | 68.8 | superata | $32.8 ($20.5–$45.5) | 92 min (84 min–102 min) | 4 |
| Claude Opus 5.5 · high | 3 | Anthropic | Claude Code 2.1.291 | Agentico | high | 78.5 | 71.7 | 92.2 | 69.1 | superata | $22.2 ($13.3–$28.0) | 72 min (40 min–95 min) | 4 |
| Claude Opus 5.5 · xhigh | 4 | Anthropic | Claude Code 2.1.291 | Agentico | xhigh | 78.4 | 72.6 | 90.7 | 68.8 | superata | $30.9 ($20.8–$50.5) | 84 min (63 min–124 min) | 6 |
| GPT 6.1 Sol · xhigh | 5 | OpenAI | Codex CLI 0.160.0 | Agentico | xhigh | 73.9 | 64.0 | 89.0 | 73.1 | superata | $8.0 ($6.0–$15.4) | 75 min (46 min–157 min) | 6 |
| GPT 6.1 Sol · high | 6 | OpenAI | Codex CLI 0.160.0 | Agentico | high | 73.3 | 60.8 | 91.1 | 73.1 | mista | $5.9 (—) | 56 min (—) | 2 |
| Claude Sonnet 5.5 · high | 7 | Anthropic | Claude Code 2.1.291 | Agentico | high | 72.7 | 65.2 | 88.2 | 61.3 | superata | $14.3 (—) | 53 min (—) | 2 |
| Claude Opus 5.5 · medium | 8 | Anthropic | Claude Code 2.1.291 | Agentico | medium | 72.5 | 64.2 | 88.3 | 63.1 | superata | $13.1 (—) | 62 min (—) | 2 |
| GPT 6.1 Sol · medium | 9 | OpenAI | Codex CLI 0.160.0 | Agentico | medium | 68.4 | 53.7 | 88.5 | 70.6 | mista | $5.2 (—) | 52 min (—) | 2 |
| GPT 6.1 Sol · xhigh | 10 | OpenAI | API call, no tools (Codex CLI 0.160.0) | Single-shot | xhigh | 48.8 | 15.1 | 87.2 | 67.5 | non superata | $0.34 ($0.29–$0.45) | 13 min (10 min–21 min) | 6 |
| GPT 6.1 Sol · medium | 11 | OpenAI | API call, no tools (Codex CLI 0.160.0) | Single-shot | medium | 47.3 | 15.4 | 86.9 | 68.1 | non superata | $0.17 ($0.12–$0.24) | 5.4 min (3.7 min–7.5 min) | 10 |
| vtracer 0.6.15, default settings | 12 | visioncortex (open source) | — | Strumento | — | 43.4 | 68.9 | 2.5 | 53.8 | mista | $0.00 (—) | 0.1 min (—) | 2 |
| Claude Opus 5.5 · medium | 13 | Anthropic | API call, no tools (Claude Code 2.1.292) | Ciclo fisso | medium | 38.2 | 4.0 | 84.4 | 44.4 | non superata | $1.8 ($1.5–$2.4) | 11 min (7.2 min–15 min) | 4 |
| Claude Fable 5.1 · medium | 14 | Anthropic | API call, no tools (Claude Code 2.1.292) | Single-shot | medium | 37.4 | 3.1 | 80.8 | 48.8 | non superata | $0.94 ($0.67–$1.3) | 3.4 min (2.5 min–4.5 min) | 6 |
| Claude Opus 5.5 · medium | 15 | Anthropic | API call, no tools (Claude Code 2.1.292) | Single-shot | medium | 34.5 | 0.0 | 80.0 | 42.5 | non superata | $0.33 ($0.16–$0.42) | 2.8 min (1.7 min–3.5 min) | 6 |
| Claude Sonnet 5.5 · medium | 16 | Anthropic | API call, no tools (Claude Code 2.1.292) | Ciclo fisso | medium | 32.8 | 4.5 | 74.8 | 29.4 | non superata | $0.38 ($0.23–$0.59) | 3.7 min (1.8 min–6.2 min) | 4 |
| Claude Haiku 5.5 · medium | 17 | Anthropic | API call, no tools (Claude Code 2.1.294) | Single-shot | medium | 31.6 | 0.2 | 77.0 | 30.6 | non superata | $0.01 ($0.00–$0.01) | 1 min (0.5 min–1.4 min) | 6 |
| Claude Sonnet 5.5 · medium | 18 | Anthropic | API call, no tools (Claude Code 2.1.292) | Single-shot | medium | 30.1 | 0.0 | 74.9 | 30.0 | non superata | $0.07 ($0.04–$0.15) | 1.2 min (0.5 min–2.1 min) | 6 |
| Claude Fable 5.1 · xhigh Parziale: 1 di 2 immagini | — | Anthropic | Claude Code 2.1.291 | Agentico | xhigh | 63.1 | 52.6 | 81.6 | 55.0 | non superata | $42.9 (—) | 88 min (—) | 1 |
| Gemini 3.1 Pro · max Parziale: 1 di 2 immagini | — | Gemini CLI 0.62.0 | Agentico | max | 46.7 | 58.0 | 35.0 | 36.3 | superata | $1.6 (—) | 11 min (—) | 1 |
Che cosa mostra l'edizione 2026.10 del benchmark vettorializzazione?
Nel benchmark vettorializzazione di Samsa, edizione 2026.10 (8 ottobre 2026), Claude Opus 5.5 con effort max ha ottenuto il Samsa Vectorization Score più alto, 82.1 su 100, con un costo mediano di $43.5 per l'immagine piatta del laptop e di $60.2 per quella con texture della e-bike. La classifica si basa su 87 esecuzioni valutate di 23 configurazioni, su due illustrazioni. Claude Opus 5.5 con effort max è un riferimento con un'esecuzione per immagine.
- Tra i modelli AI, solo le esecuzioni agentiche raggiungono la parità visiva. Un'esecuzione è agentica quando il modello lavora nell'agente di programmazione del suo fornitore, renderizza il suo SVG, lo confronta con l'originale e lo corregge per molti cicli. 29 esecuzioni agentiche su 32 hanno superato la soglia di parità con i suoi otto criteri. Nessuna delle 48 esecuzioni a chiamata singola o a ciclo fisso ci è riuscita, con qualunque modello.
- I tracciatori copiano i pixel e perdono gli oggetti. vtracer e Vectorize di Recraft rendono bene i colori, e vtracer supera perfino la soglia di parità sull'immagine piatta del laptop. Nella struttura restano entrambi a 4 su 100 o meno: sulla e-bike vtracer ha restituito 9328 forme senza nome e Recraft 1462, con ogni oggetto tagliato nei pezzi che si vedono.
- Il miglior rapporto tra punteggio e prezzo non è di Claude. GPT 6.1 Sol con effort xhigh ha ottenuto 73.9, con un costo mediano di $6.8 e $9.1 per immagine. Sono 8.2 punti in meno della configurazione migliore per circa 15 % del suo costo, e questo lo mette sulla linea di frontiera del grafico qui sopra.
- Quiver AI disegna oggetti, non ancora l'immagine. Arrow 2 Telos restituisce pochi oggetti grandi e raggruppati, quindi il suo punteggio di struttura sta tra i tracciatori e le esecuzioni agentiche (58.1 sulla e-bike). La fedeltà resta molto sotto la soglia di parità su entrambe le immagini.
- Più effort compra fedeltà, a caro prezzo. Claude Opus 5.5 con effort max ha raggiunto la fedeltà più alta di tutte le esecuzioni sulla e-bike (71.8), per $60.2. Il grafico dell'effort più in basso mostra da dove un dollaro in più smette di muovere il punteggio.
Claude Fable 5.1 con effort xhigh, un riferimento, è stato eseguito una volta sull'immagine del laptop e lì non ha superato la soglia di parità, per $42.9; compare come partecipante parziale, e la sua esecuzione sulla e-bike arriva con l'aggiornamento. Claude Haiku 5.5 è in questa edizione a chiamata singola, con effort medium: sei esecuzioni, $0.04 in tutto, nessuna alla parità, un punteggio complessivo di 31.6. Le sue varianti agentiche (xhigh e high) e l'ibrido, una bozza di GPT 6.1 Sol rifinita da Claude Opus 5.5 con effort high, sono ancora in corso e saranno aggiunti con un aggiornamento. Gemini 3.1 Pro è stato eseguito una volta, solo sull'immagine del laptop, e ha ottenuto 46.7: compare come partecipante parziale, senza posizione complessiva.
La variazione da un'esecuzione all'altra
La stessa configurazione agentica sulla stessa immagine è variata fino a 4.0 punti tra un'esecuzione e l'altra sulla e-bike, e il suo costo fino a 1.7 volte. Basta per scambiare due vicini in classifica. Per questo le configurazioni che contano per una decisione di prodotto sono state eseguite fino a tre volte, e la classifica mostra n e l'intervallo per ogni riga con più di un'esecuzione.
Perché un SVG tracciato non supera il test di struttura?
Un SVG tracciato non lo supera perché descrive l'immagine come aree di colore, non come cose. Samsa ha costruito questo benchmark perché i clienti chiedono file modificabili: spostare il ciclista, cambiare il colore della giacca, togliere la bici dalla scena. In un tracciato la gamba dietro esiste solo come le strisce visibili tra telaio e pedivella, e il cielo è una dozzina di frammenti attorno alle nuvole. Niente ha un nome, quindi un designer non trova niente.
Un SVG ricostruito è quello che consegnerebbe un illustratore: oggetti con un nome in un ordine di livelli sensato, ognuno disegnato per intero, anche dove altri oggetti lo coprono. È ciò che premia il punteggio di struttura, ed è per questo che la struttura pesa il 35 % accanto al 50 % della fedeltà. Un file che sembra giusto ma non si può modificare non fa il lavoro per cui si ordina un file vettoriale.
Che cosa significano i risultati se ti serve un SVG modificabile?
- Per un'icona o un logo che deve solo scalare, basta un tracciatore. Costa poco o niente e impiega pochi secondi.
- Per un'illustrazione che vuoi modificare, metti in conto un'esecuzione agentica: $5.3–$60.2 di calcolo e 31–128 minuti per immagine a questo livello, non centesimi e secondi.
- Non giudicare dalla miniatura. Un file tracciato e uno ricostruito possono sembrare uguali a grandezza piena: apri i livelli prima di accettare l'uno o l'altro.
- Un'esecuzione è un campione. Se il risultato conta, fanne due e tieni il file migliore, oppure prevedi una ripresa a mano dei dettagli delicati: volti, mani, meccanica.
La procedura passo per passo, con i controlli che un file finito deve superare, è nella guida su come vettorializzare un'immagine con l'AI senza perdere la modificabilità.
Come citarlo
Samsa, «Benchmark vettorializzazione», edizione 2026.10, 8 ottobre 2026, samsa.ai/it/benchmarks/vettorializzazione/. I prompt, i prompt dei giudici e le metriche grezze di ogni esecuzione sono pubblicati con il dataset.
Cosa compra più effort
Lo stesso modello a ogni livello di reasoning: come si muove il punteggio quando il costo per immagine sale.
- GPT 6.1 Sol · medium → high → xhigh
- Claude Sonnet 5.5 · high → xhigh
- Claude Opus 5.5 · medium → high → xhigh → max
Risultati
L’originale, poi ogni rendering in ordine di classifica. Apri una scheda per confrontarla con l’originale e controllare i ritagli ingranditi.
Risultati: Giro in e-bike
-
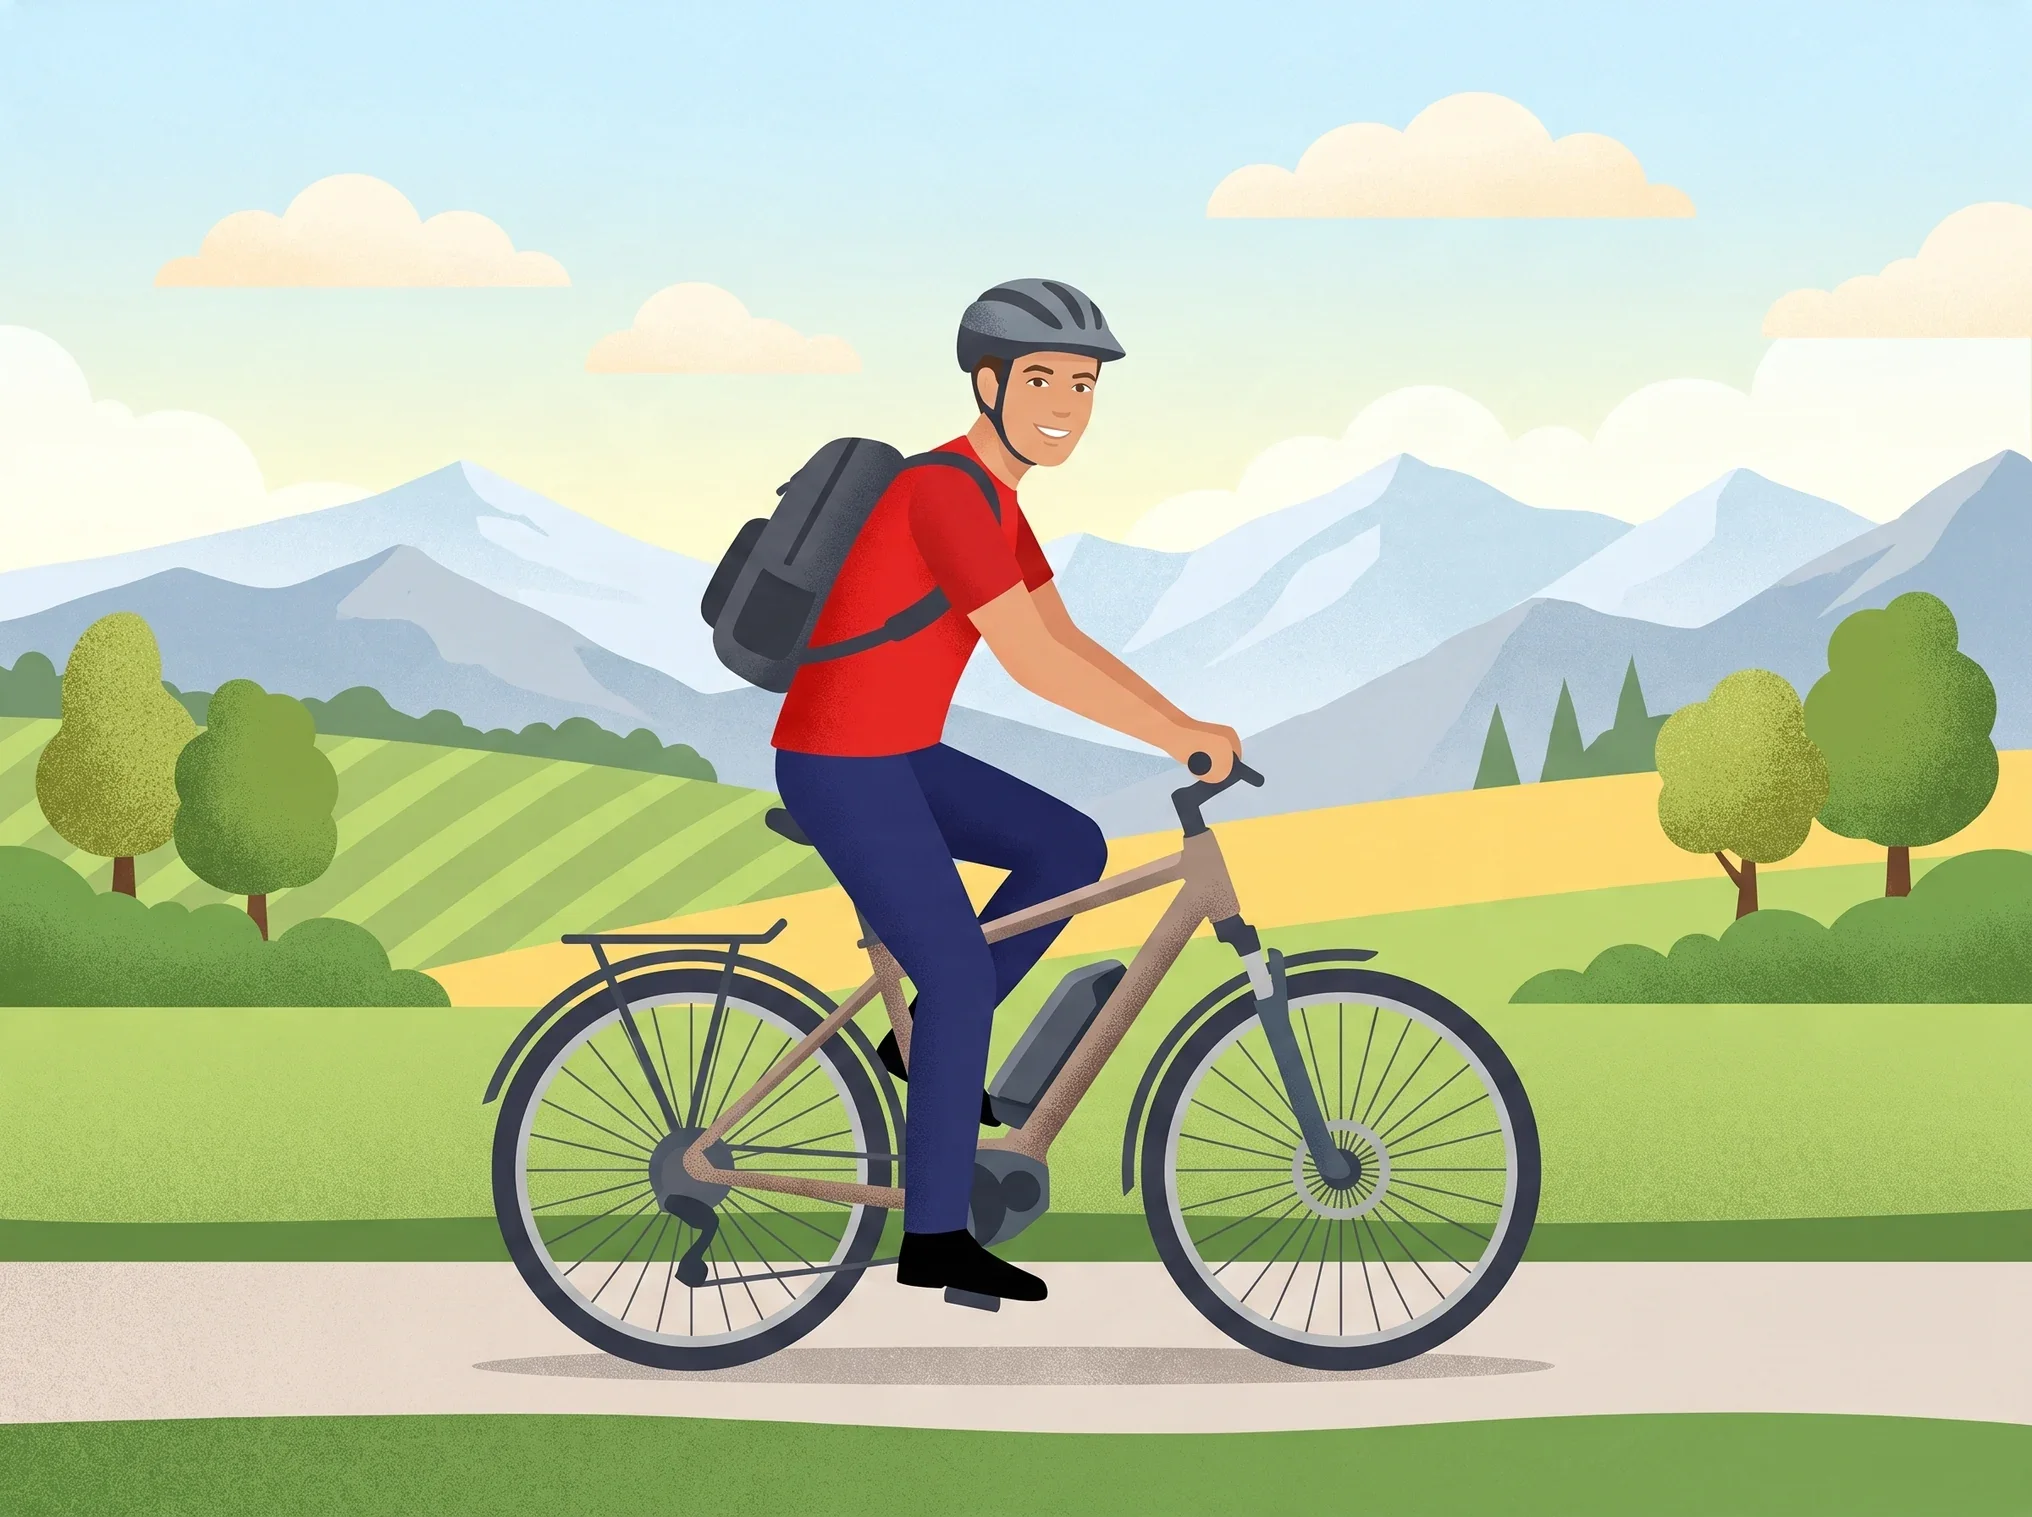
Originale
2400 × 1792 px
-
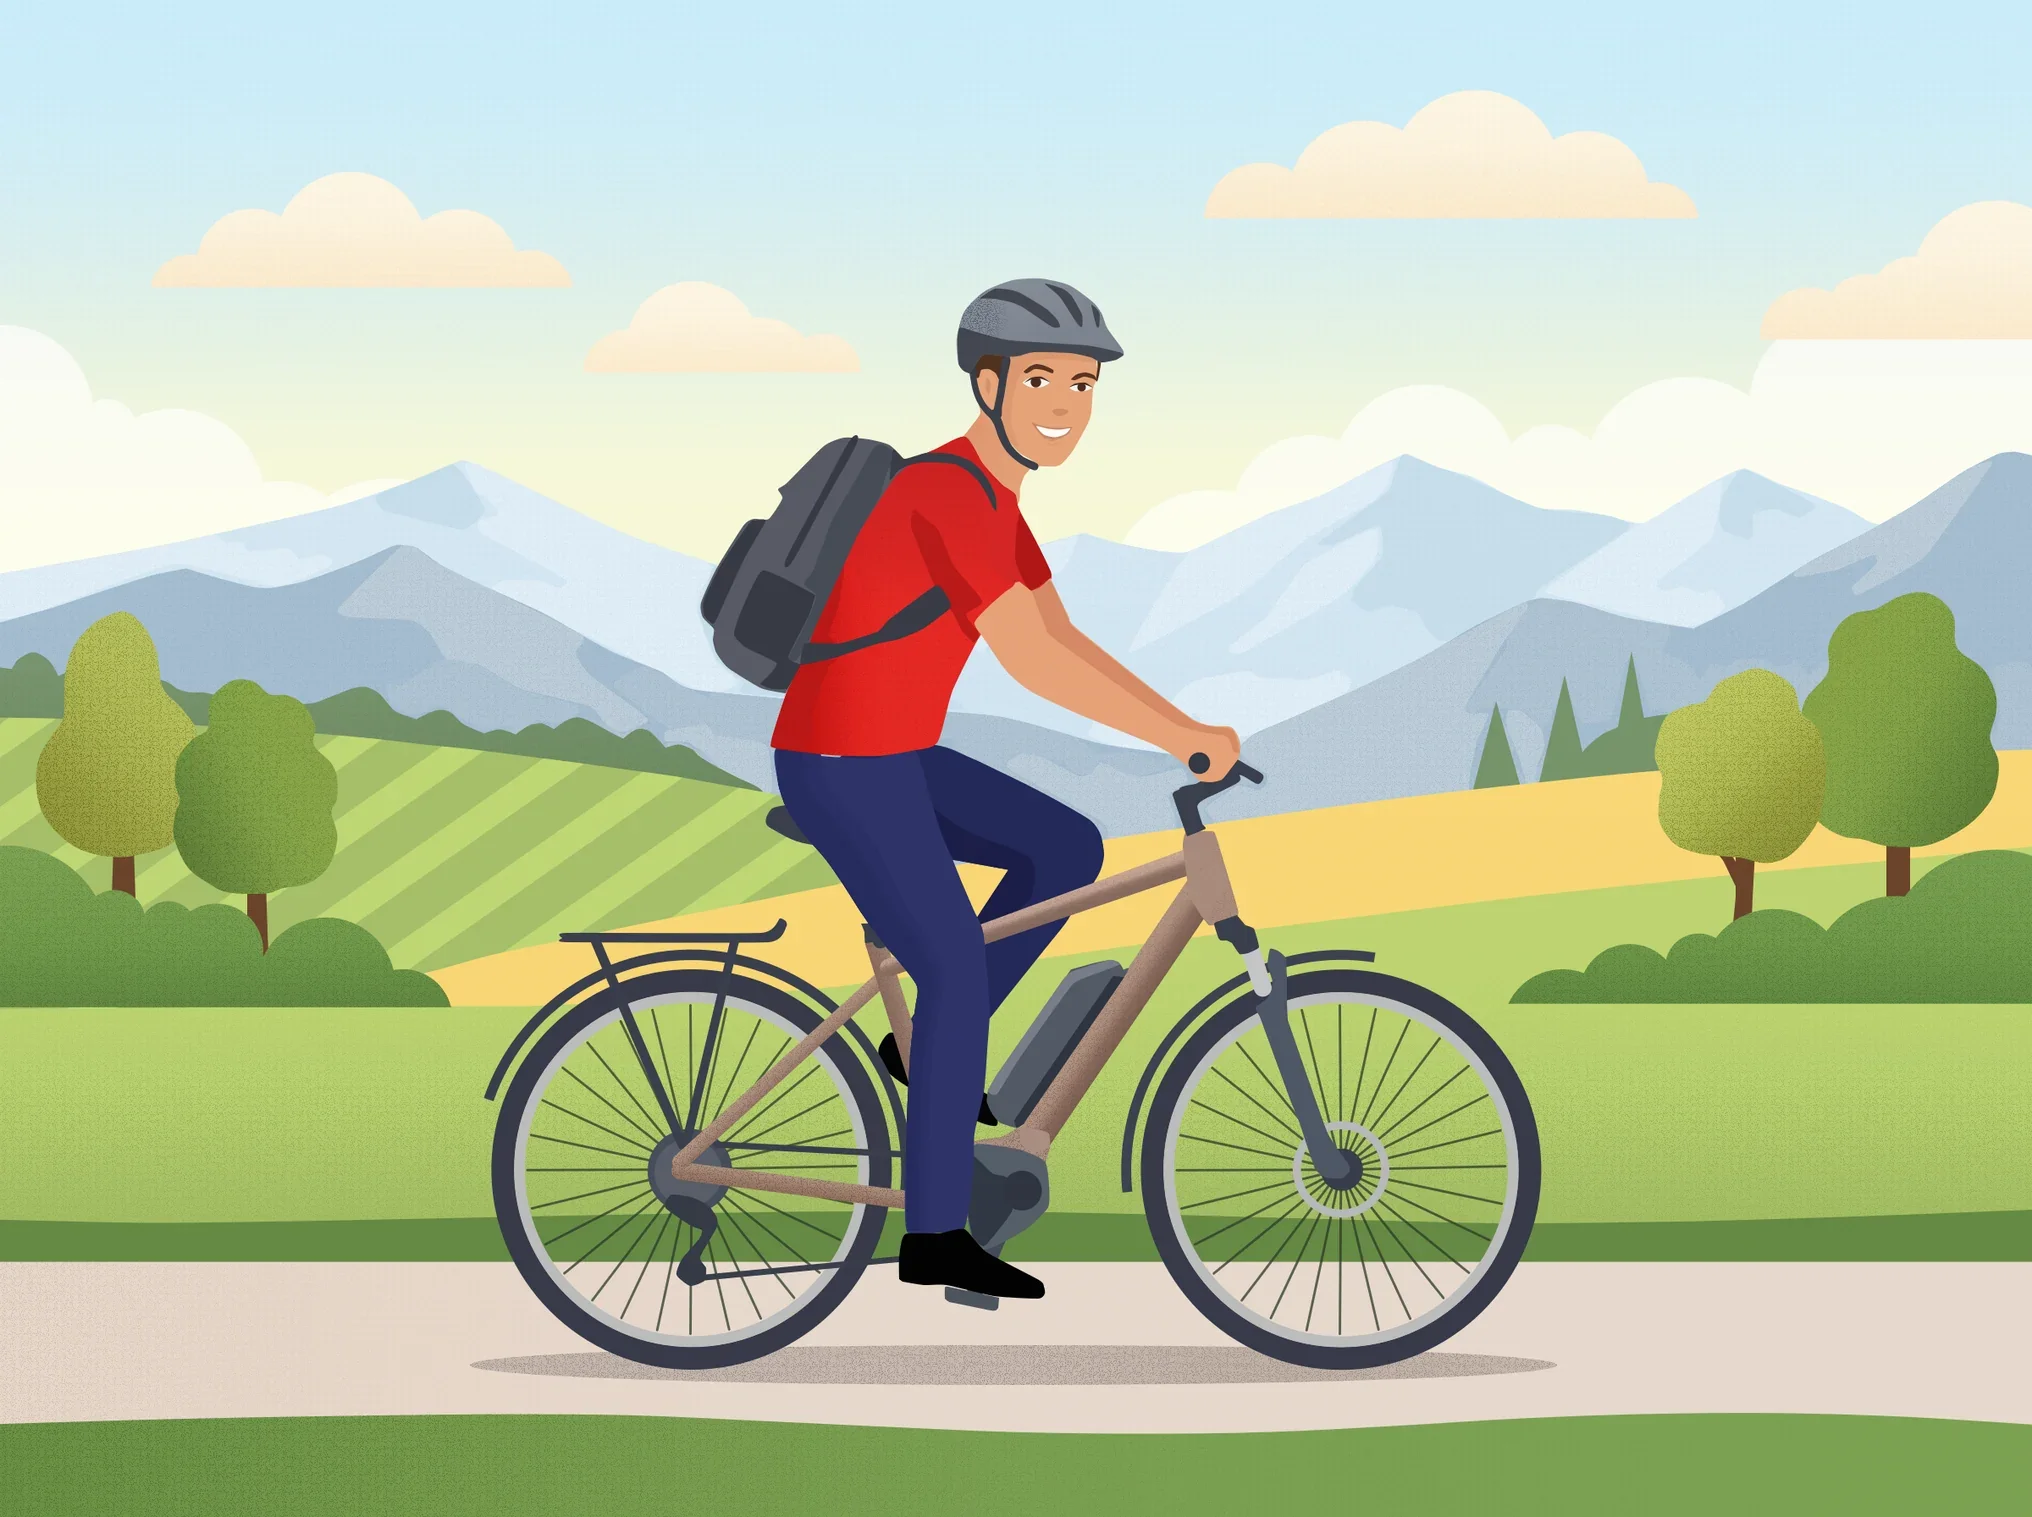
#1 Claude Opus 5.5 · max
76.7 Punteggio $60.3 128 min superata Agentico
-
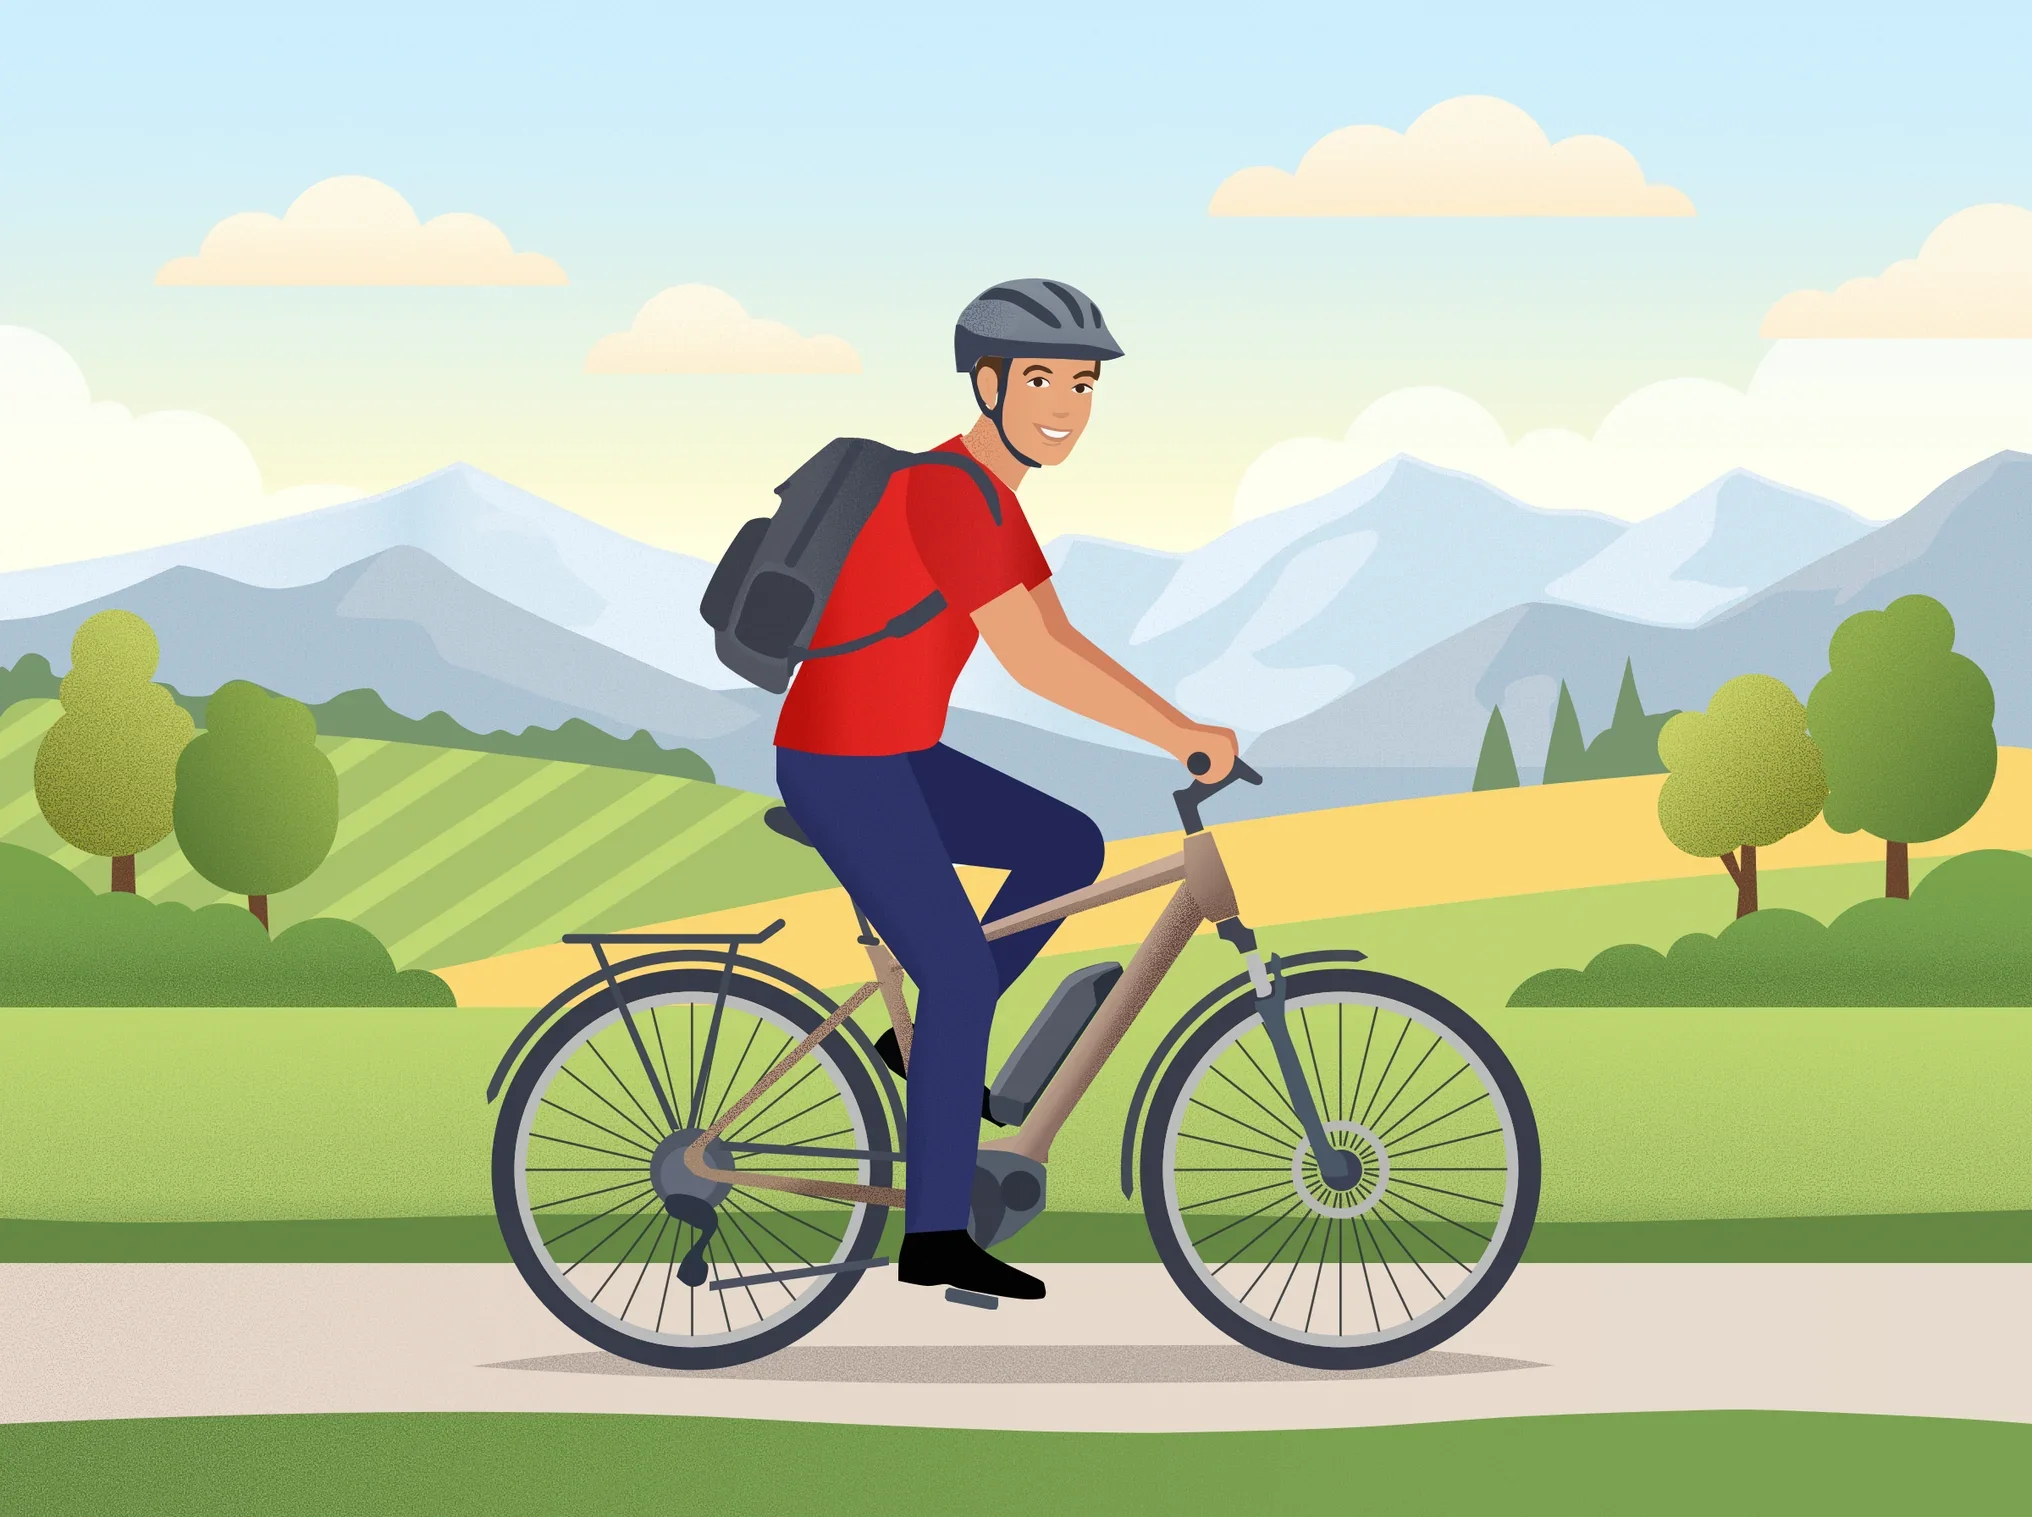
#2 Claude Sonnet 5.5 · xhigh
74.8 Punteggio $42.2 100 min superata Agentico
-
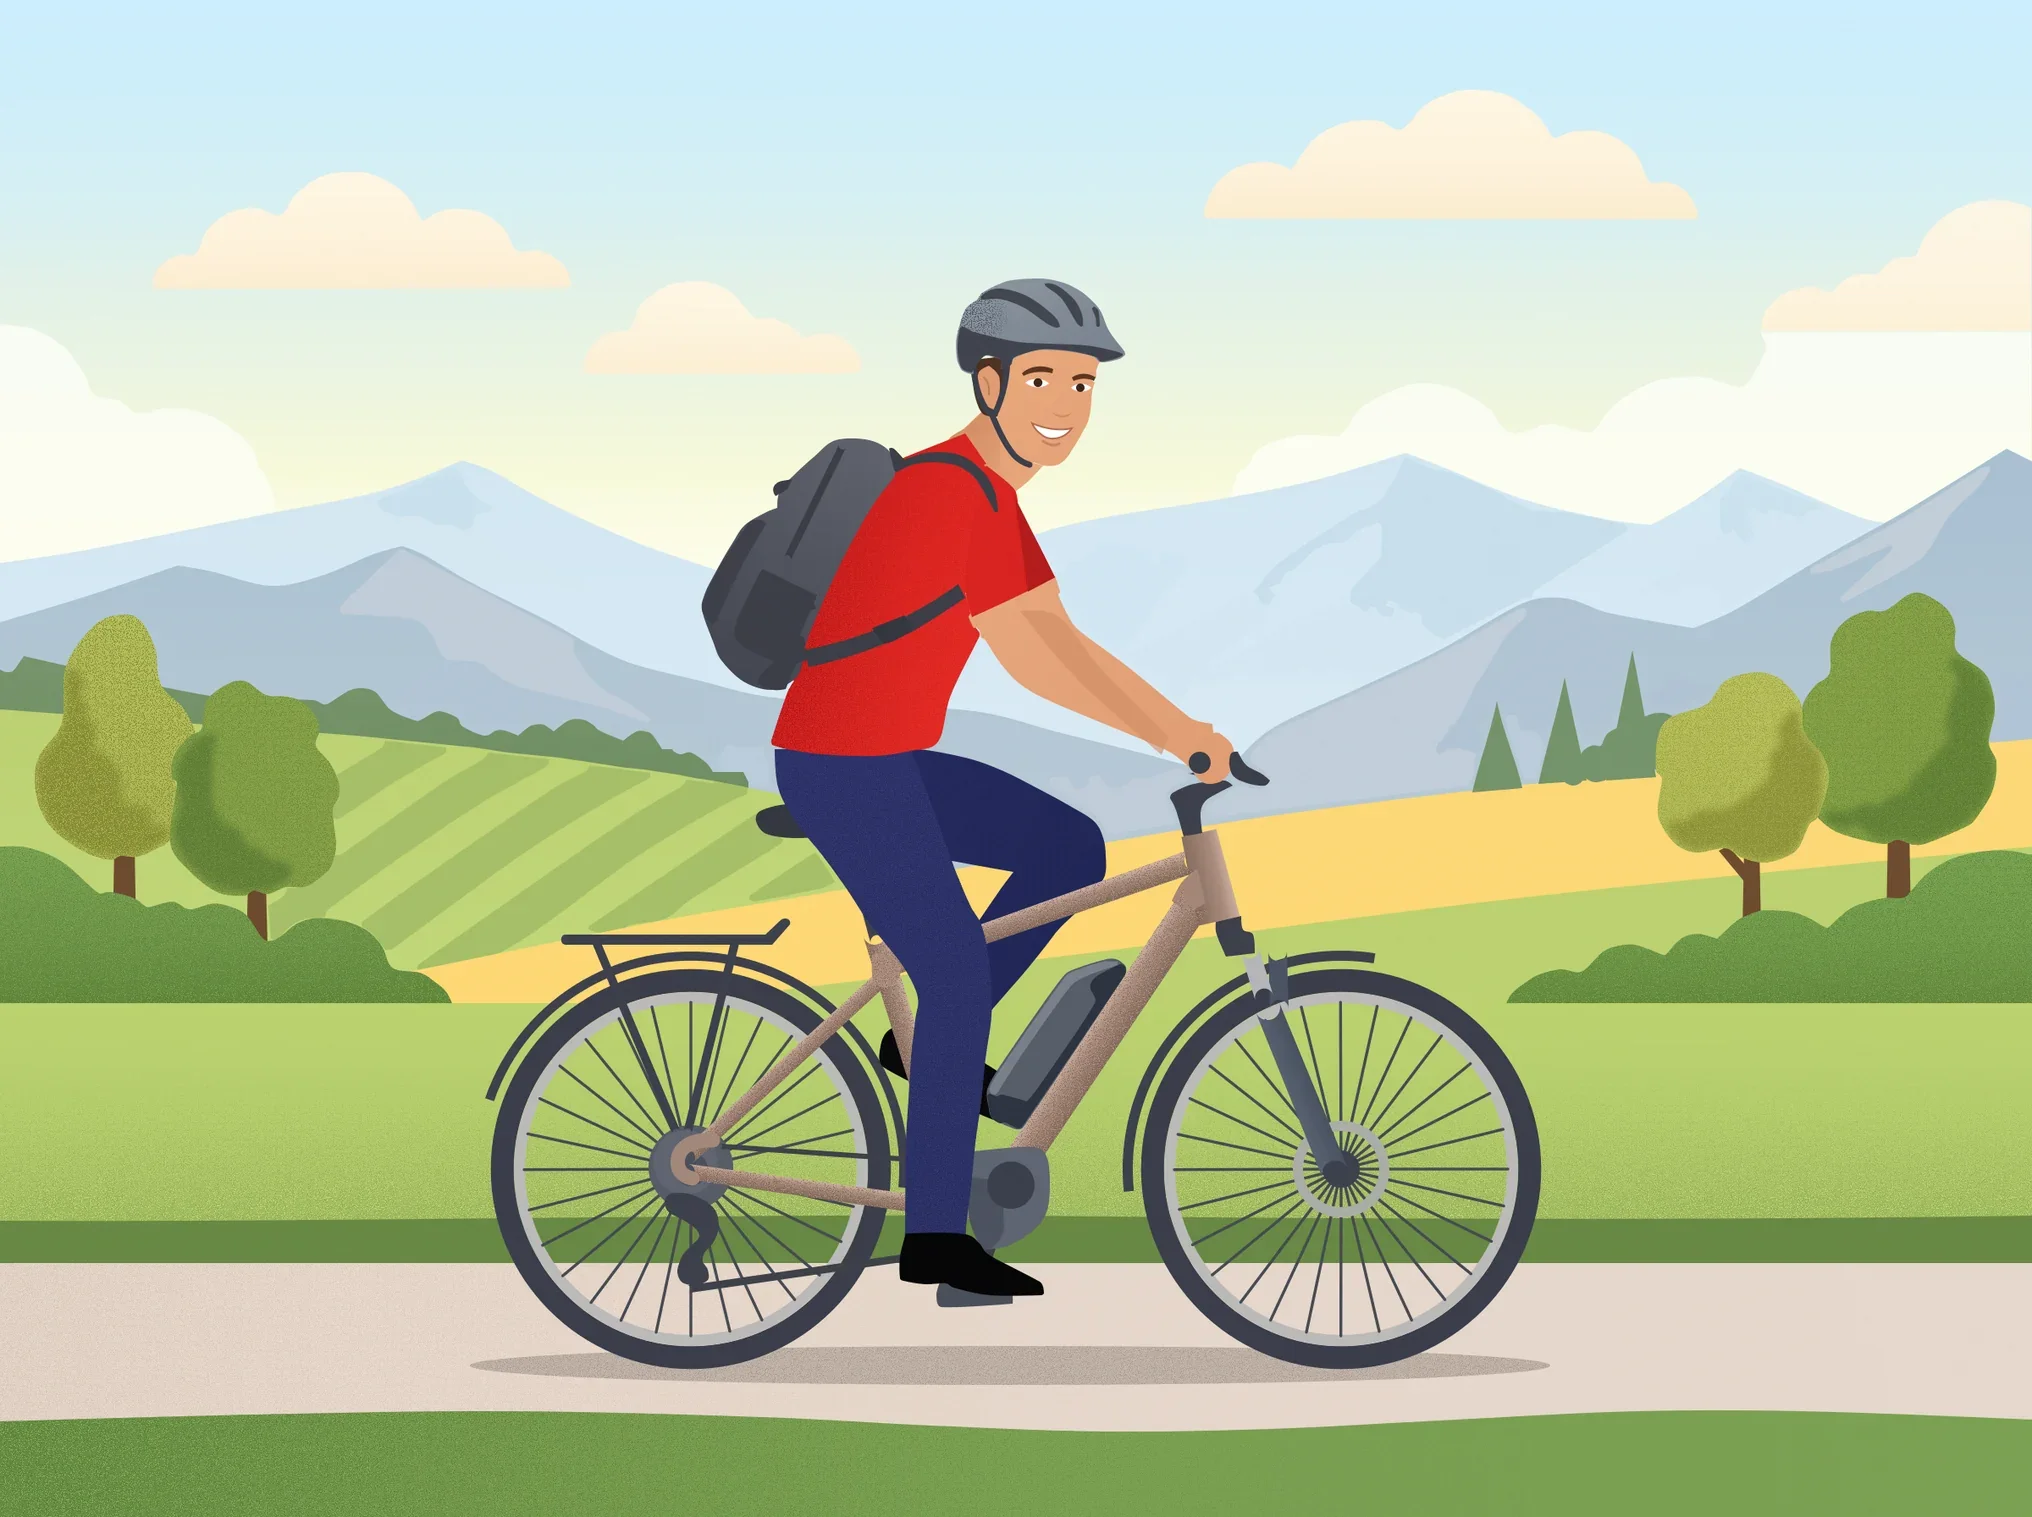
#3 Claude Opus 5.5 · high
71.7 Punteggio $26.2 80 min superata Agentico
-
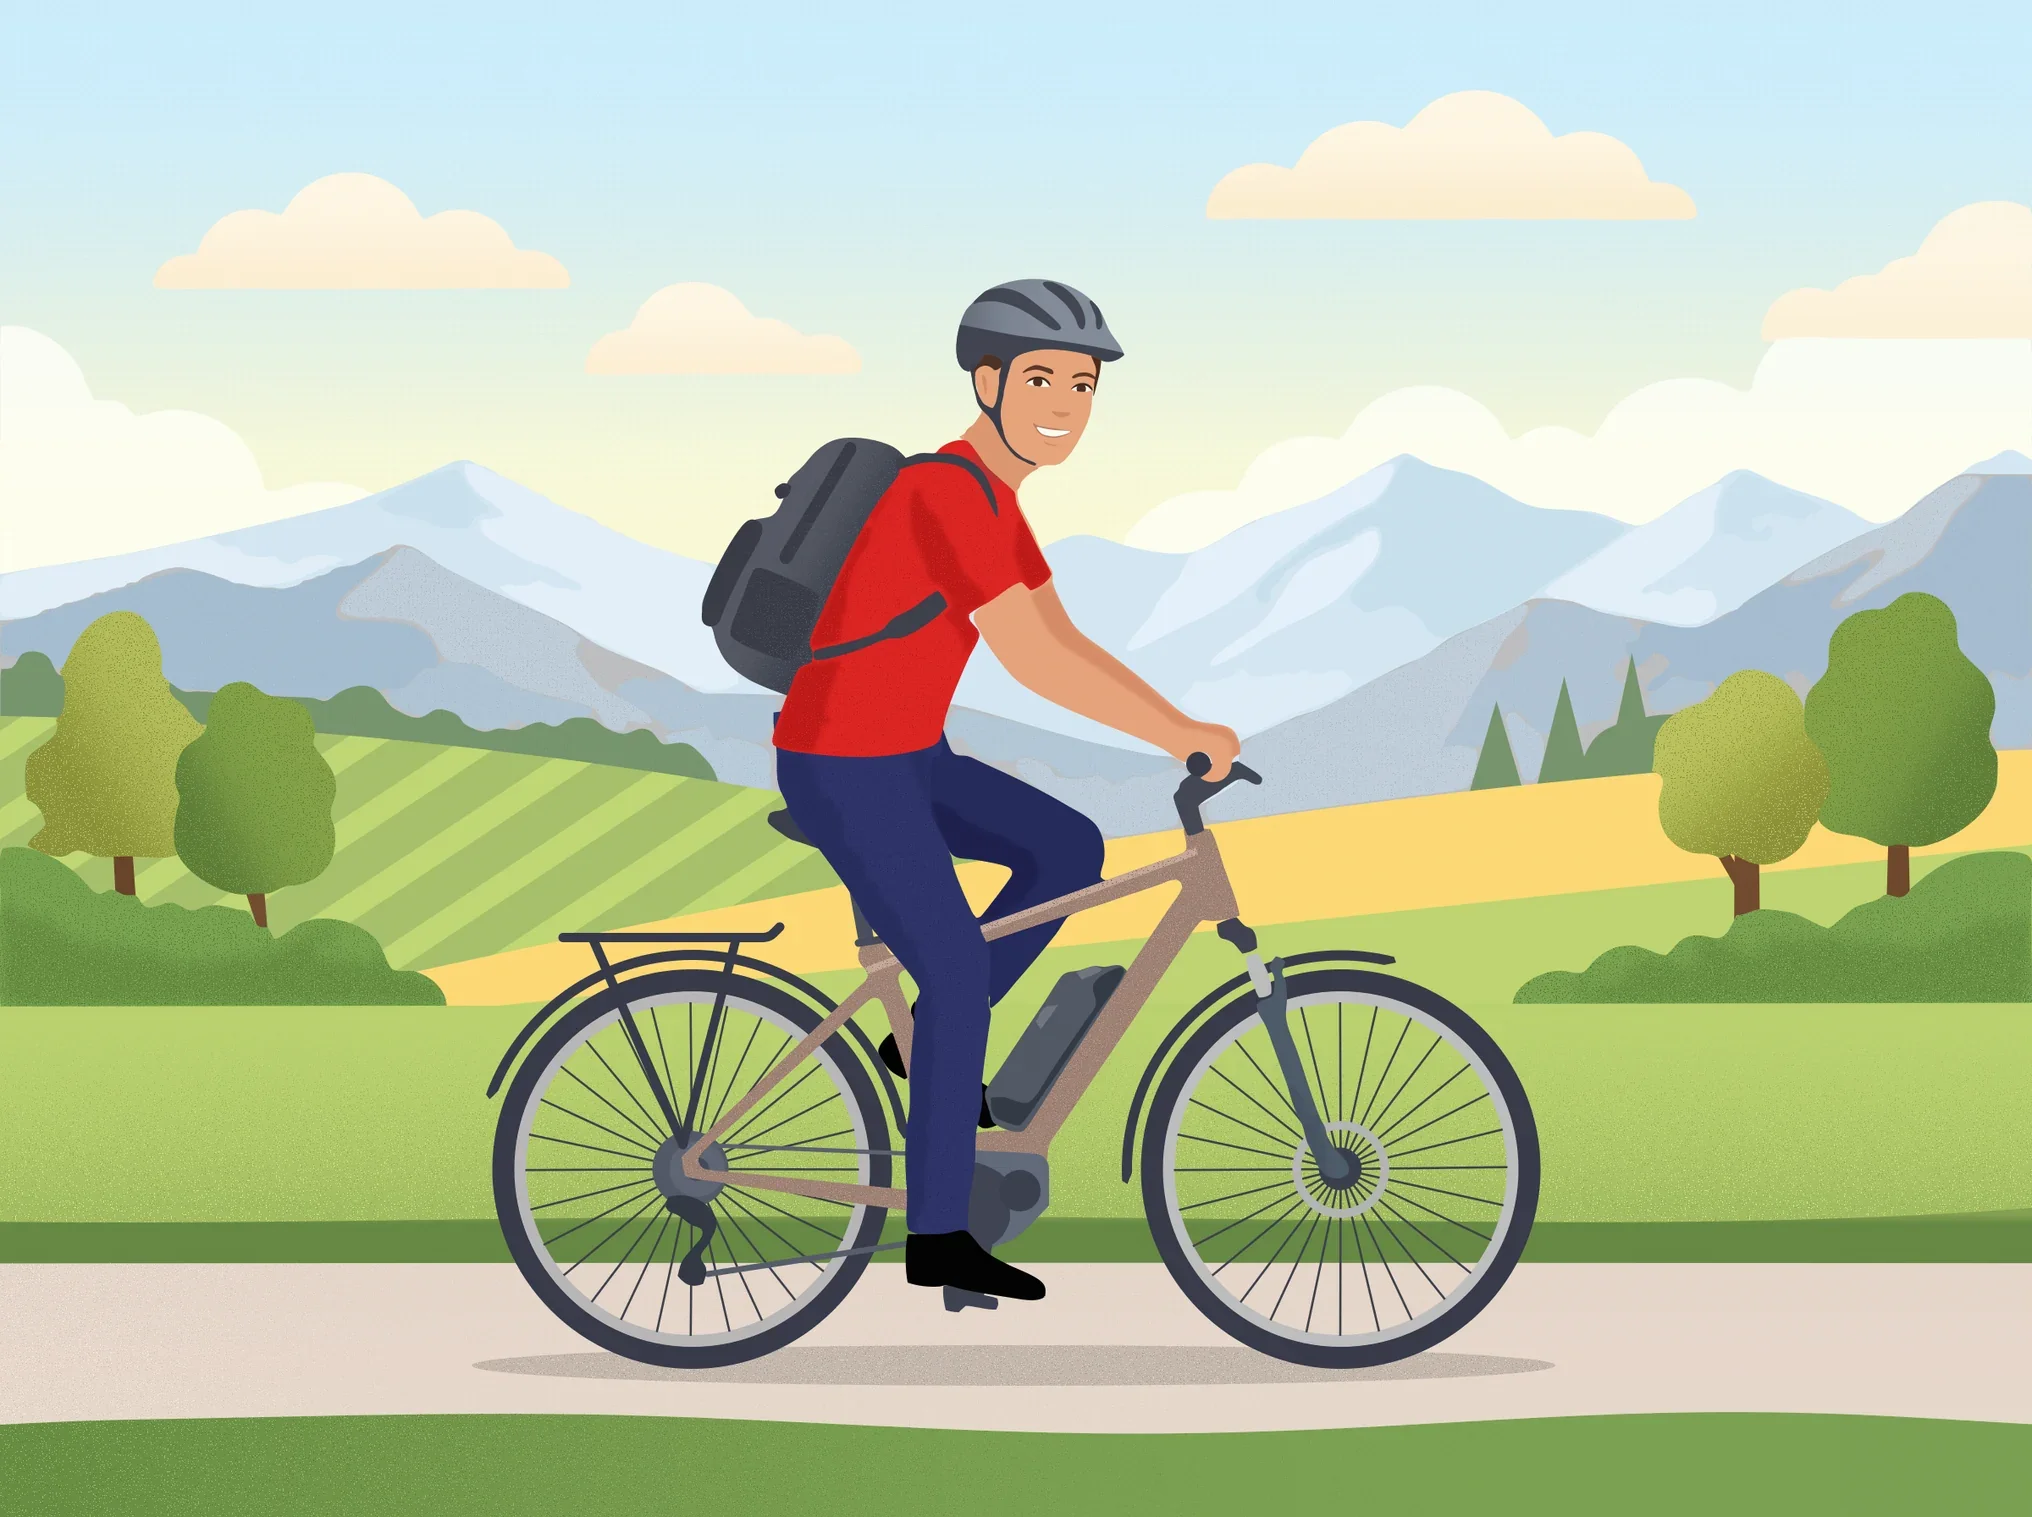
#4 Claude Opus 5.5 · xhigh
73.1 Punteggio $34.7 85 min superata Agentico
-
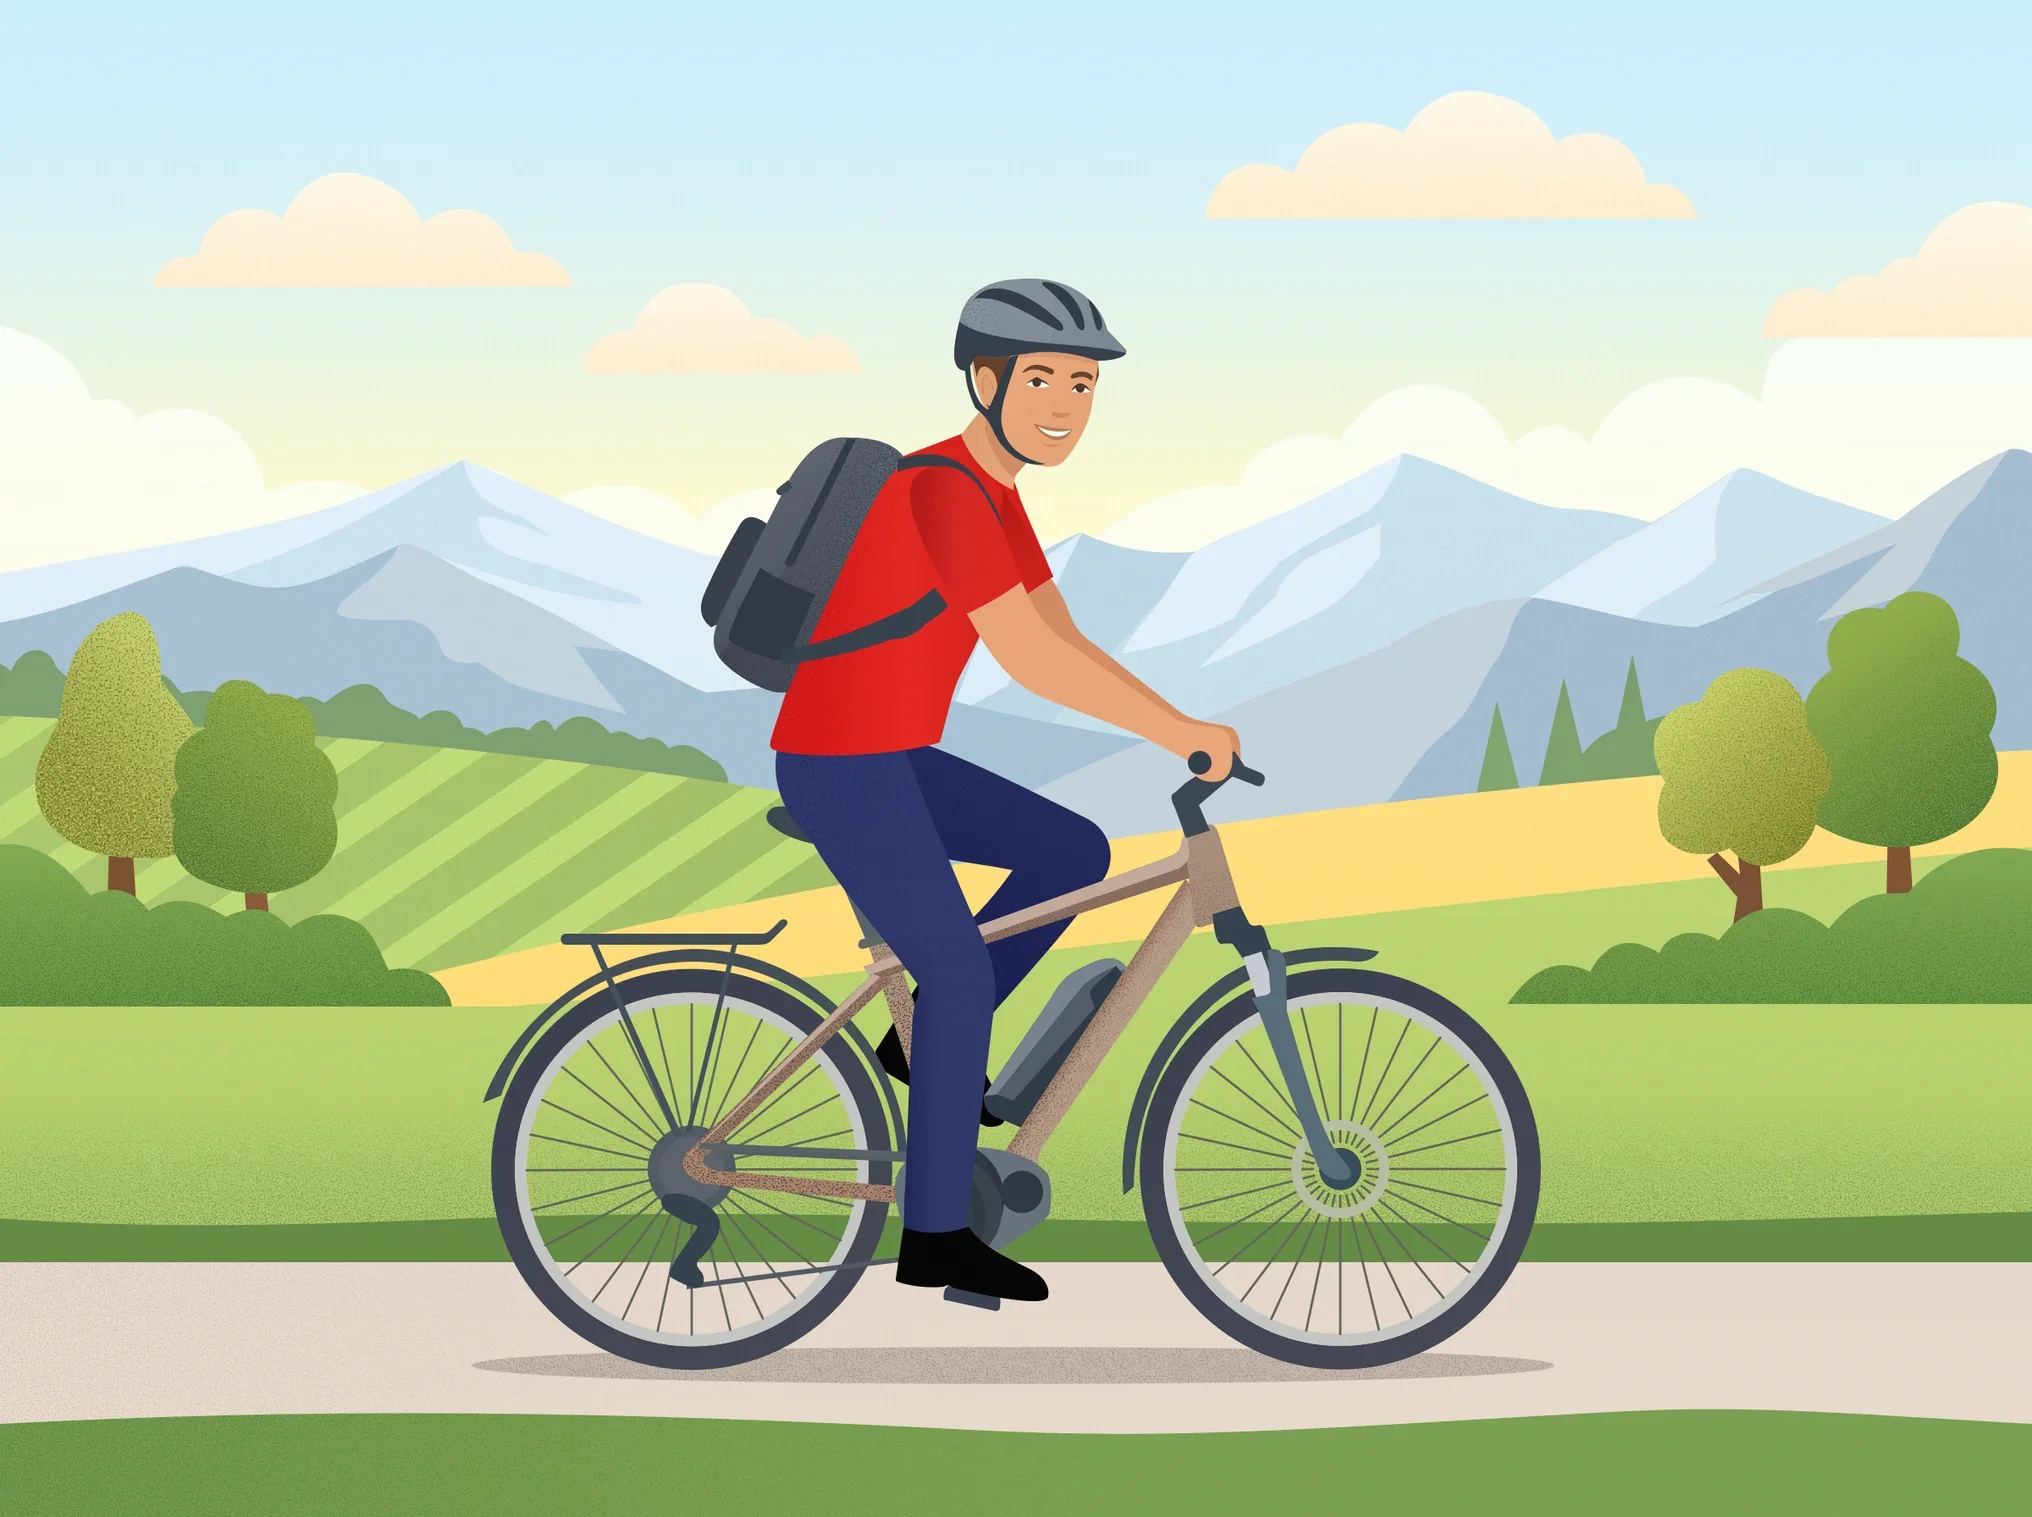
#5 GPT 6.1 Sol · xhigh
72.2 Punteggio $9.1 93 min superata Agentico
-
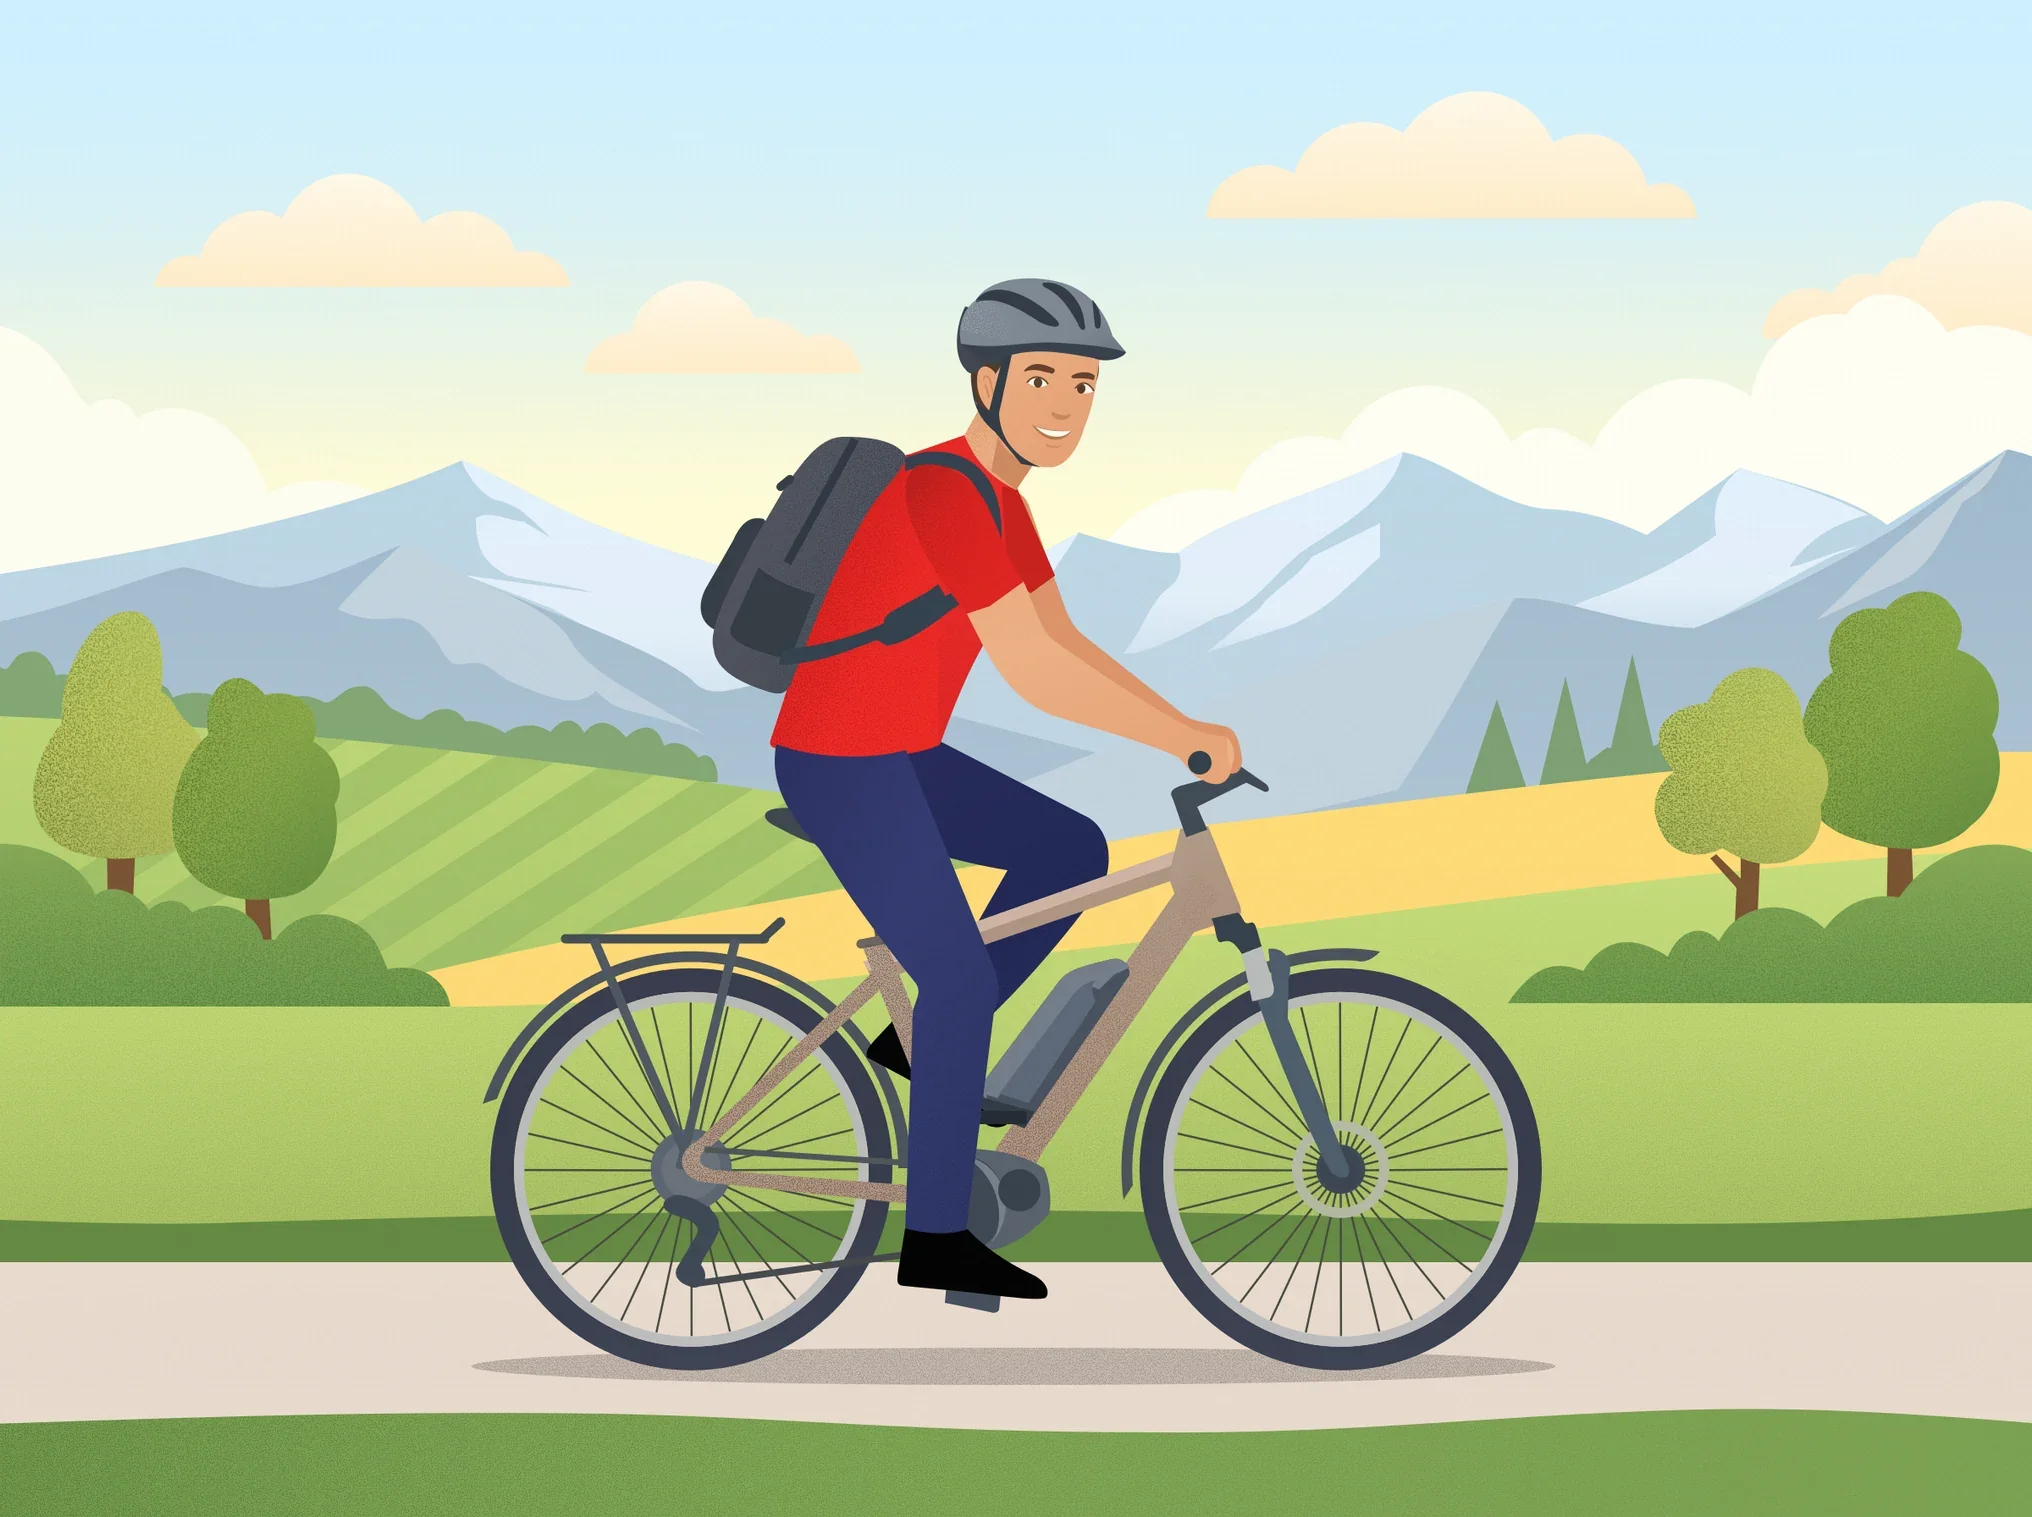
#6 GPT 6.1 Sol · high
72.1 Punteggio $6.4 65 min non superata Agentico
-
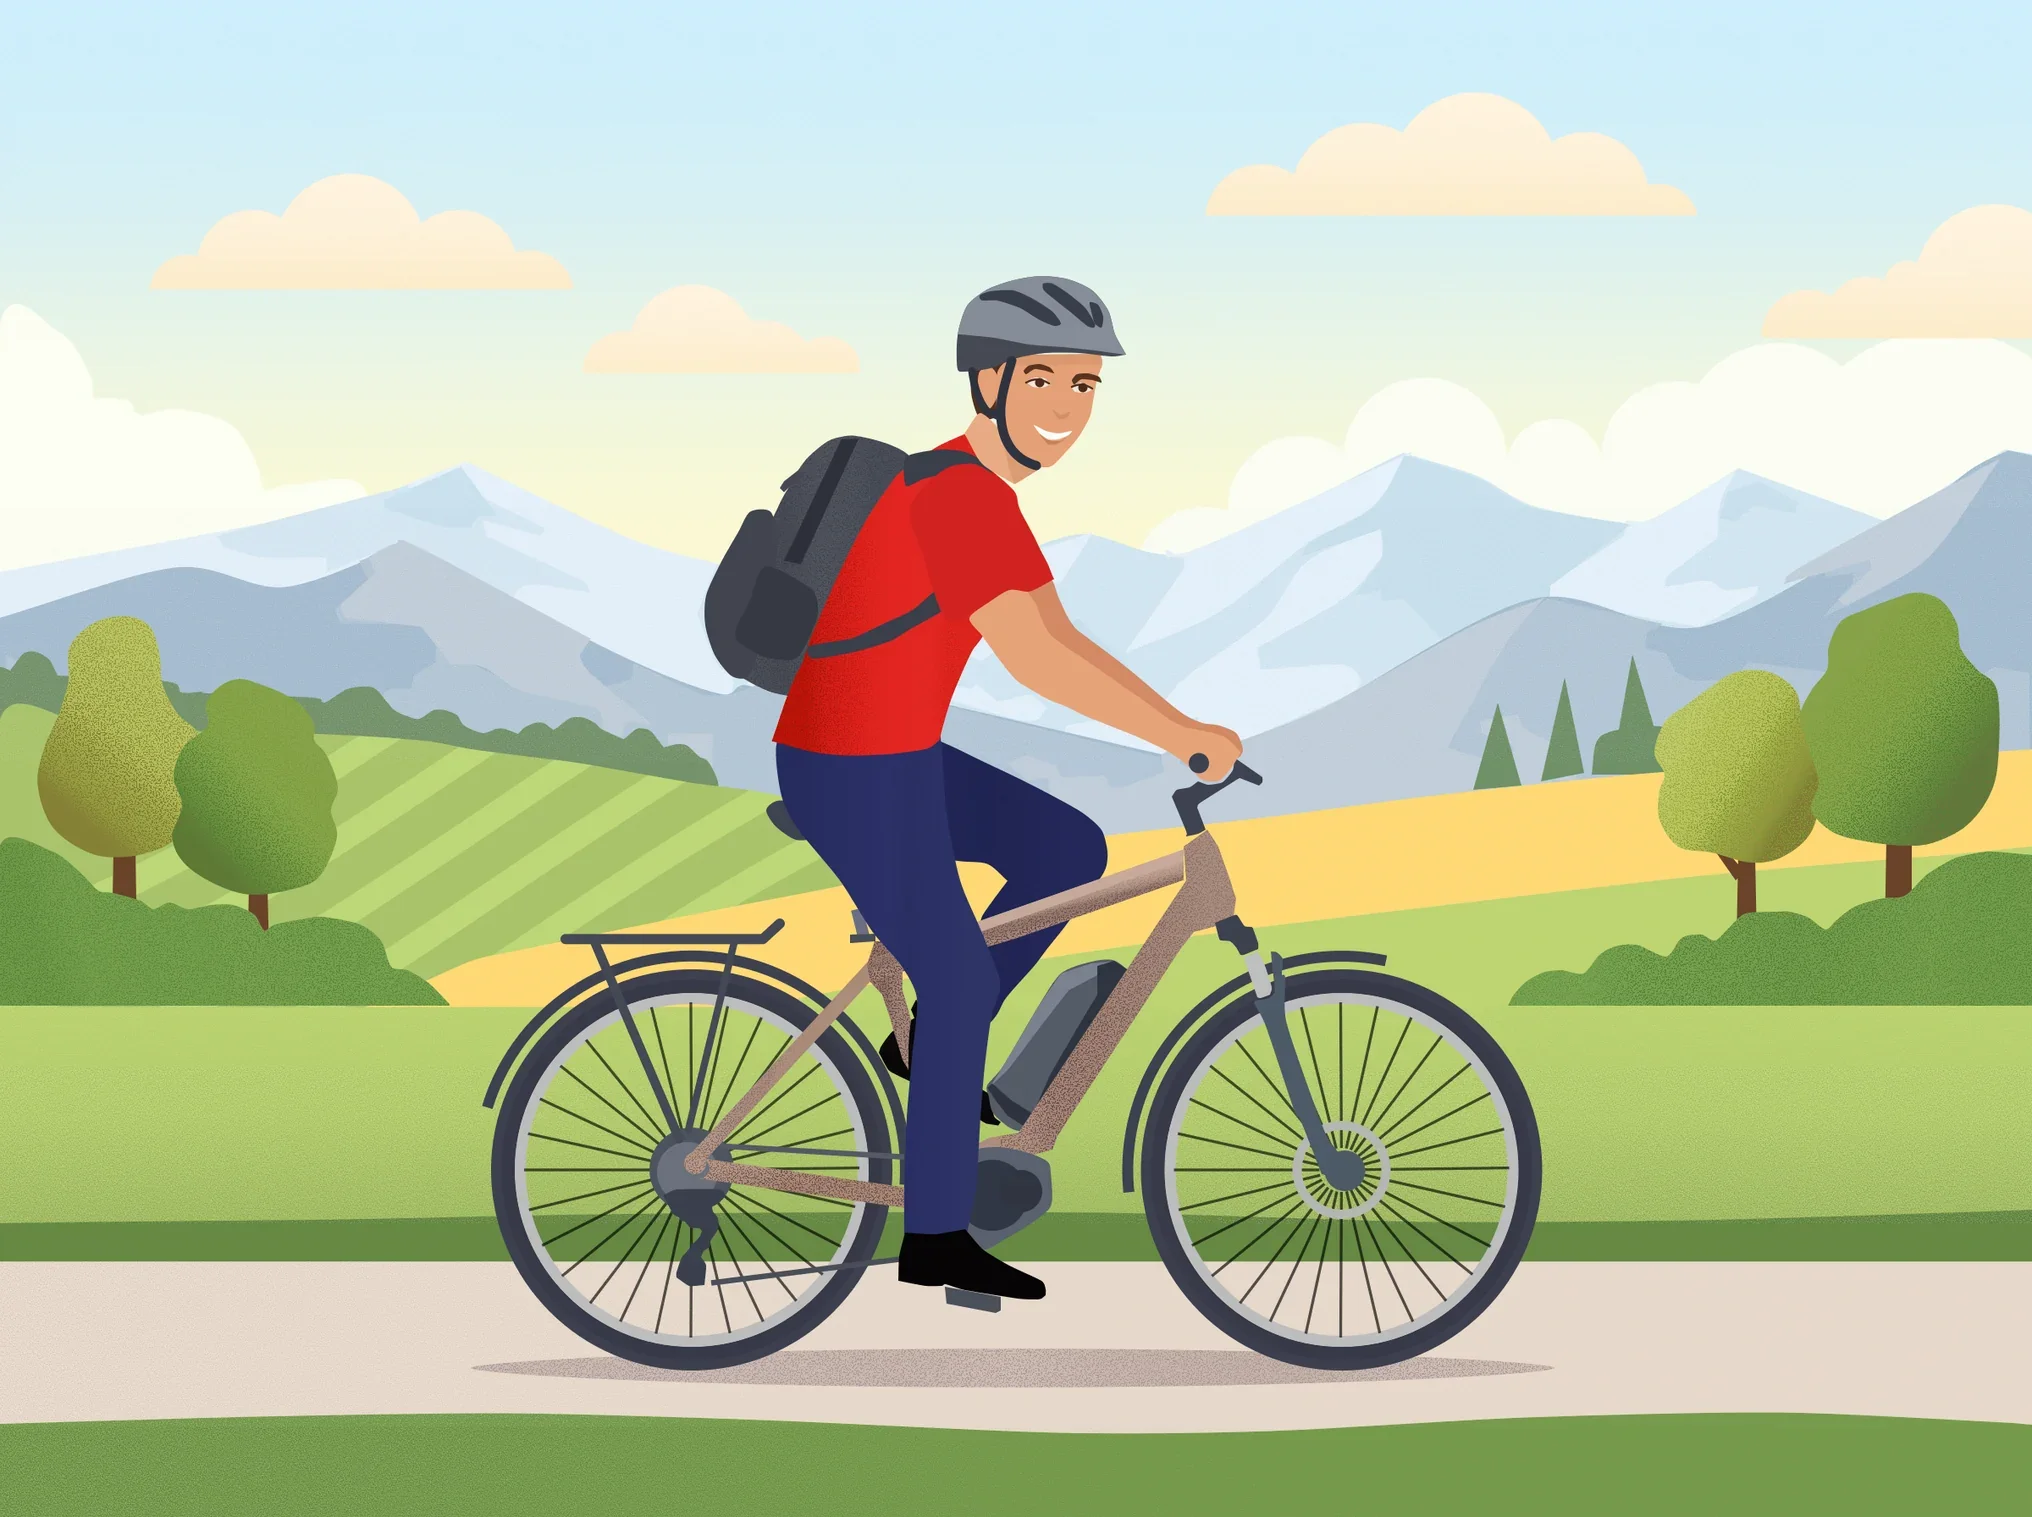
#7 Claude Sonnet 5.5 · high
70.2 Punteggio $20.1 75 min superata Agentico
-
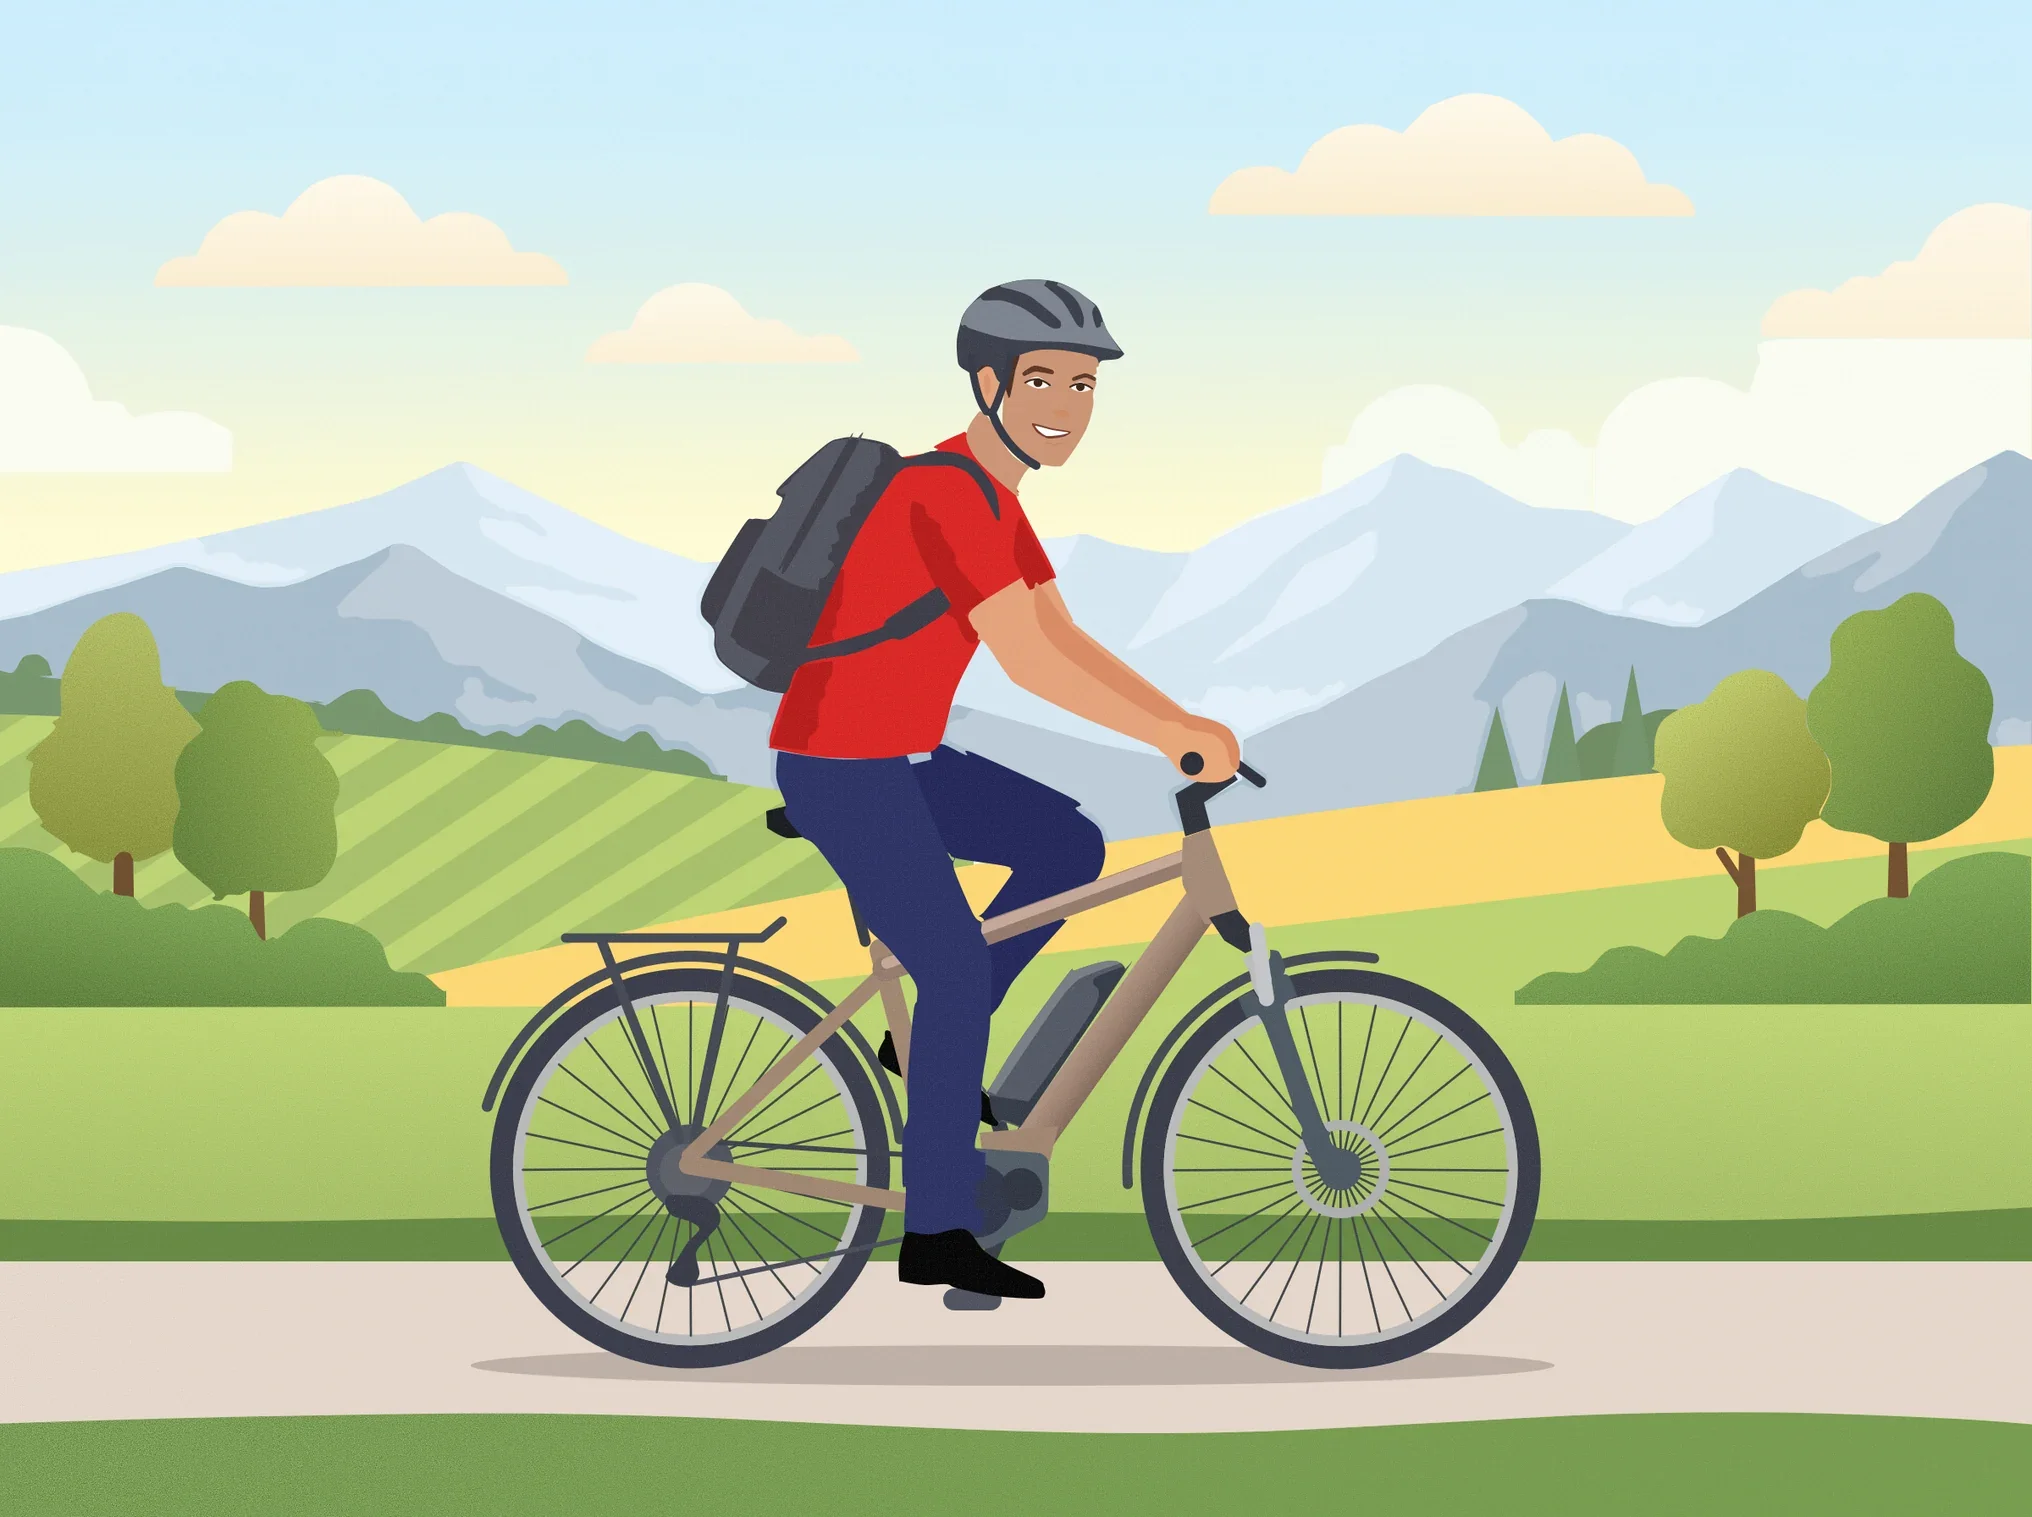
#8 Claude Opus 5.5 · medium
67.4 Punteggio $16.4 91 min superata Agentico
-
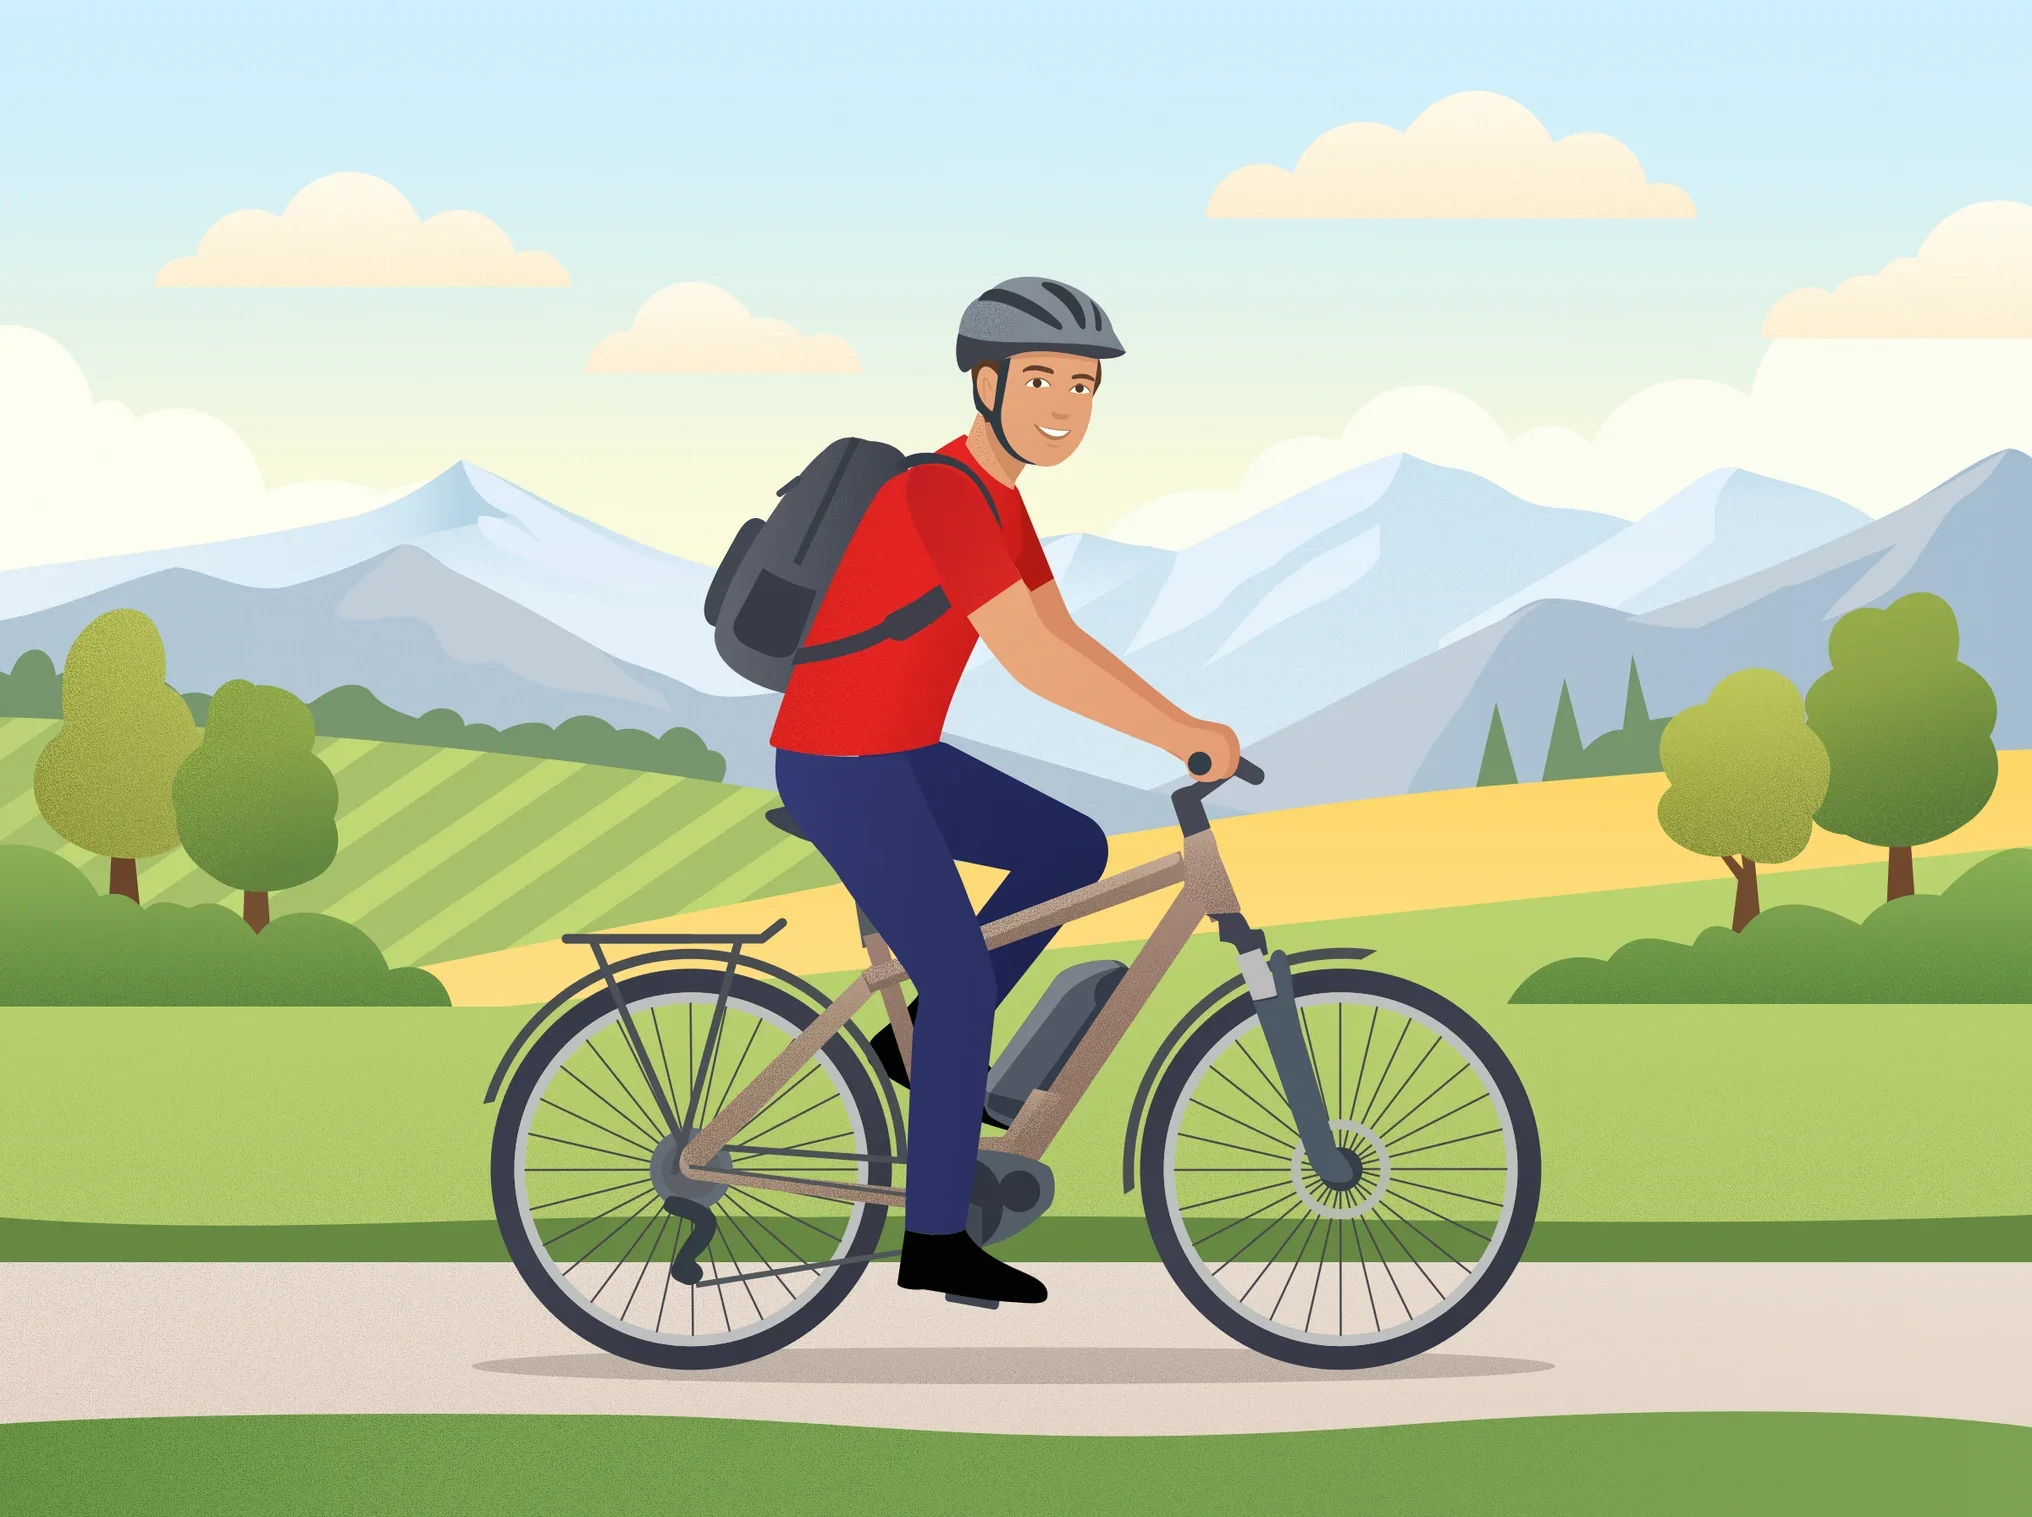
#9 GPT 6.1 Sol · medium
72.2 Punteggio $8.2 86 min superata Agentico
-
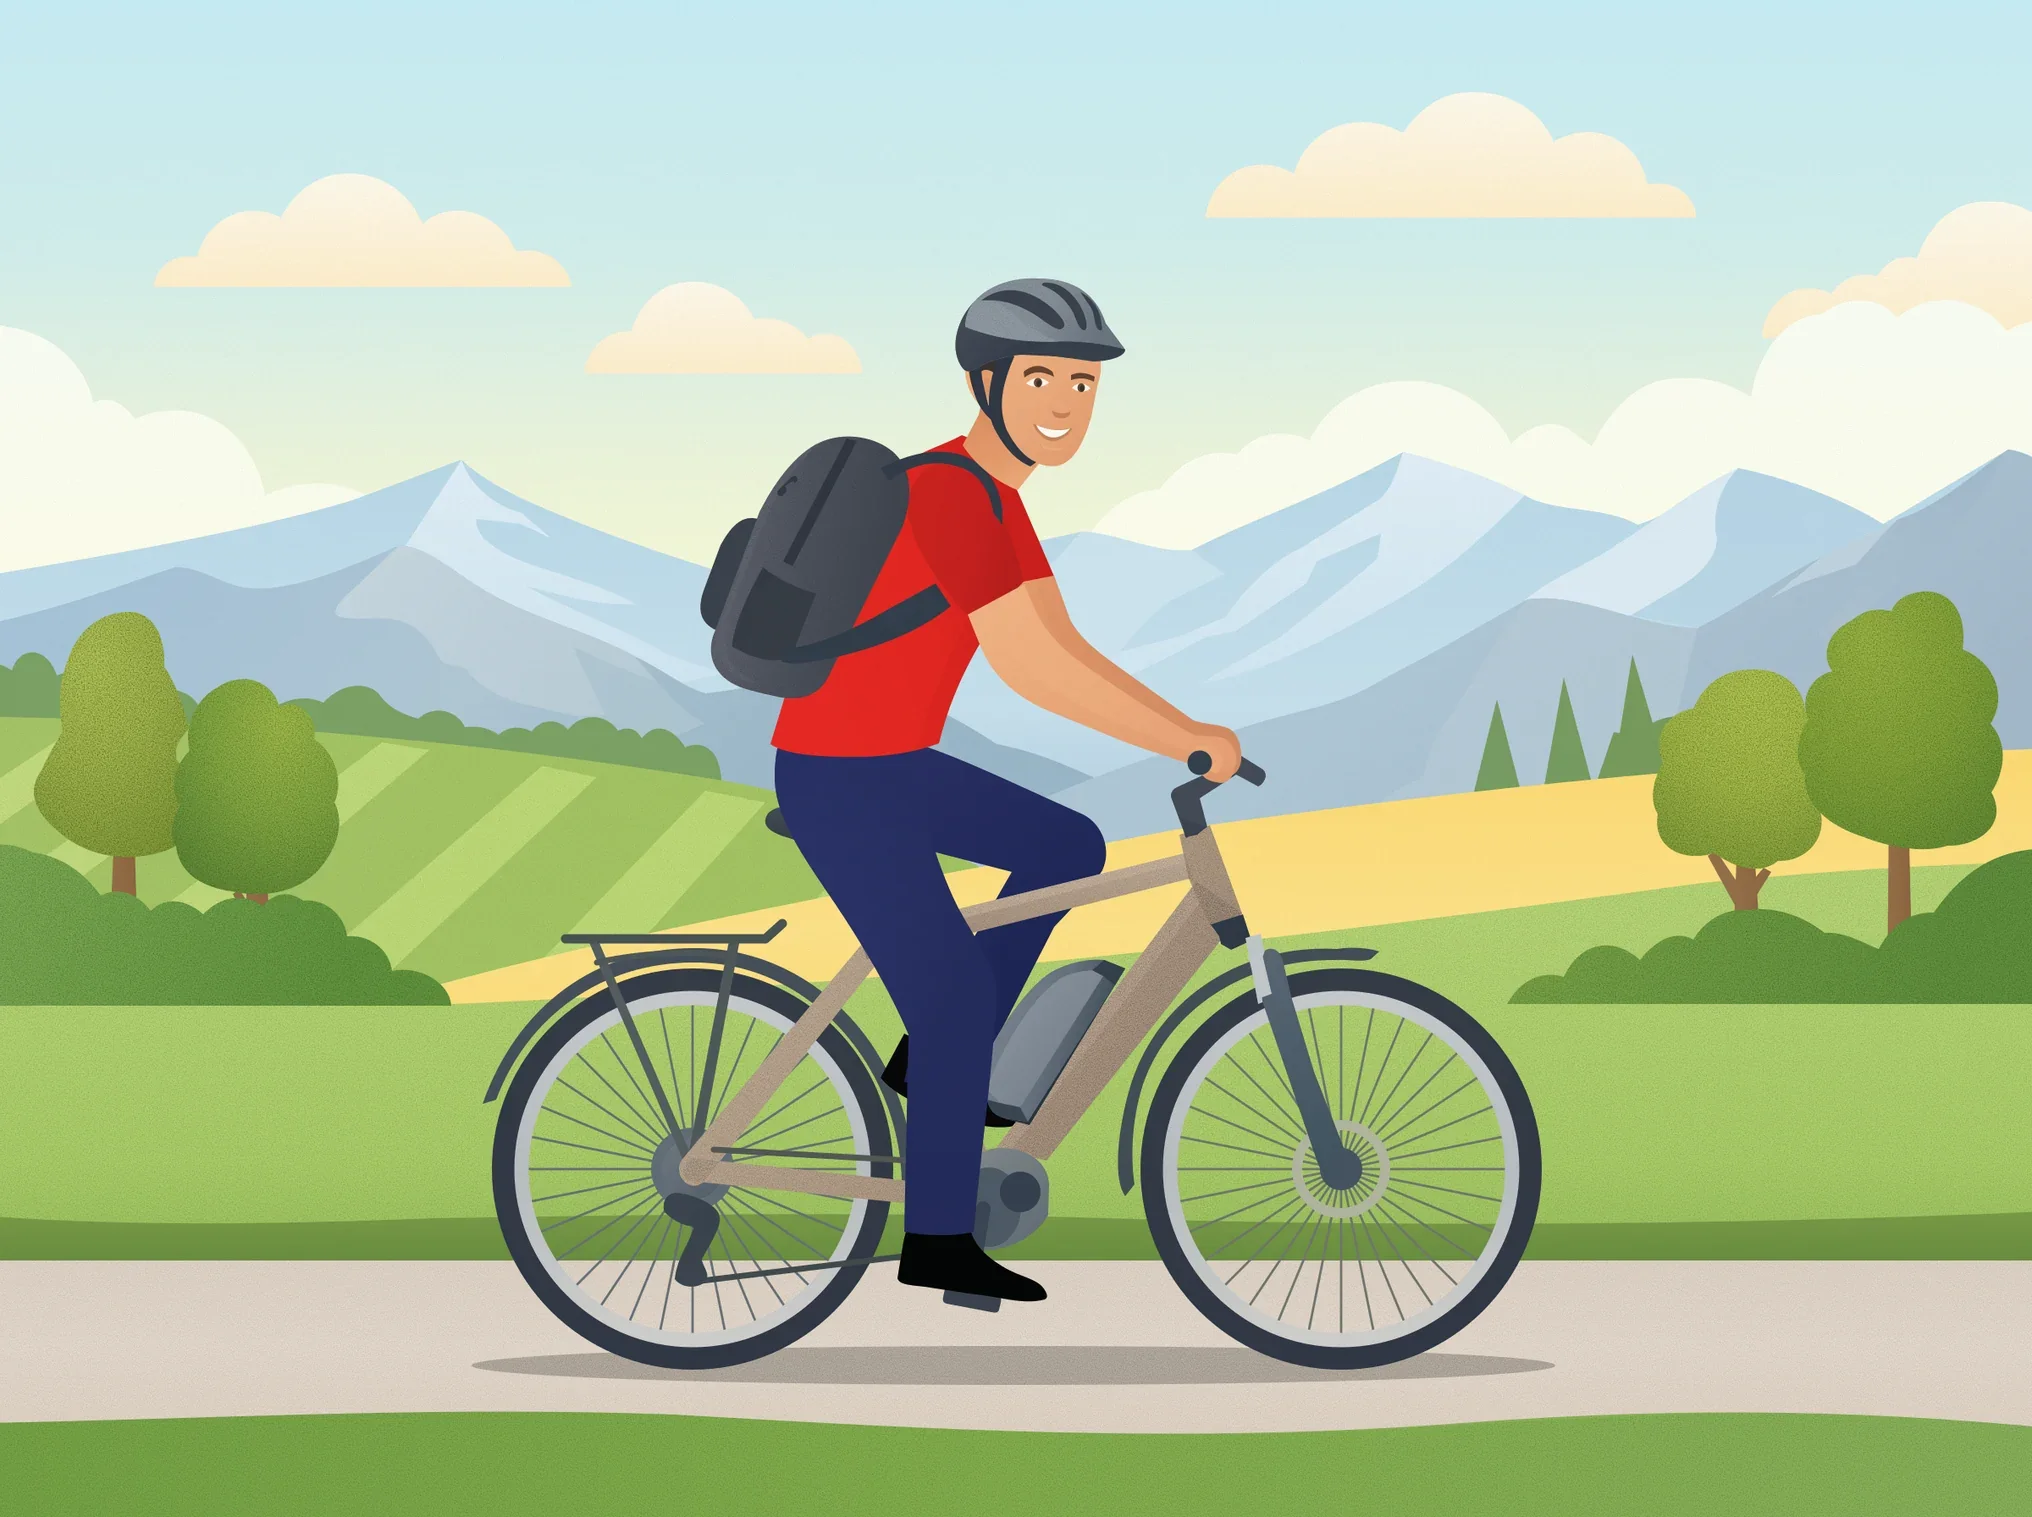
#10 GPT 6.1 Sol · xhigh
48.0 Punteggio $0.38 15 min non superata Single-shot
-
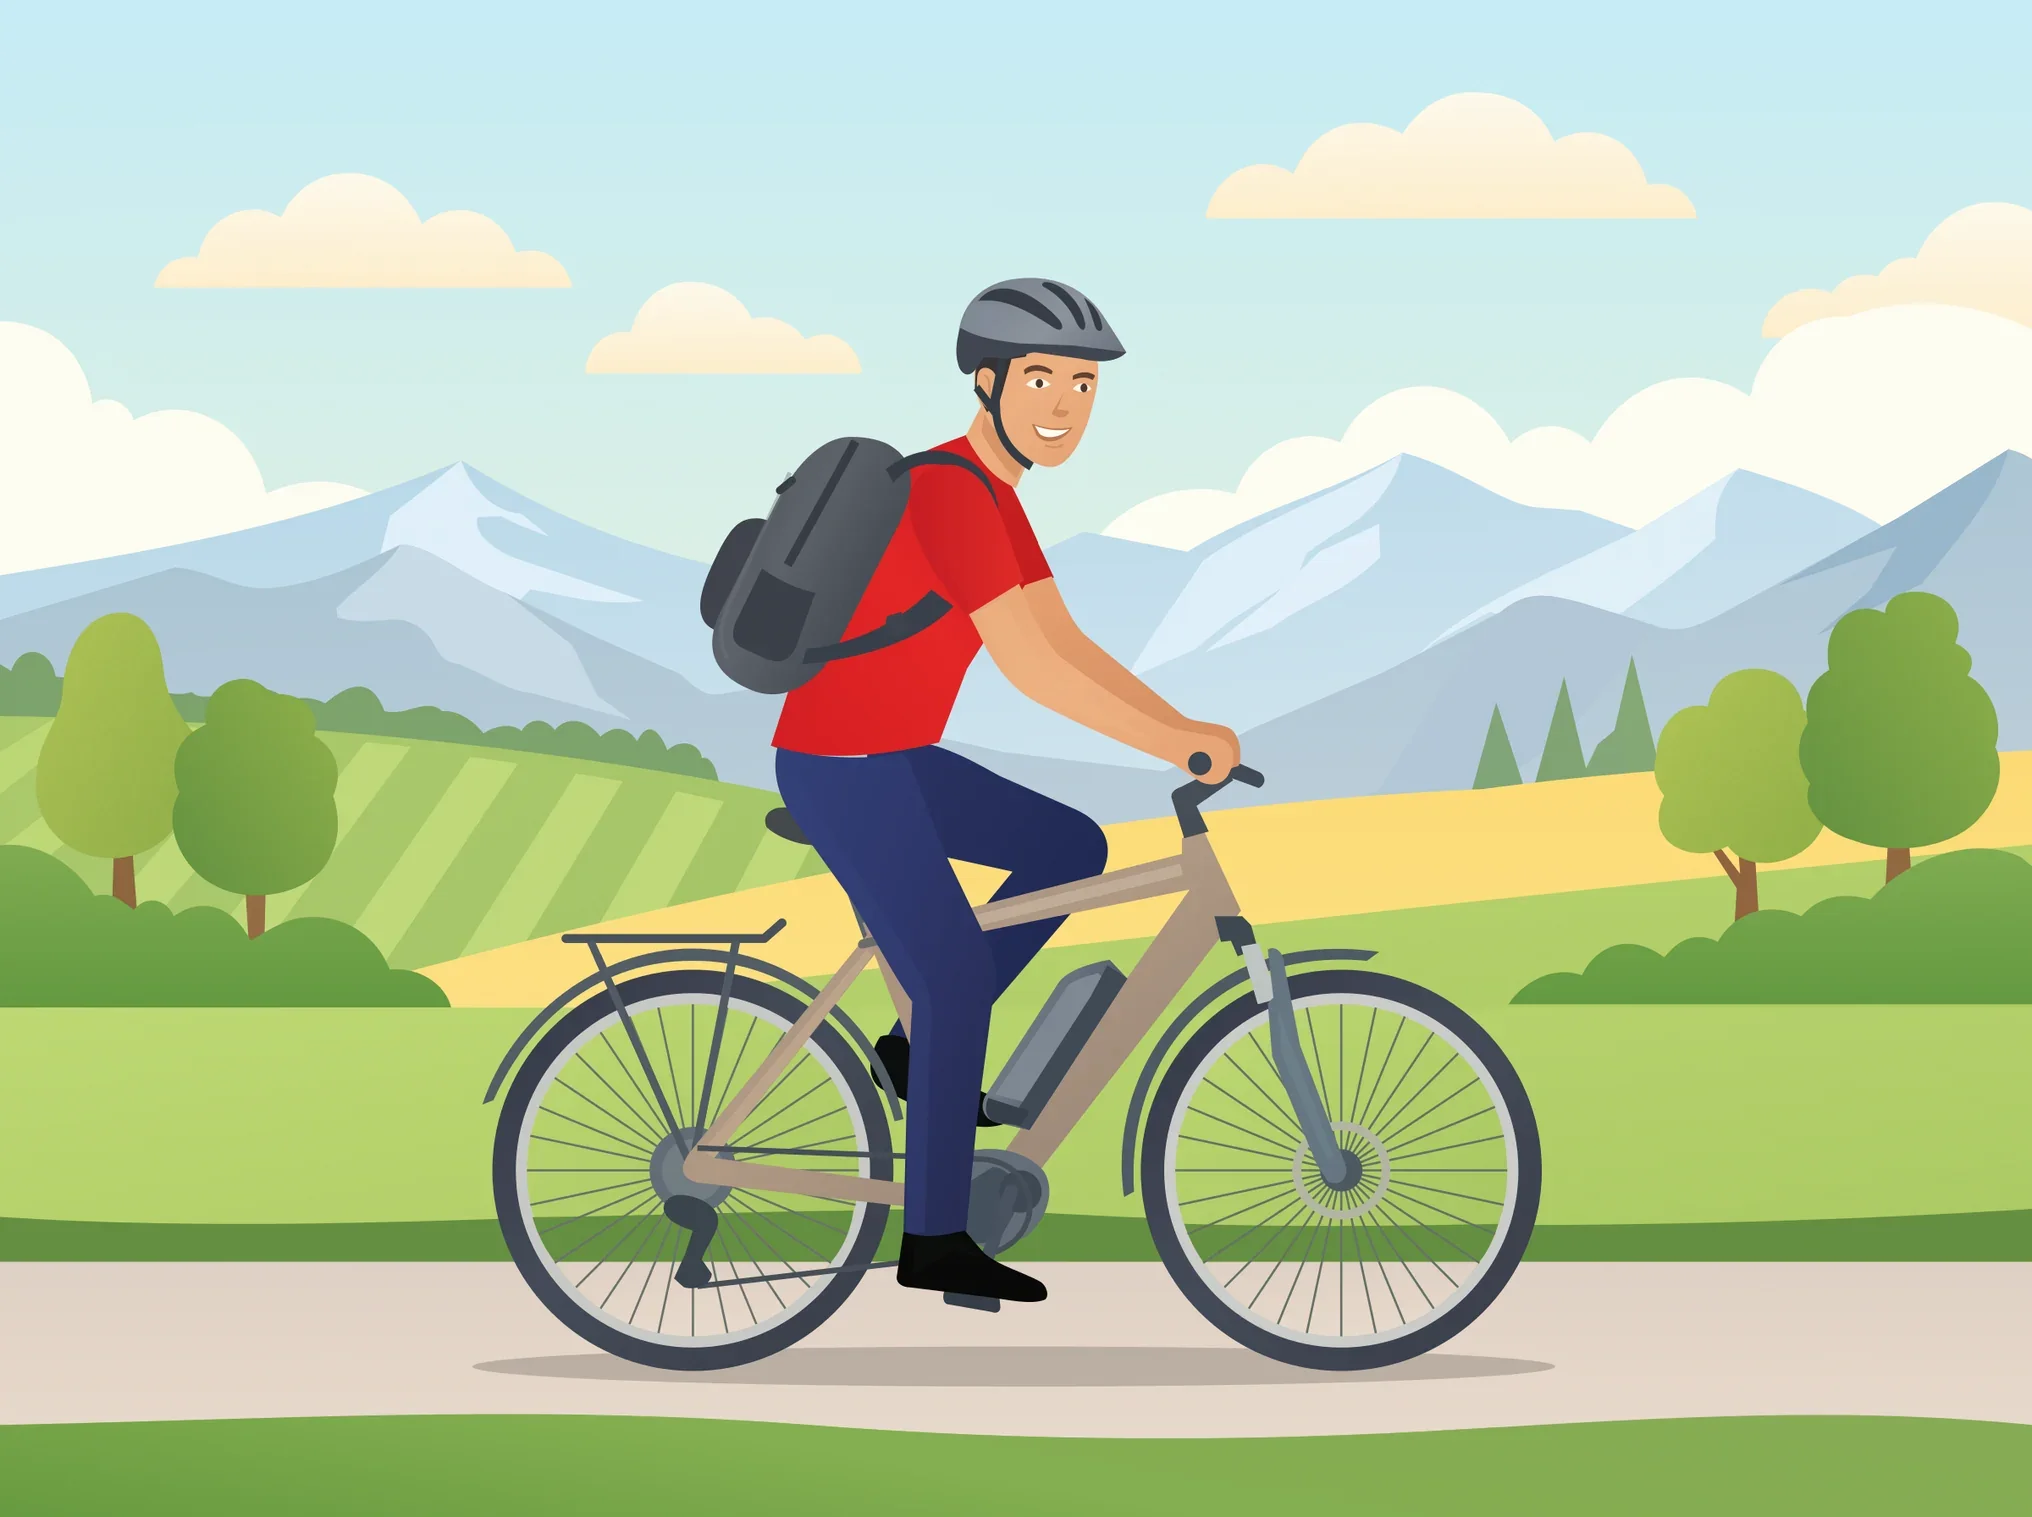
#11 GPT 6.1 Sol · medium
45.5 Punteggio $0.21 6.9 min non superata Single-shot
-
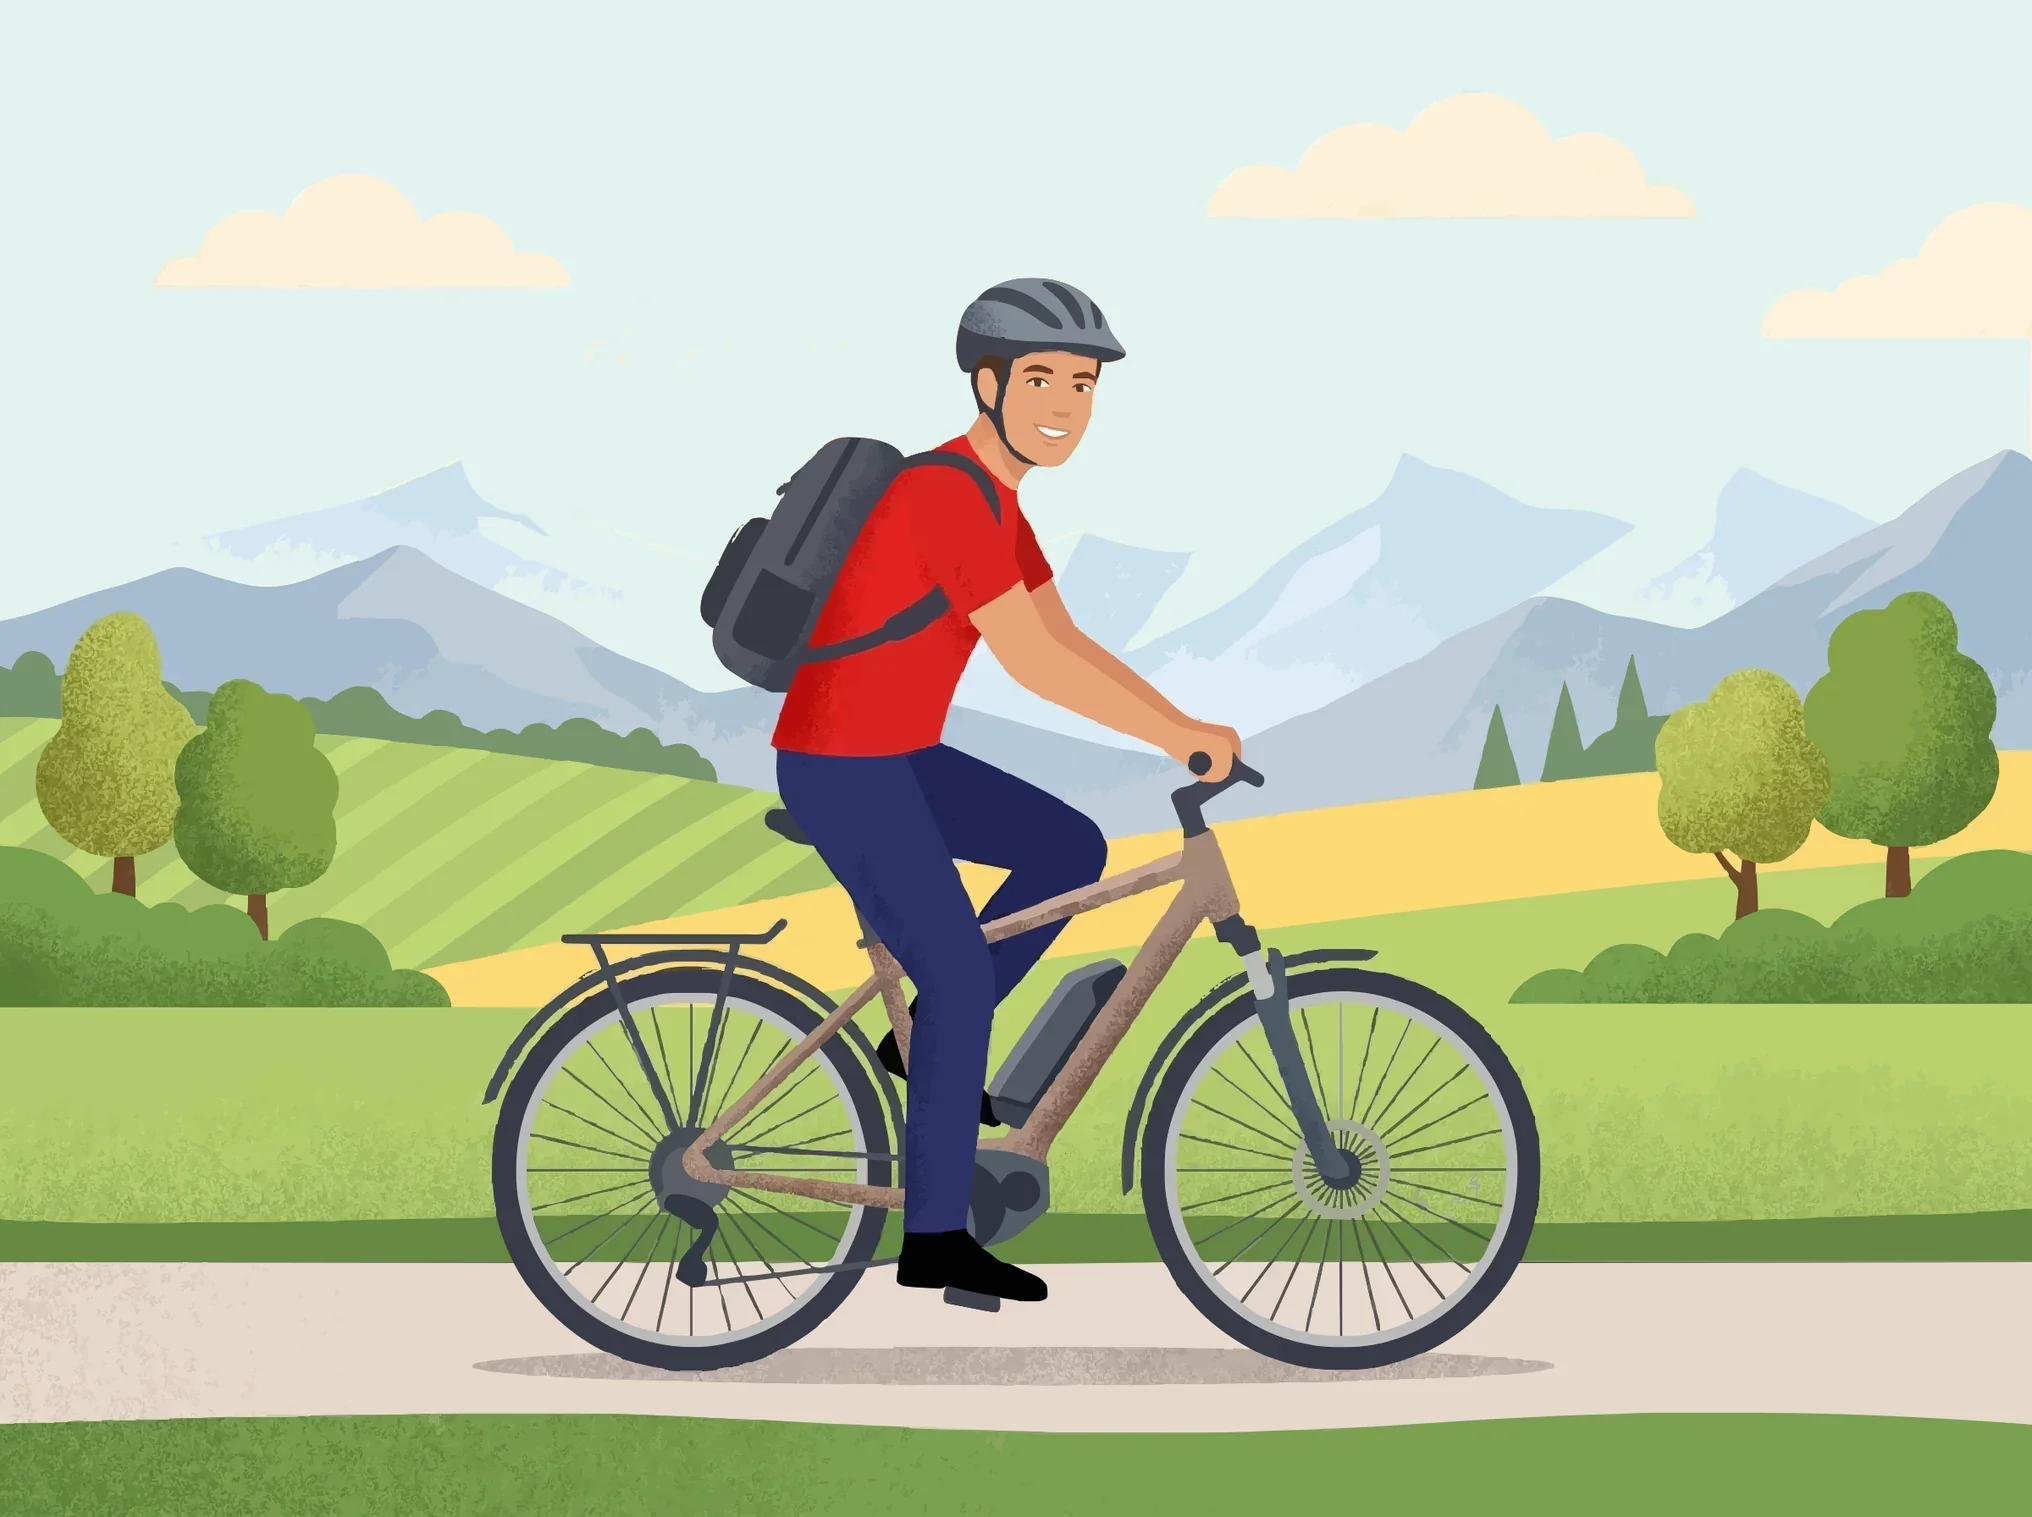
#12 vtracer 0.6.15, default settings
36.5 Punteggio $0.00 0.1 min non superata Strumento
-
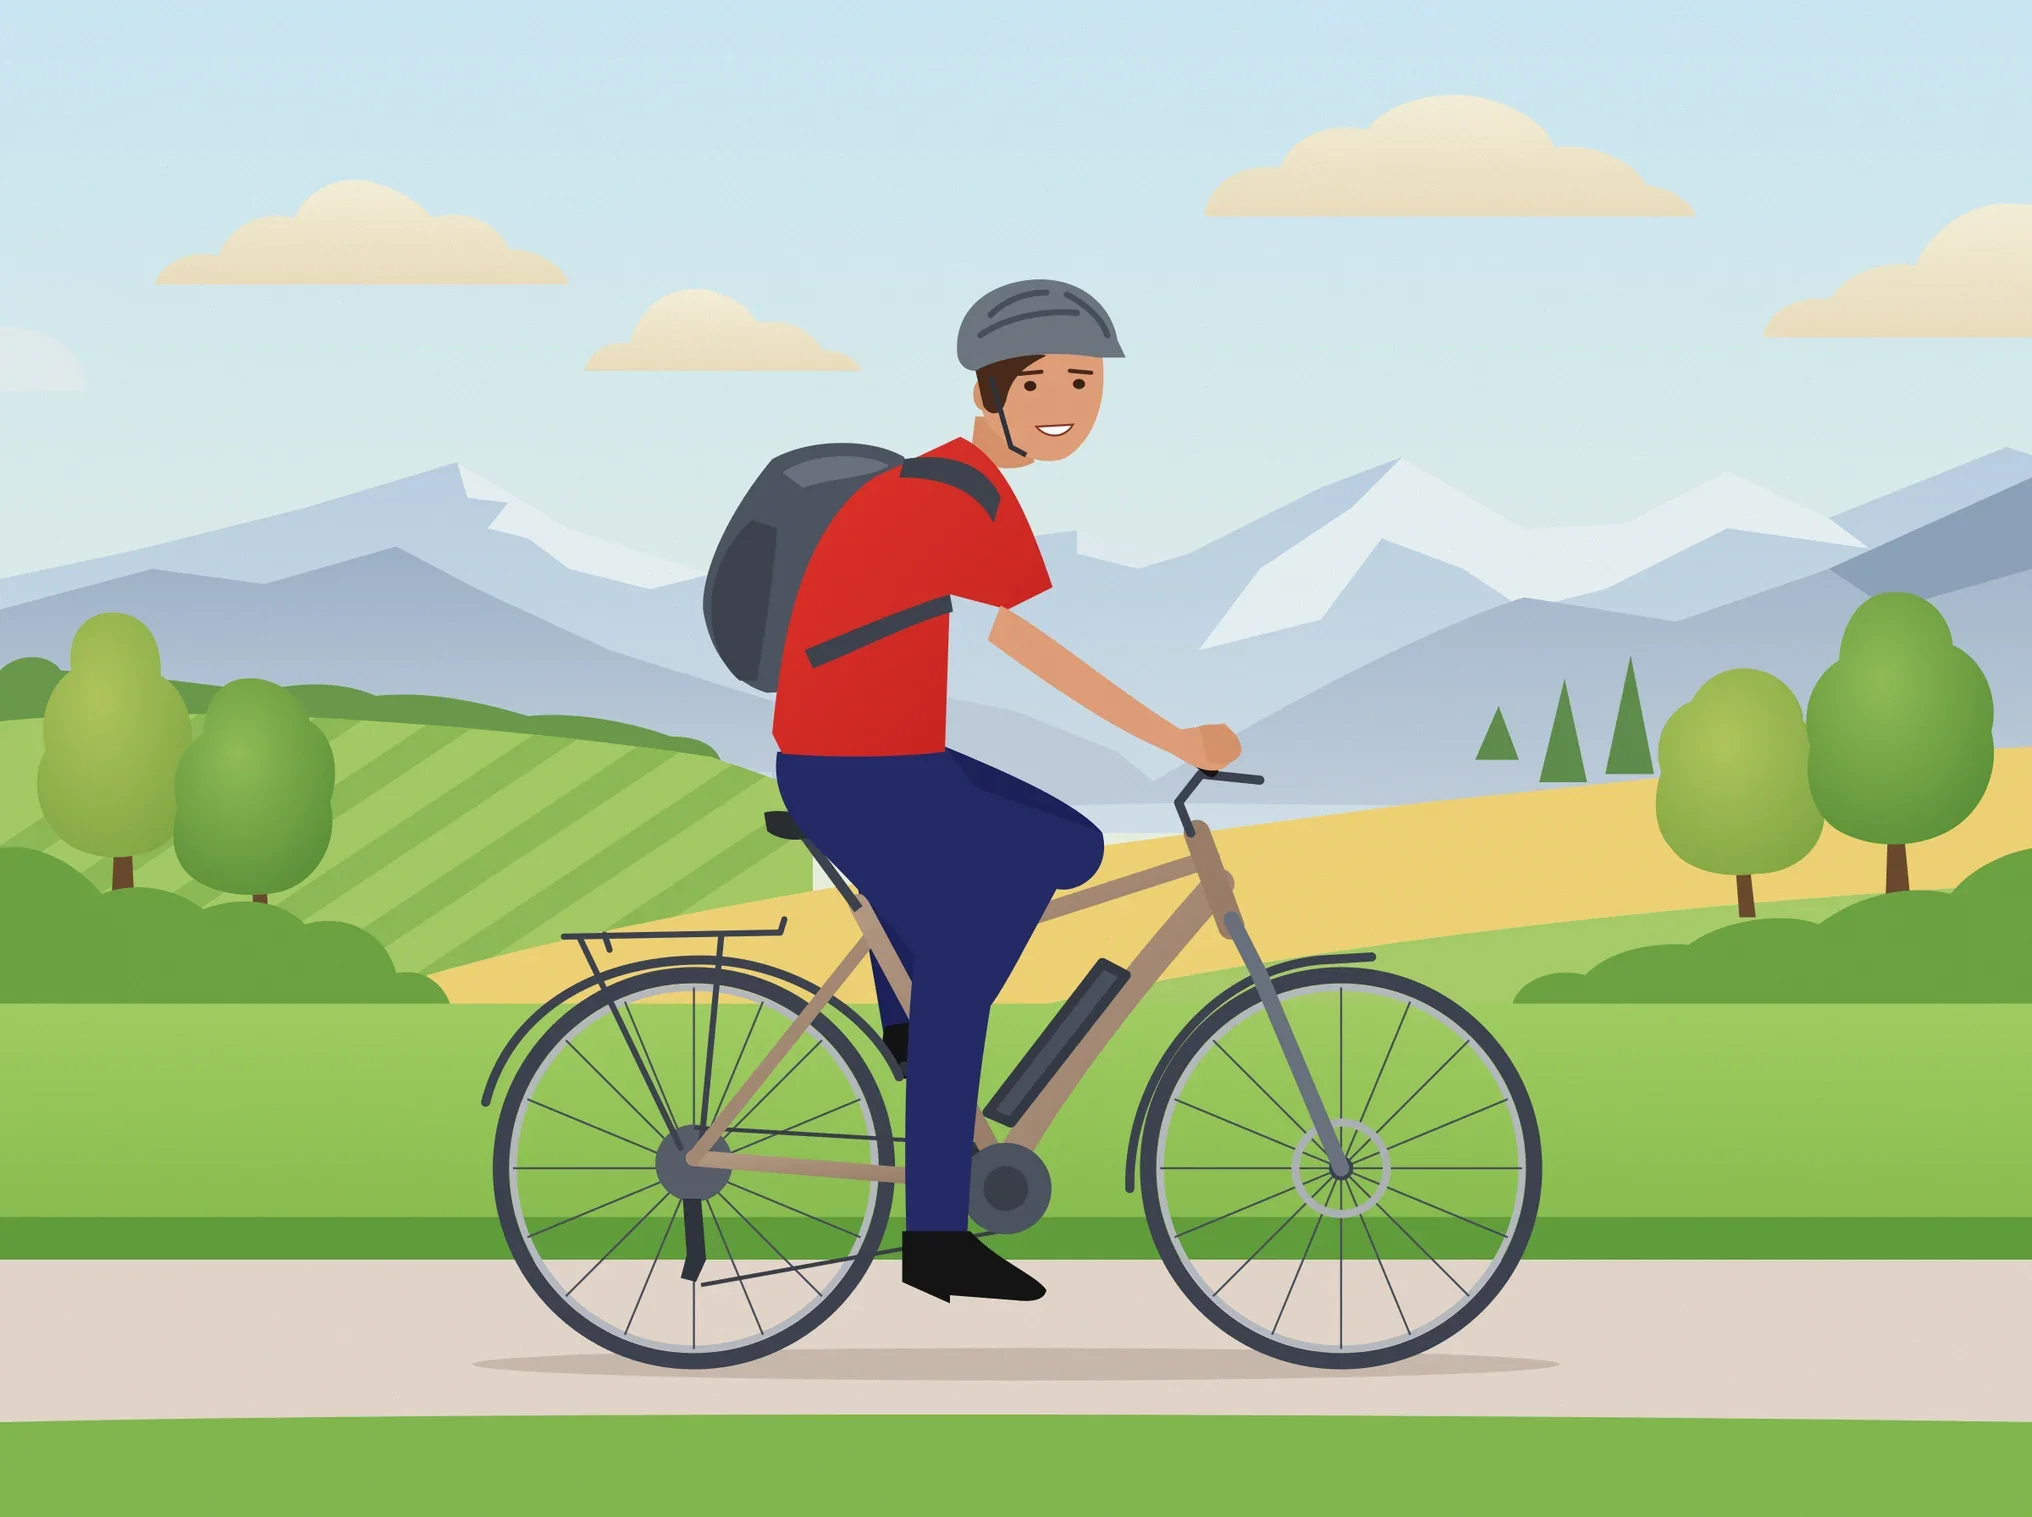
#13 Claude Opus 5.5 · medium
40.0 Punteggio $2.1 14 min non superata Ciclo fisso
-
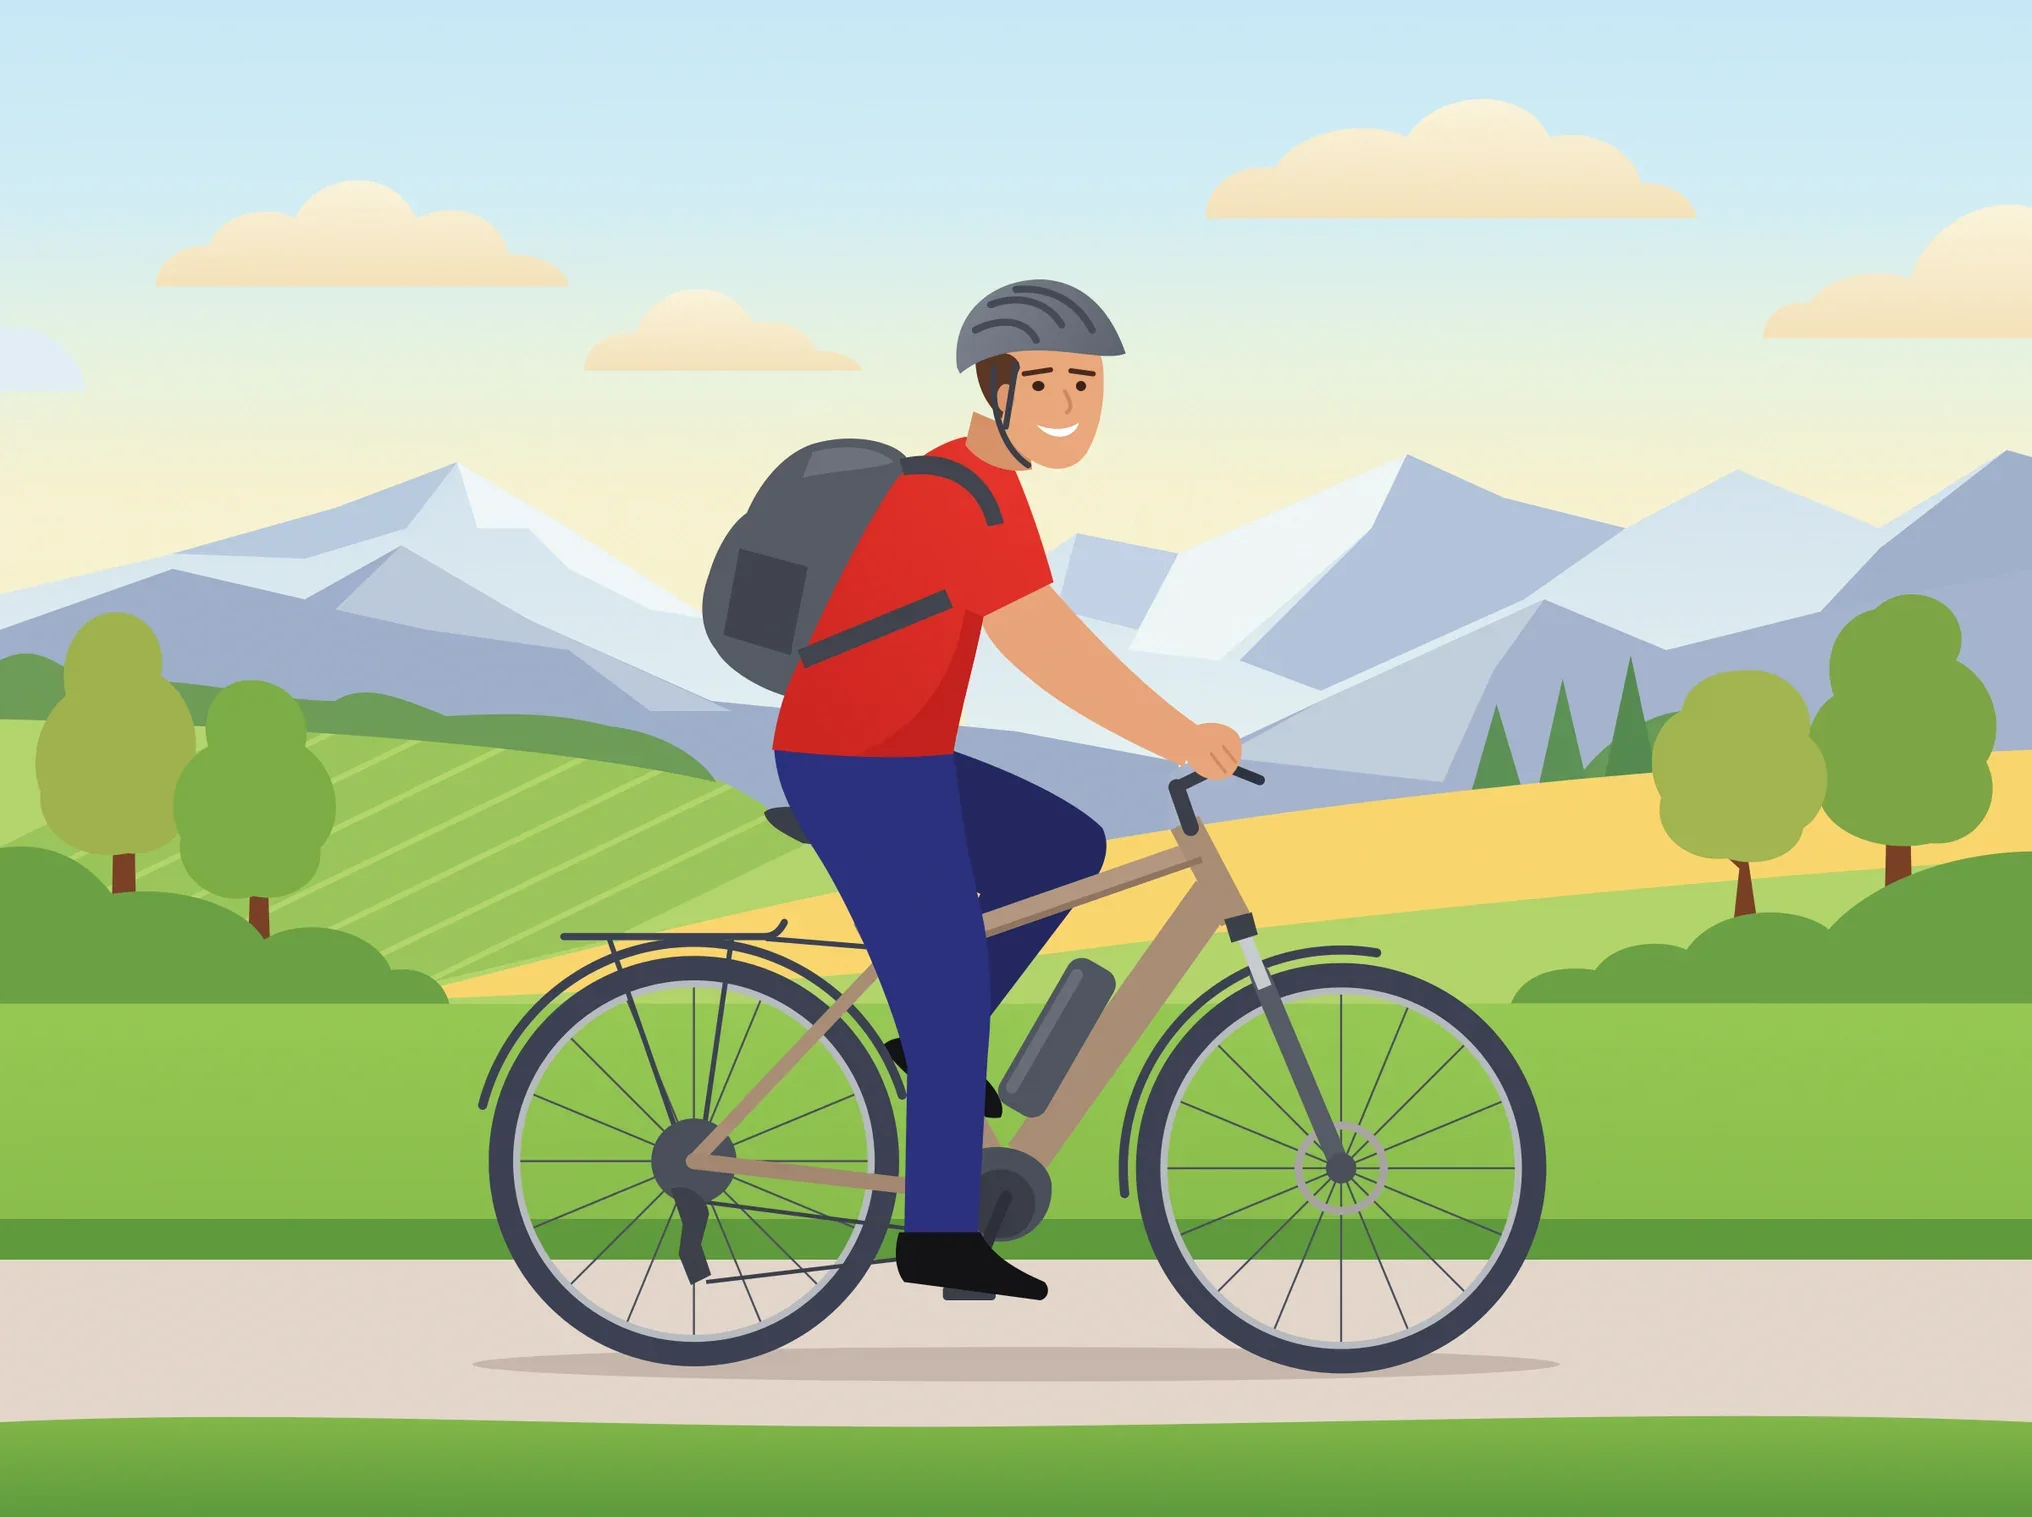
#14 Claude Fable 5.1 · medium
39.4 Punteggio $1.2 4.4 min non superata Single-shot
-
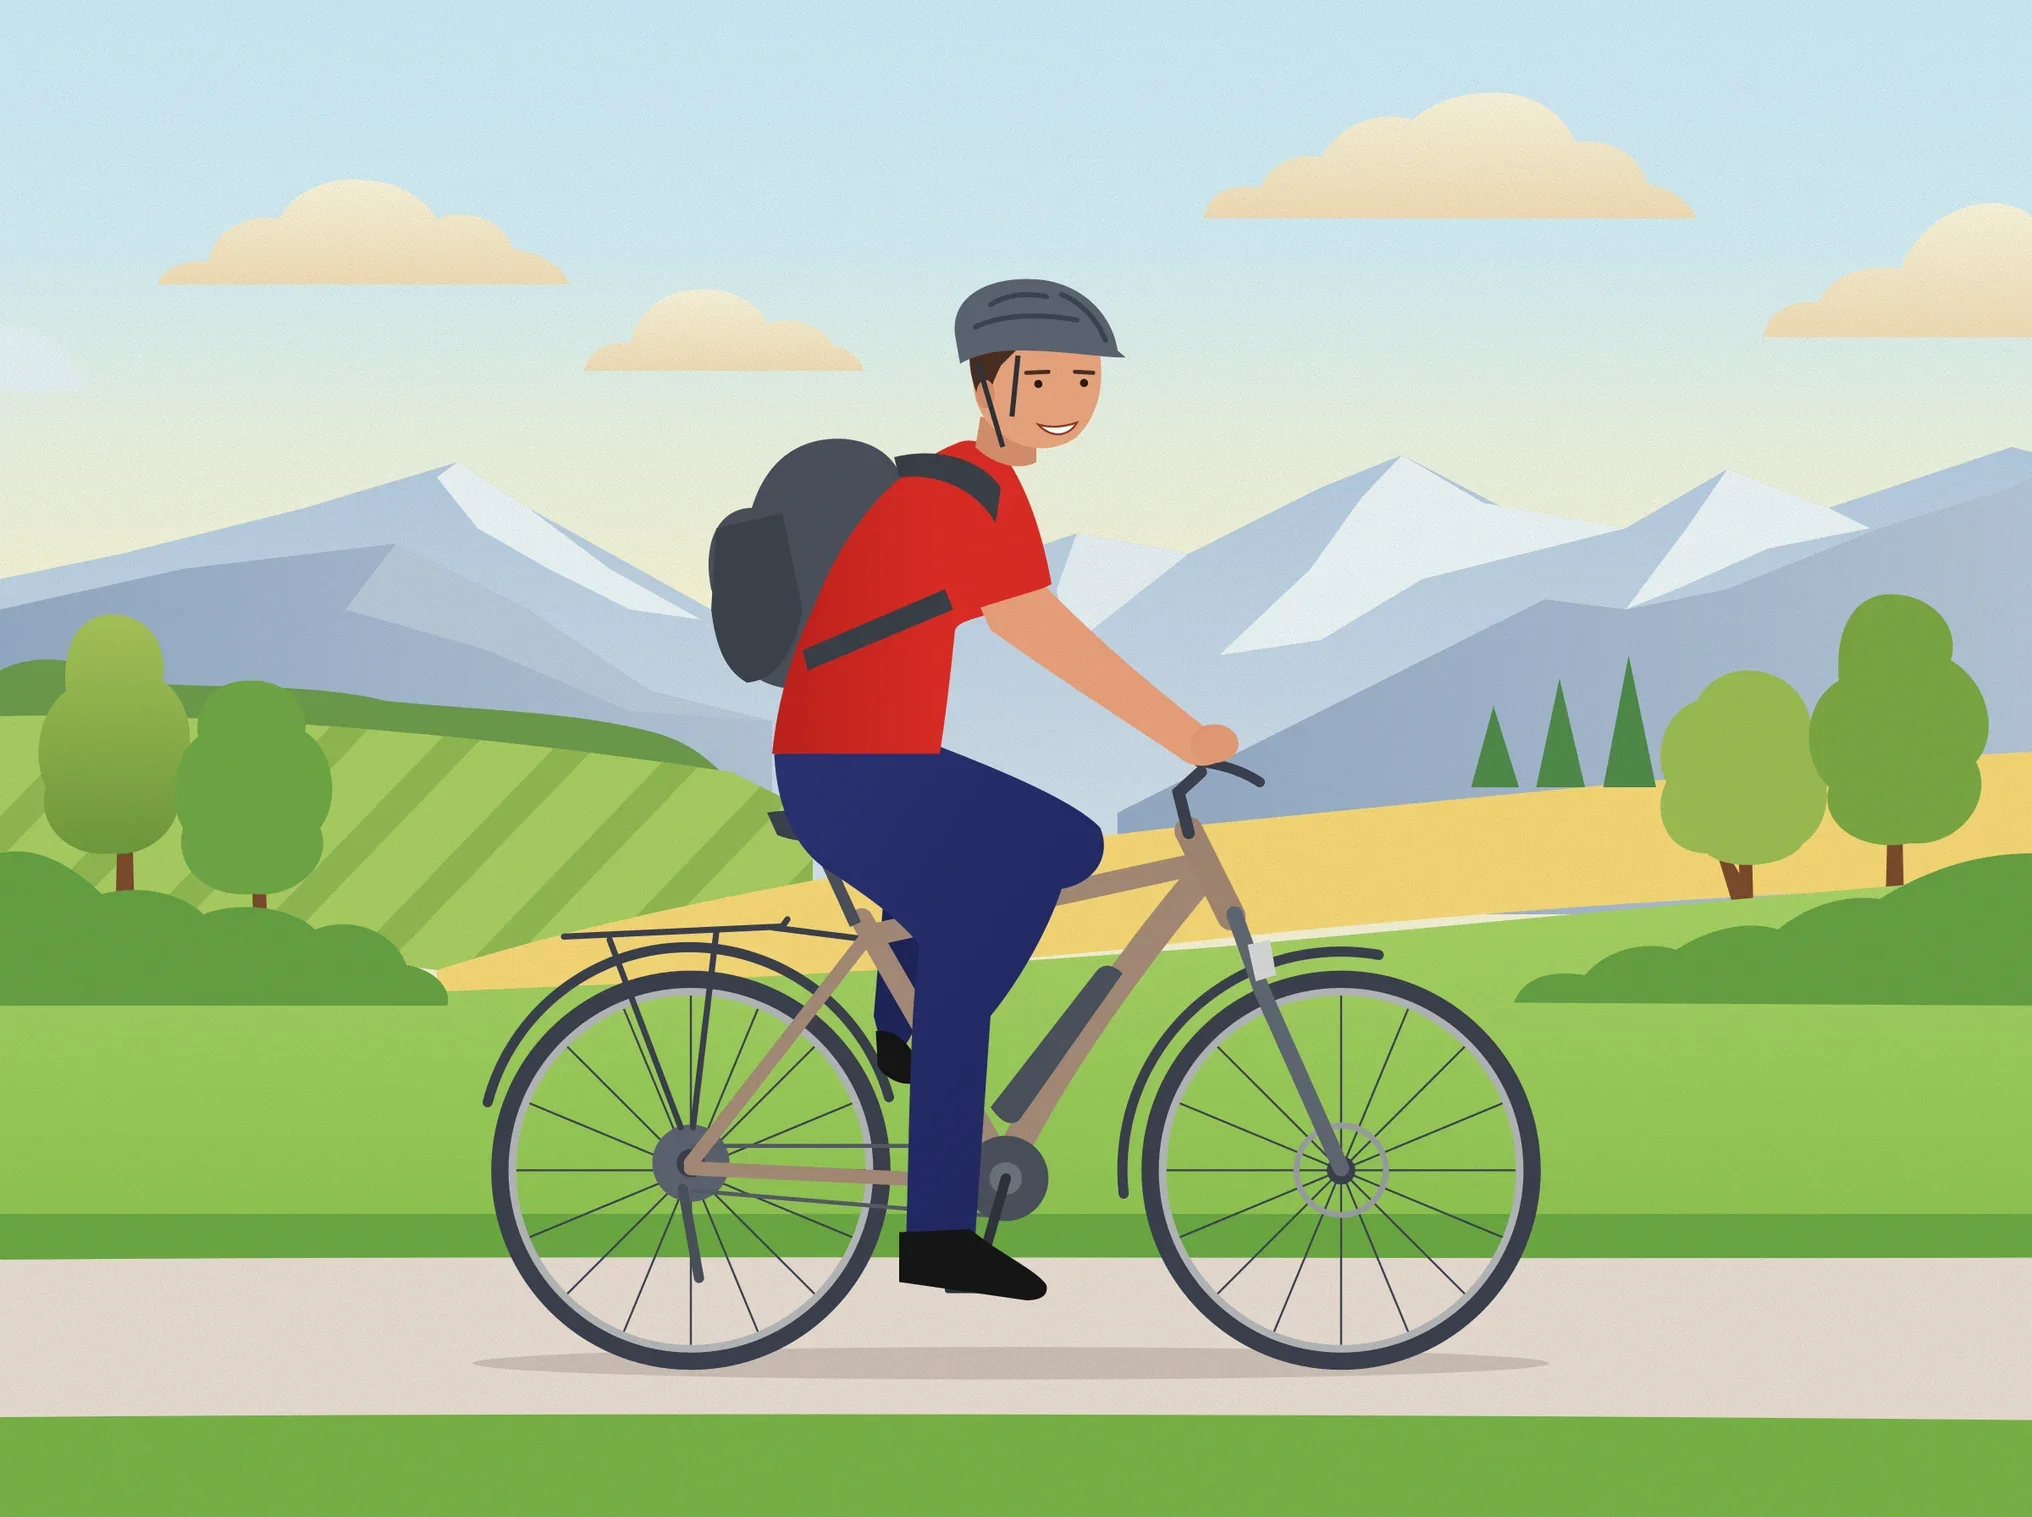
#15 Claude Opus 5.5 · medium
33.1 Punteggio $0.39 3.5 min non superata Single-shot
-
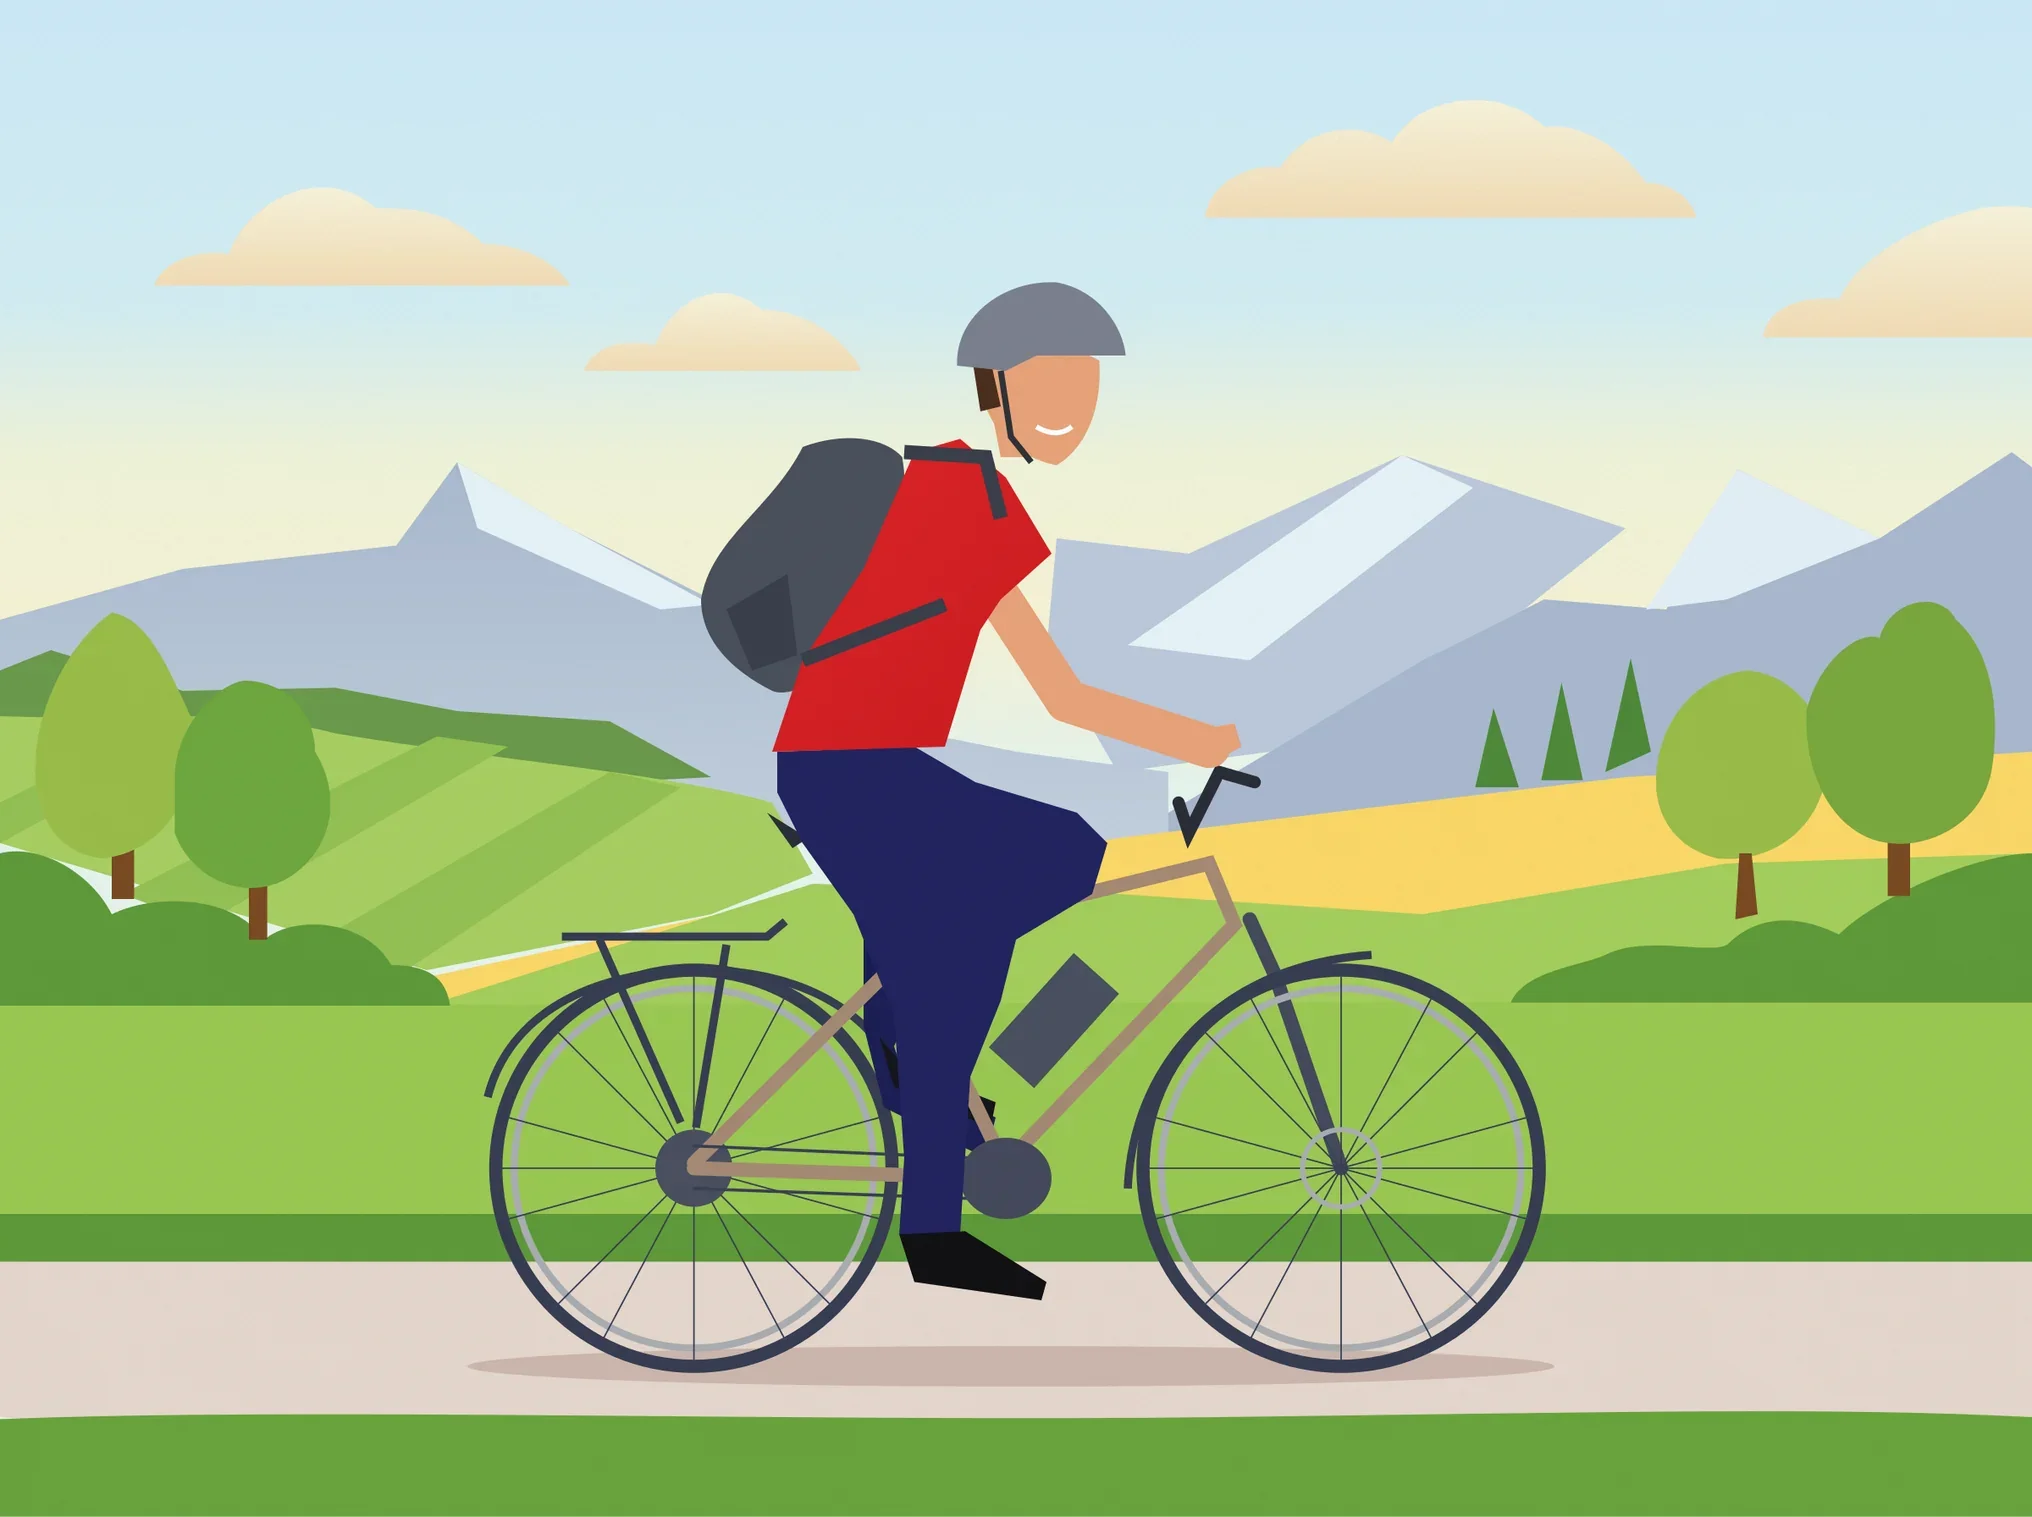
#16 Claude Sonnet 5.5 · medium
34.7 Punteggio $0.52 5.2 min non superata Ciclo fisso
-
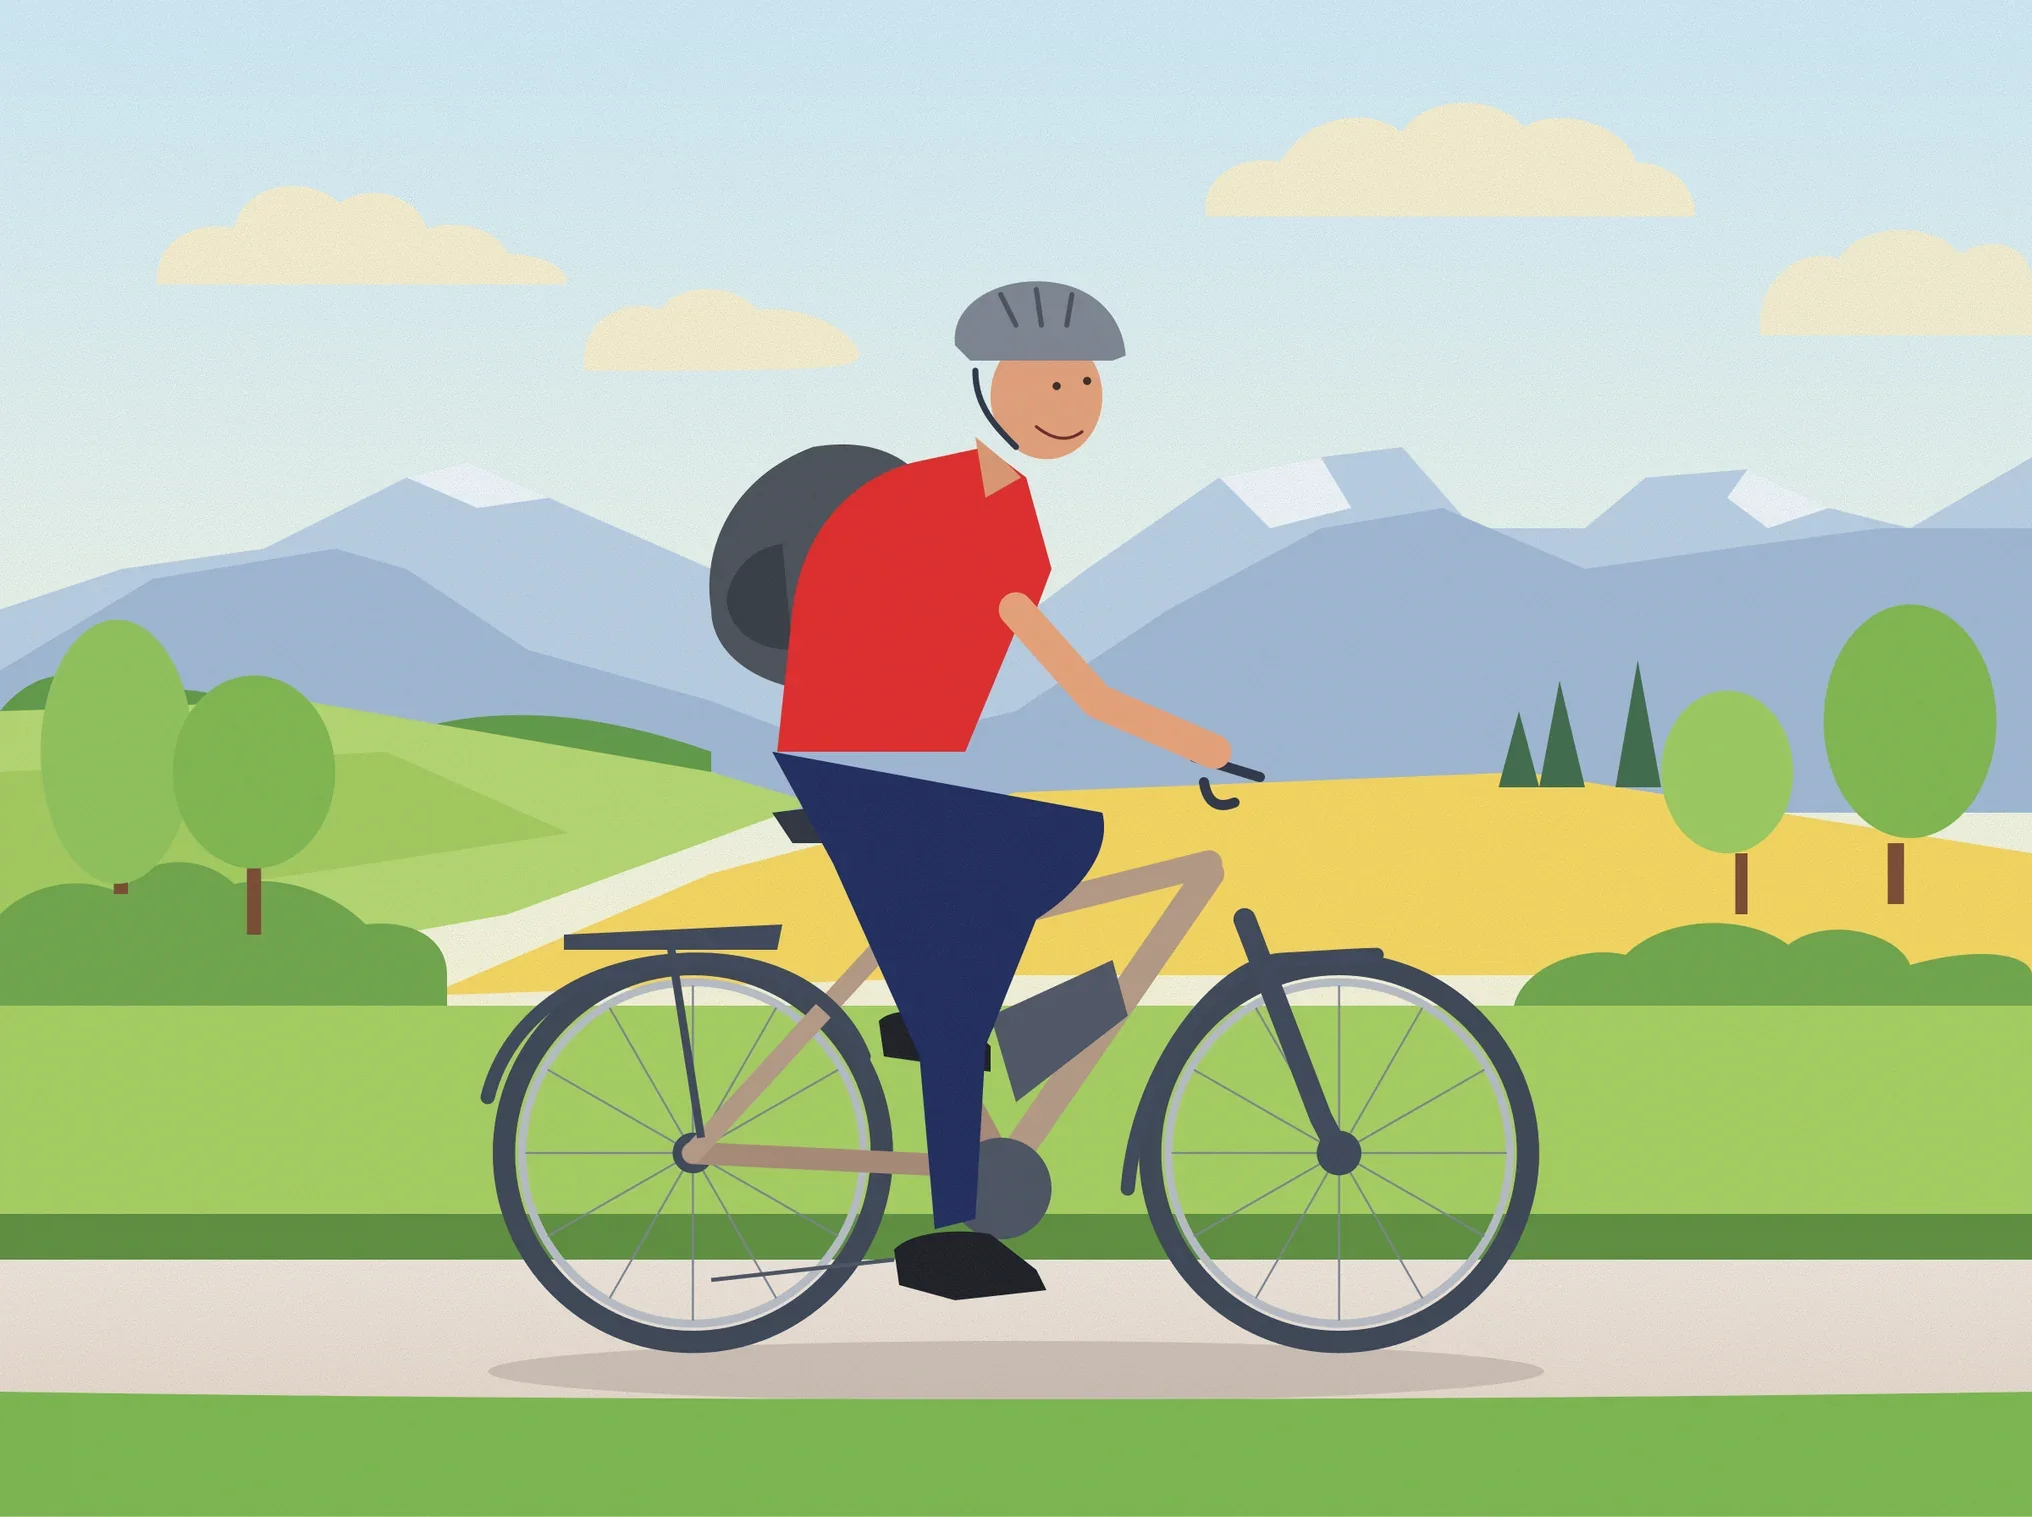
#17 Claude Haiku 5.5 · medium
30.5 Punteggio $0.01 1.4 min non superata Single-shot
-
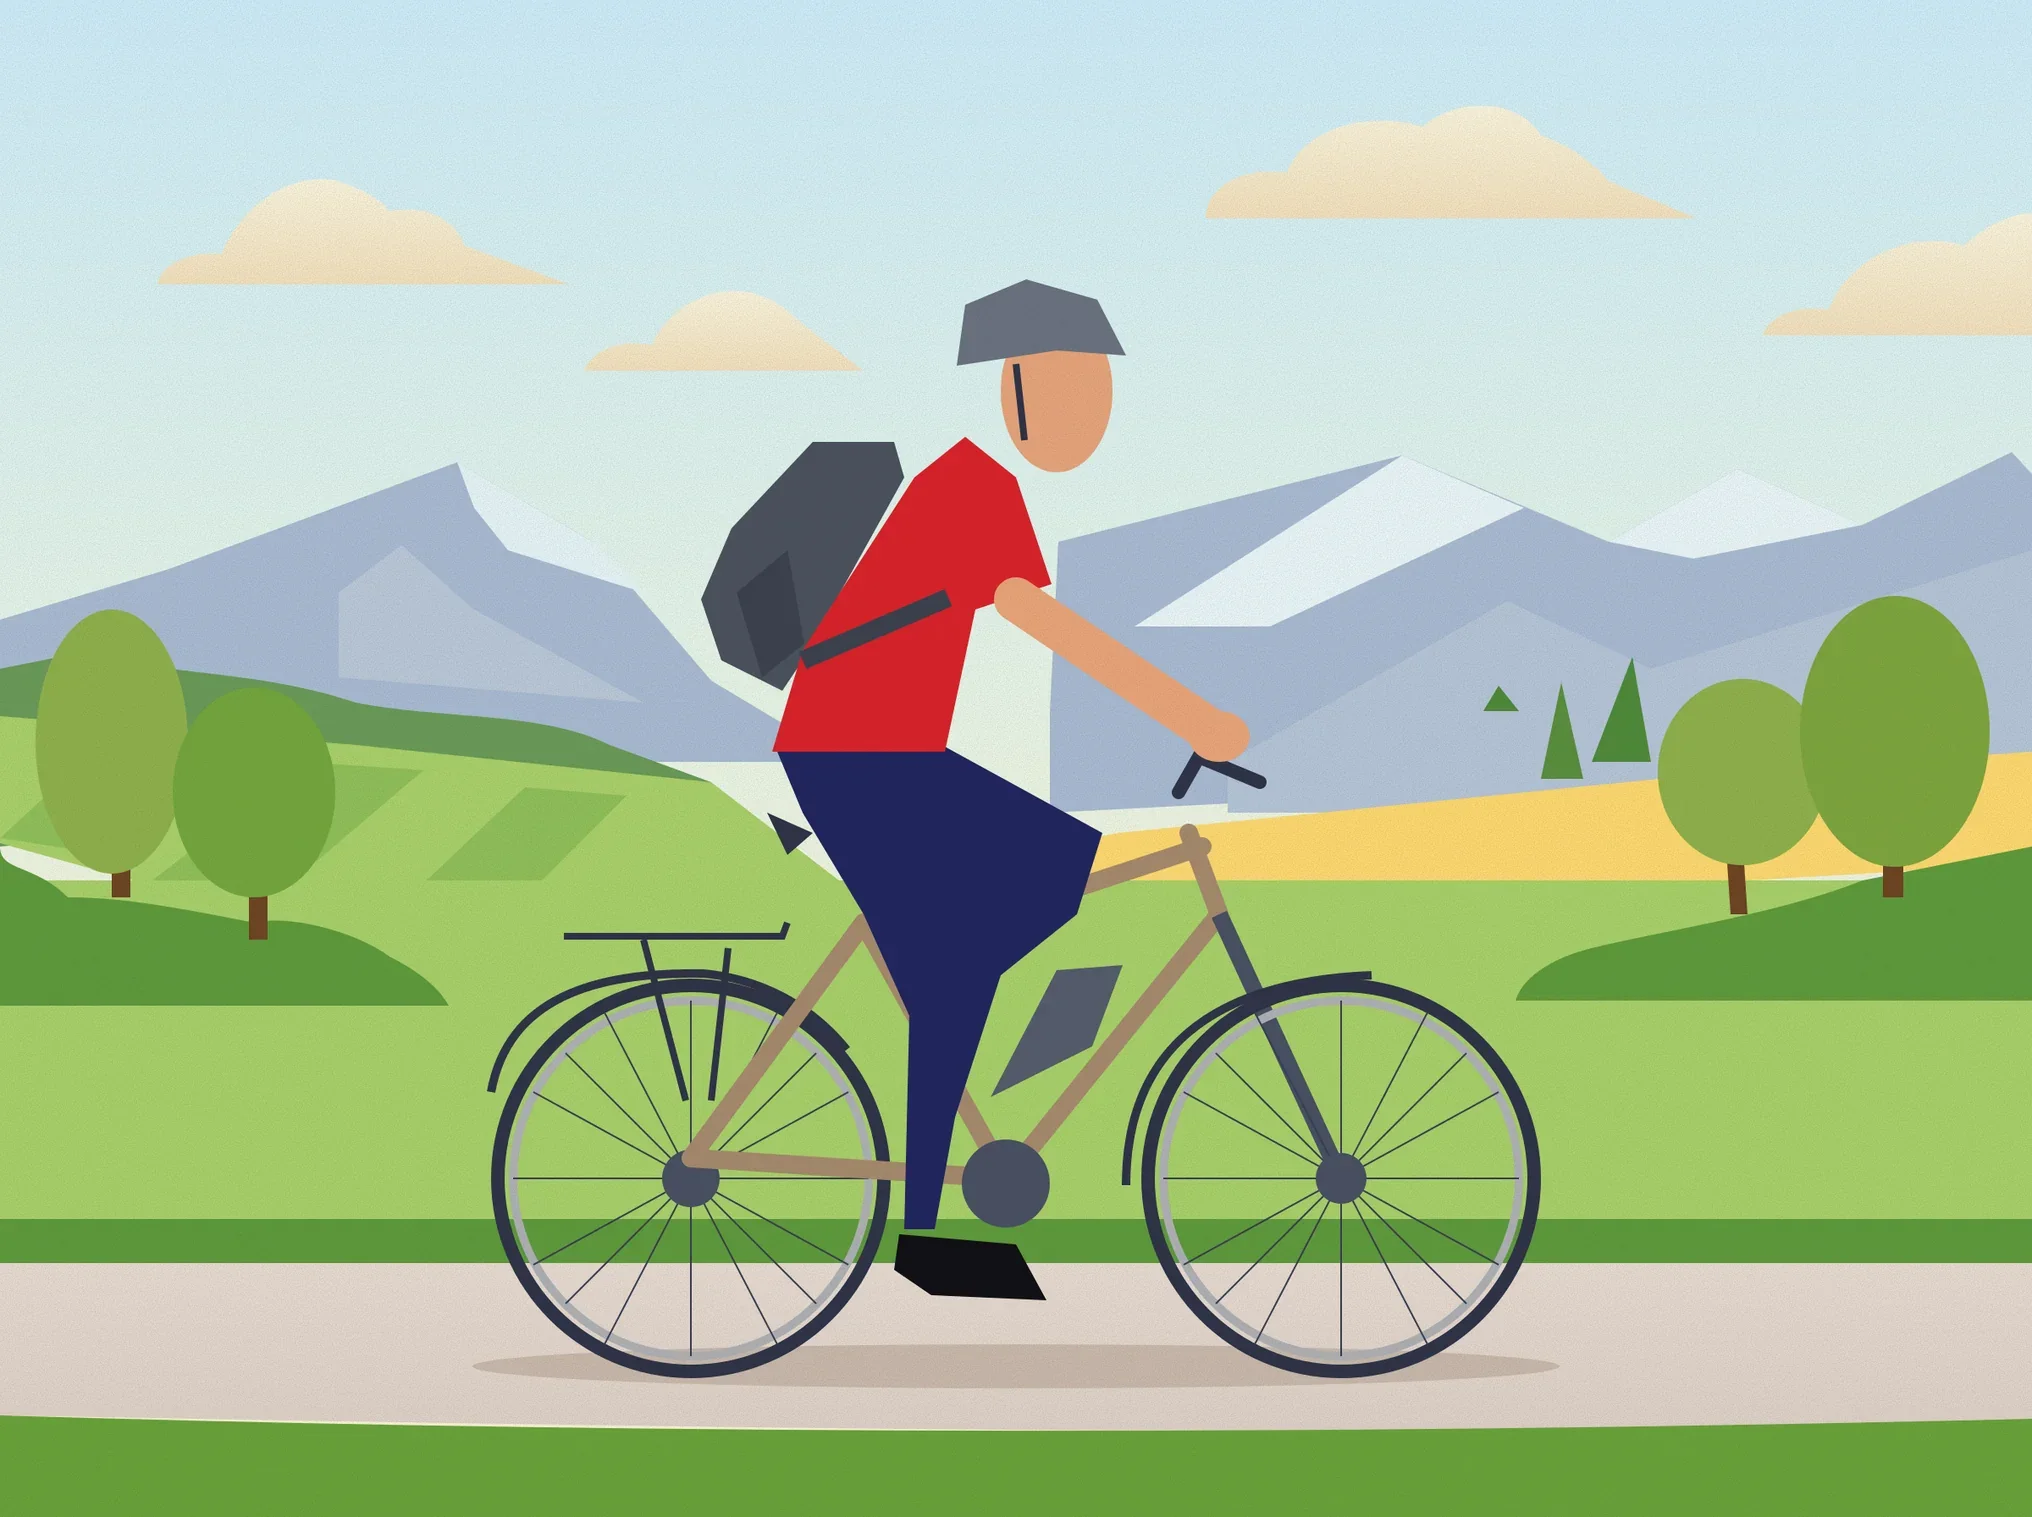
#18 Claude Sonnet 5.5 · medium
30.1 Punteggio $0.11 1.8 min non superata Single-shot
Originale contro Claude Opus 5.5 · max
Originale Claude Opus 5.5 · max Ritagli ingranditi
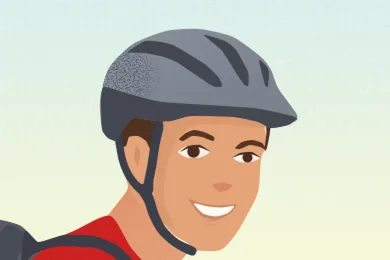
Viso e casco
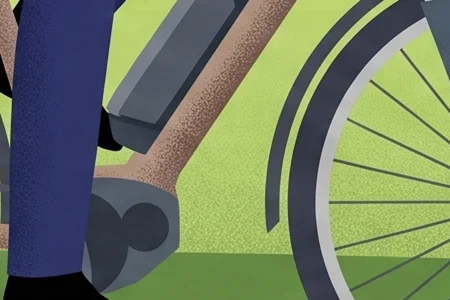
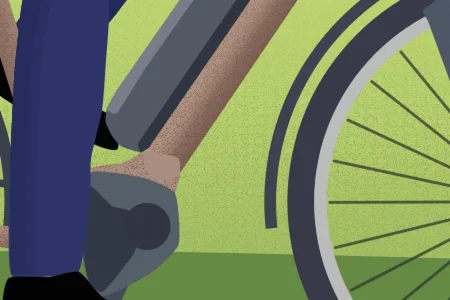
Trasmissione
Risultati: L'abbraccio al laptop
-
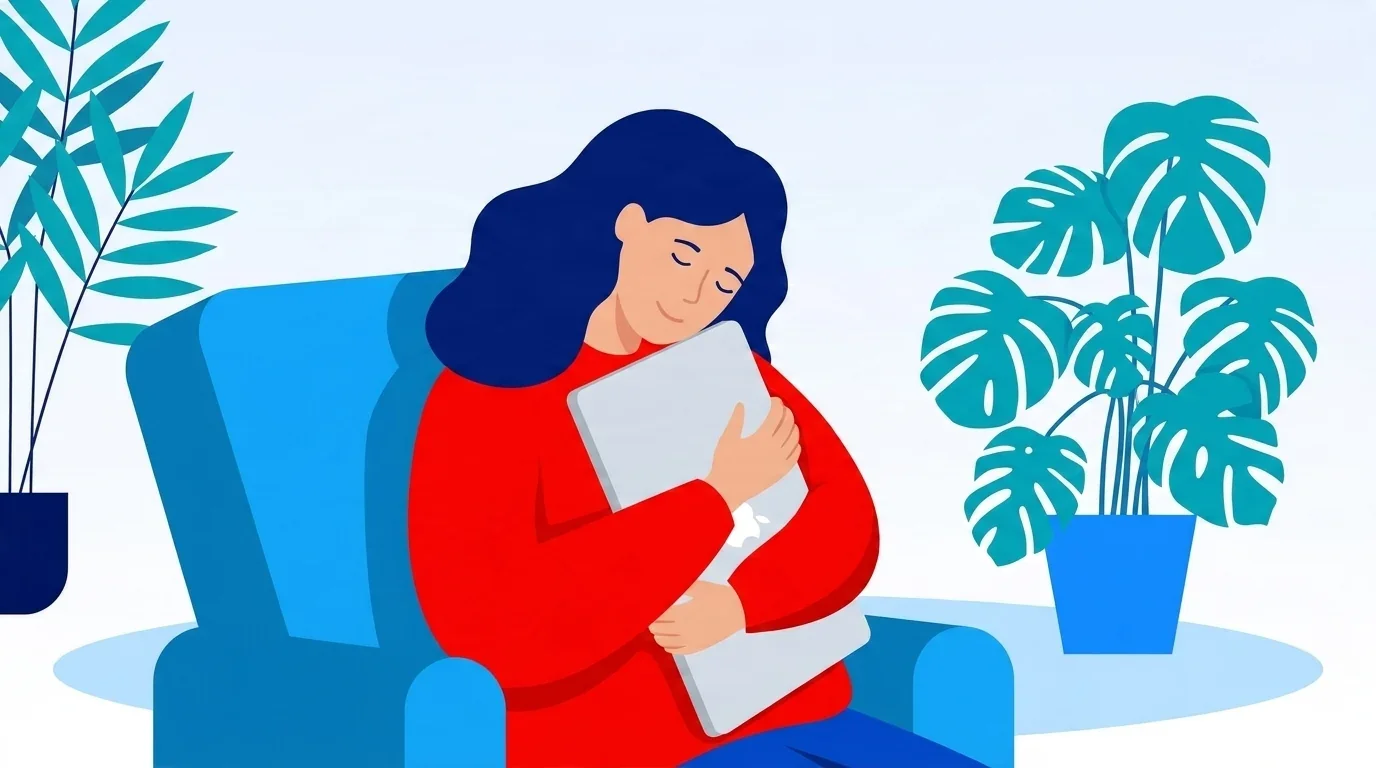
Originale
1376 × 768 px
-
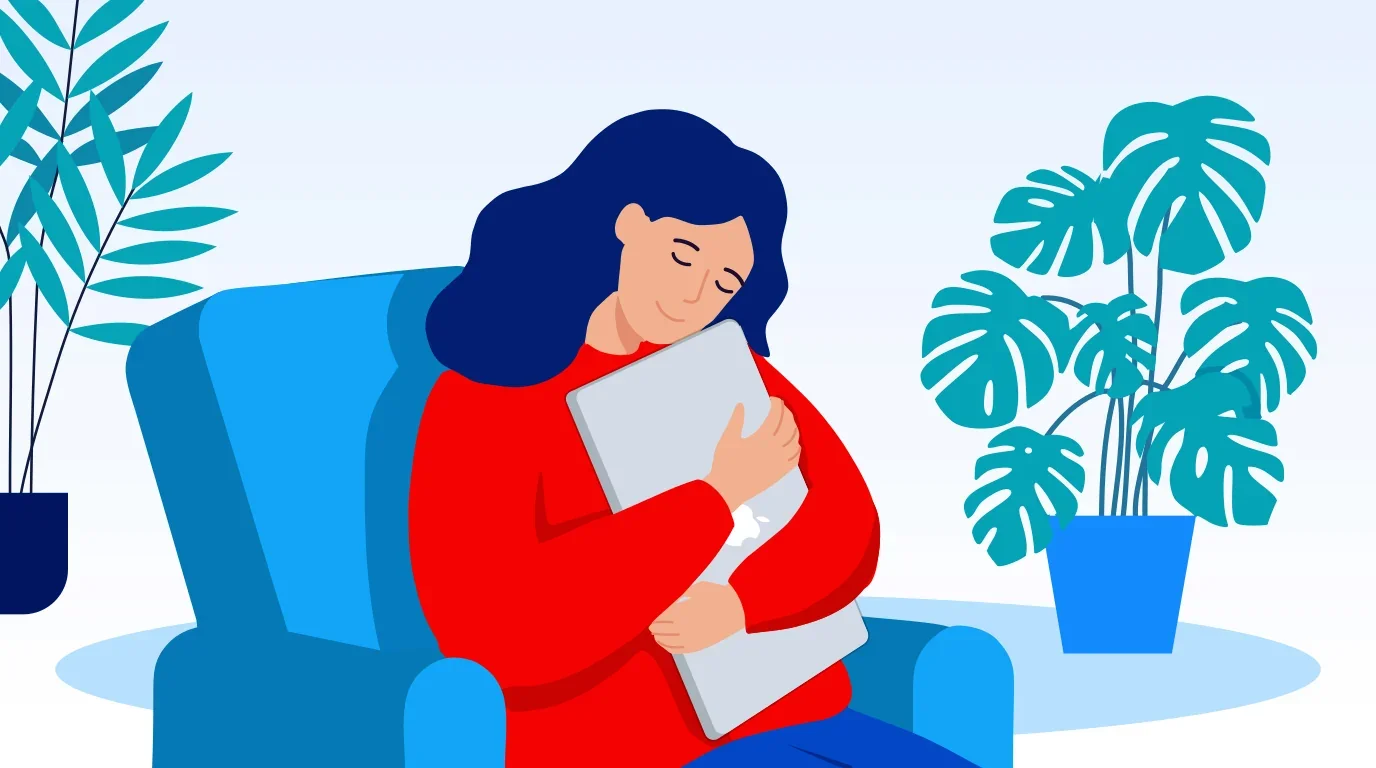
#1 Claude Opus 5.5 · max
87.5 Punteggio $43.5 108 min superata Agentico
-
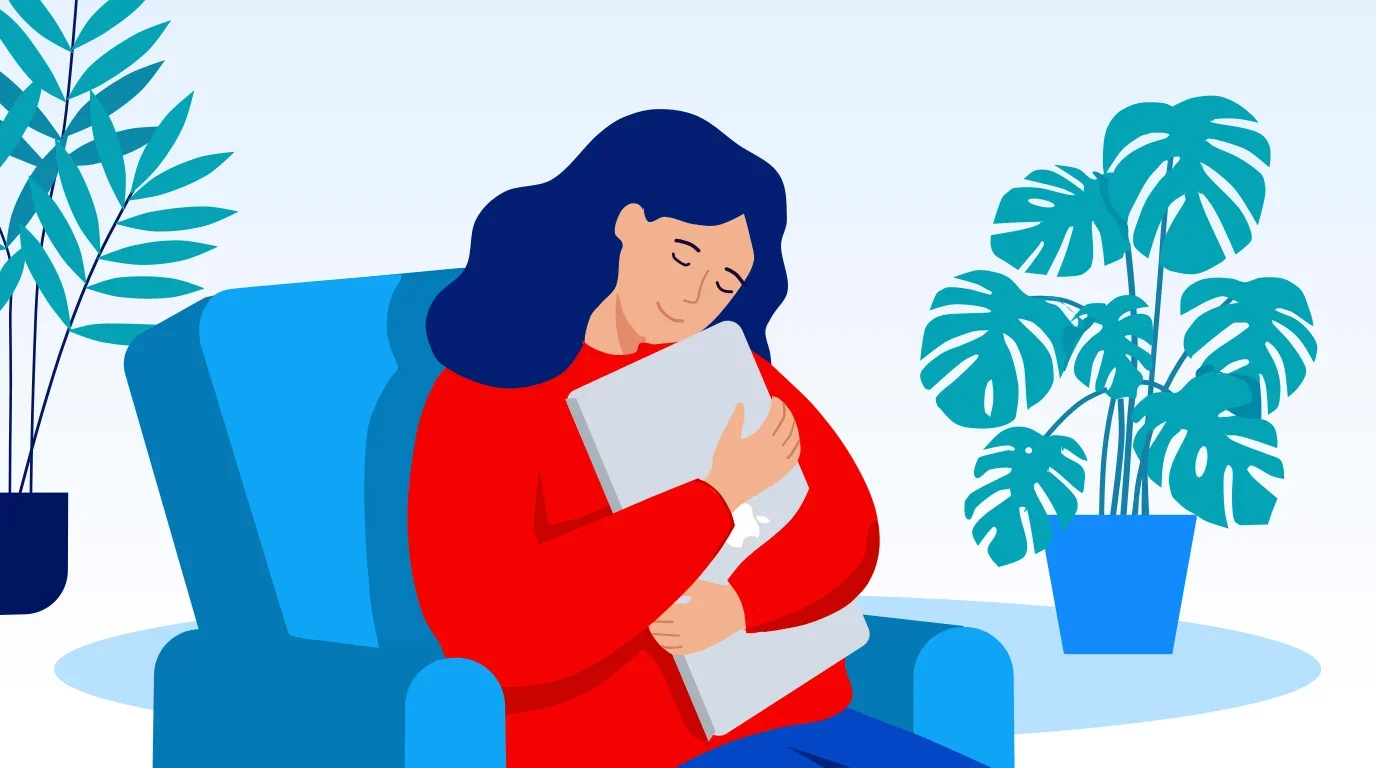
#2 Claude Sonnet 5.5 · xhigh
84.3 Punteggio $23.4 84 min superata Agentico
-
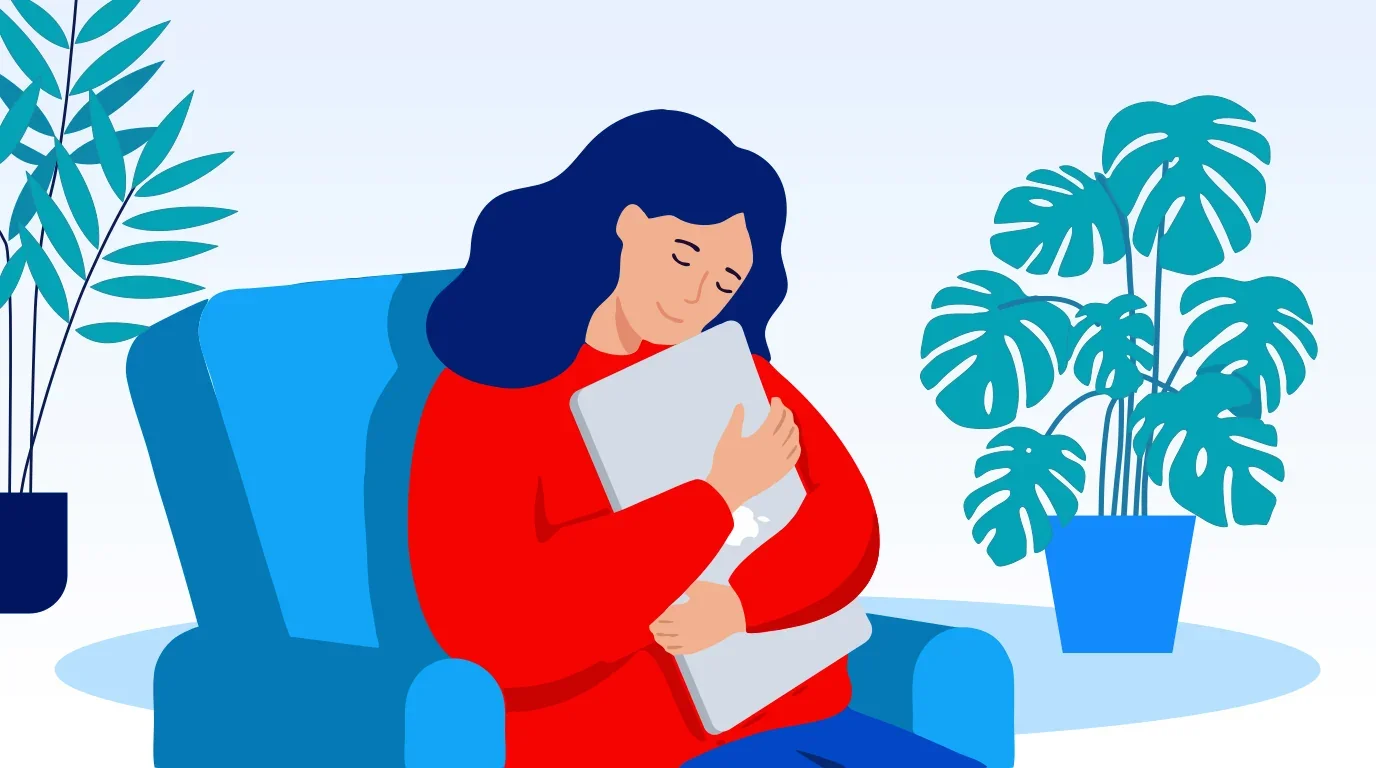
#3 Claude Opus 5.5 · high
85.2 Punteggio $18.1 64 min superata Agentico
-
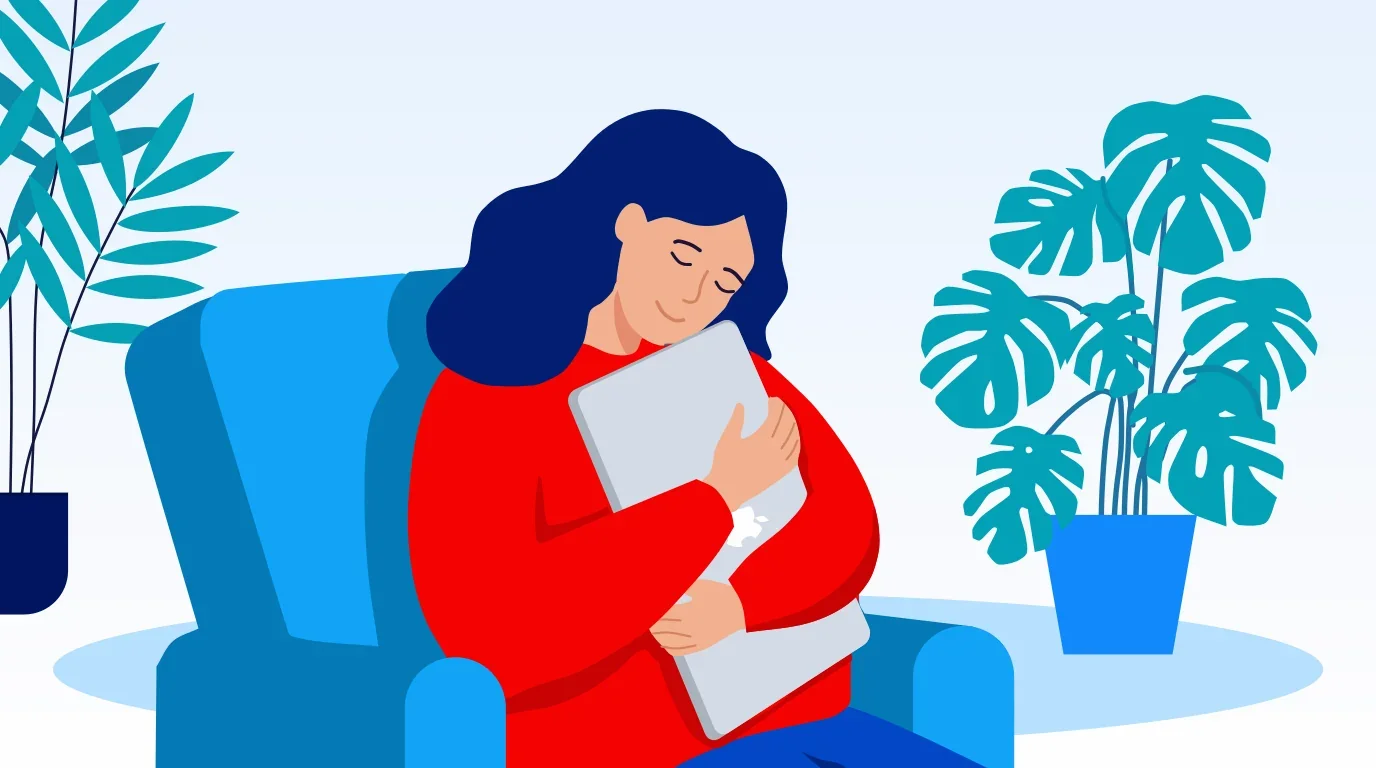
#4 Claude Opus 5.5 · xhigh
83.7 Punteggio $27.1 83 min superata Agentico
-
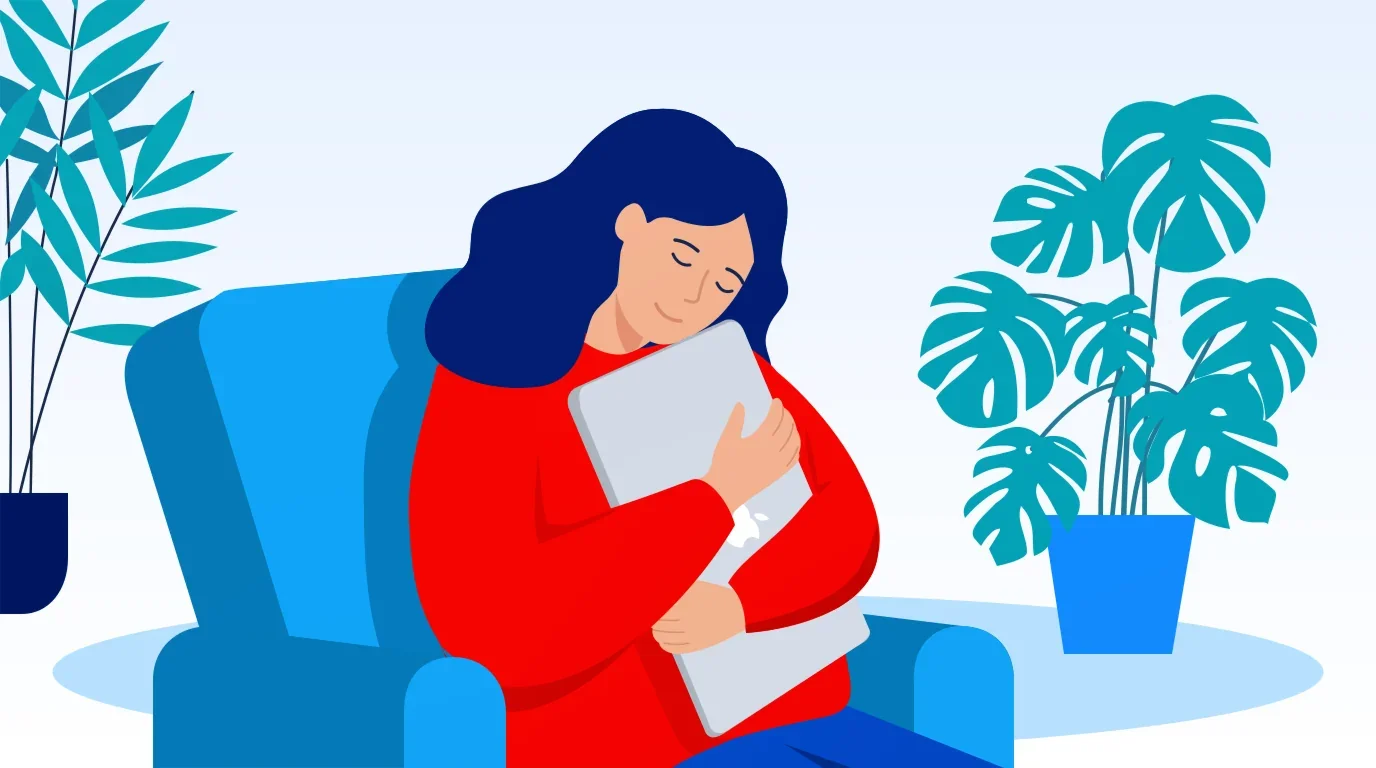
#5 GPT 6.1 Sol · xhigh
75.7 Punteggio $6.8 57 min superata Agentico
-
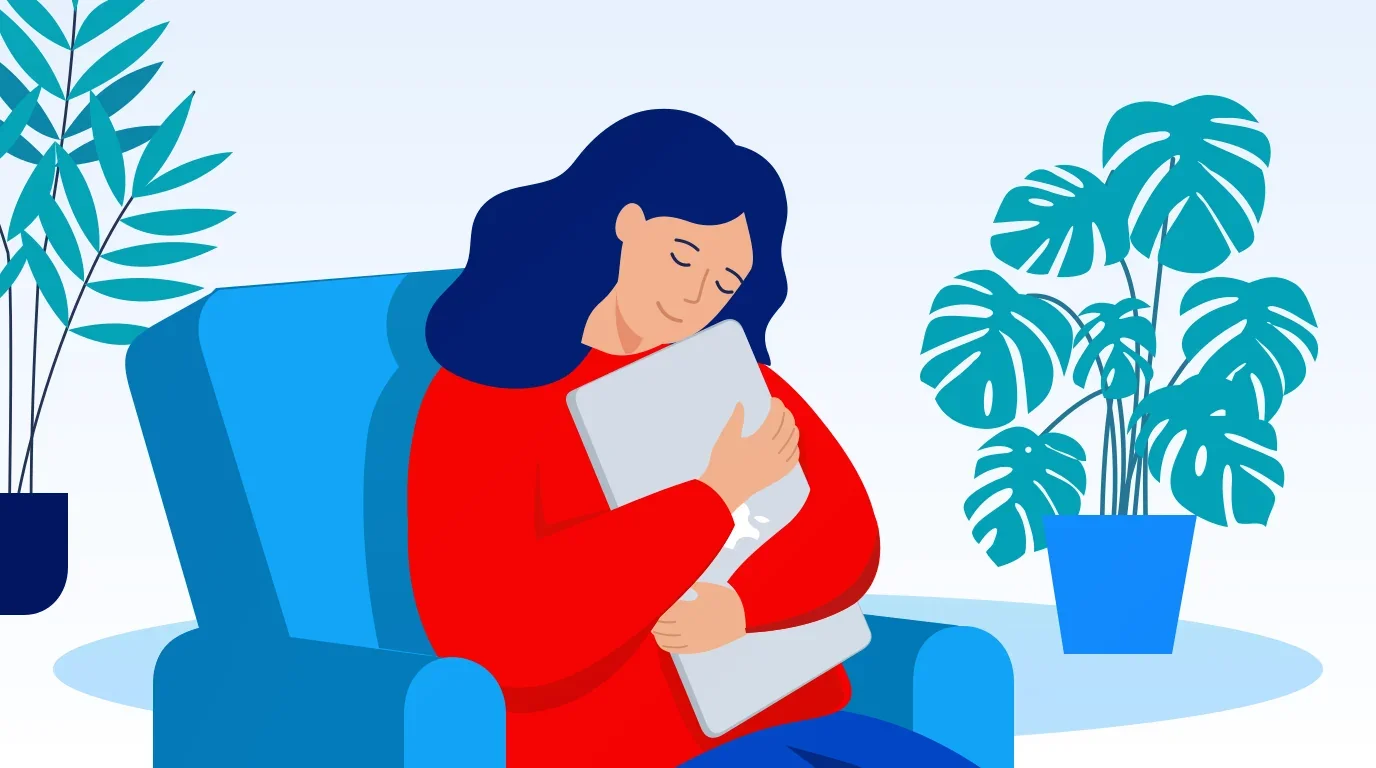
#6 GPT 6.1 Sol · high
74.4 Punteggio $5.3 48 min superata Agentico
-
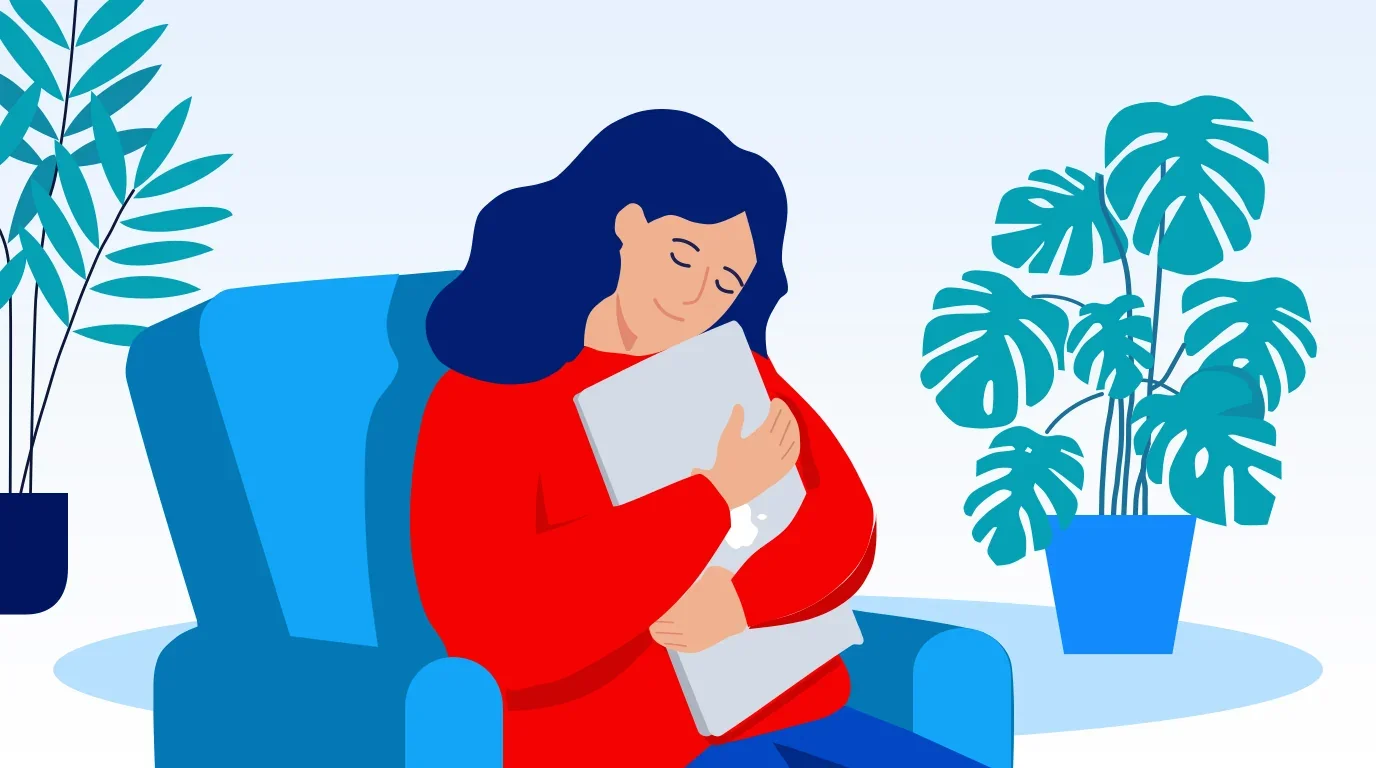
#7 Claude Sonnet 5.5 · high
75.2 Punteggio $8.5 31 min superata Agentico
-
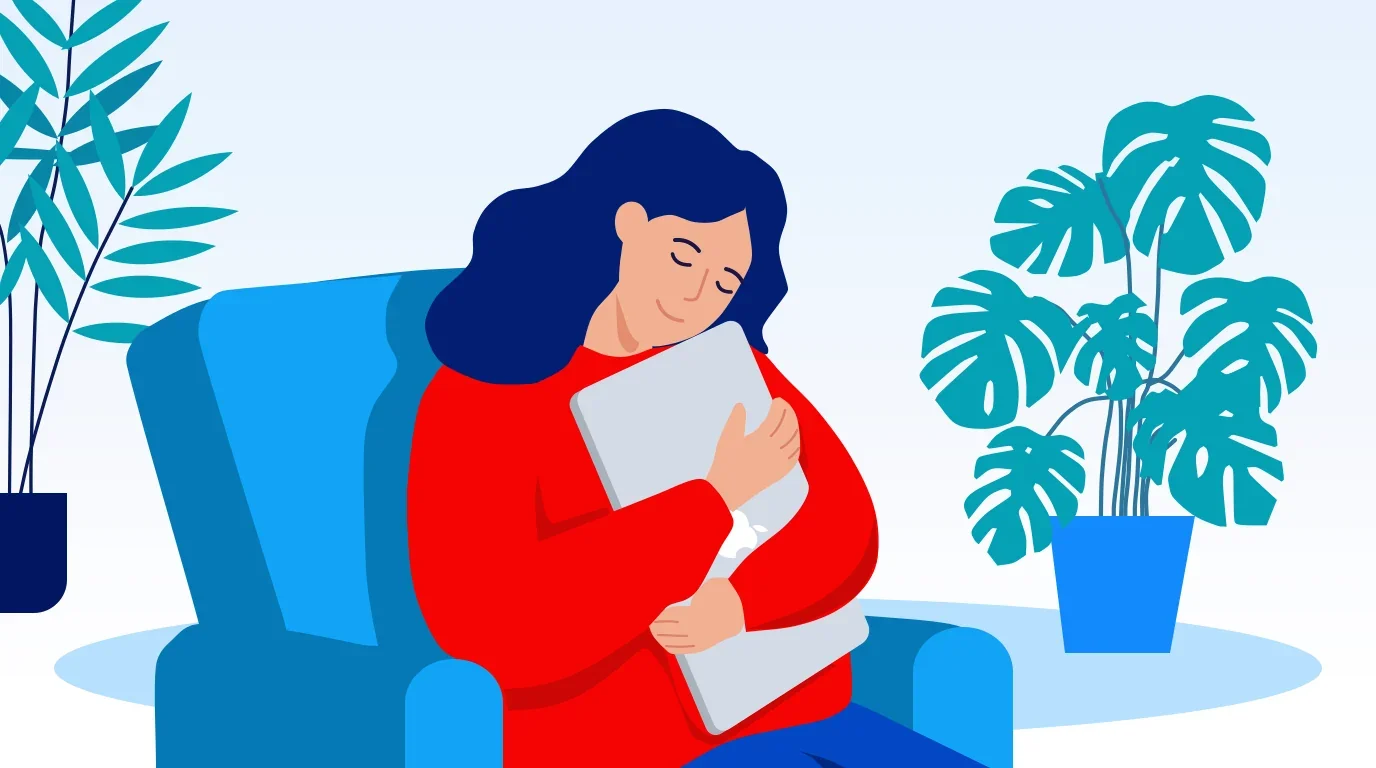
#8 Claude Opus 5.5 · medium
77.5 Punteggio $9.8 33 min superata Agentico
-
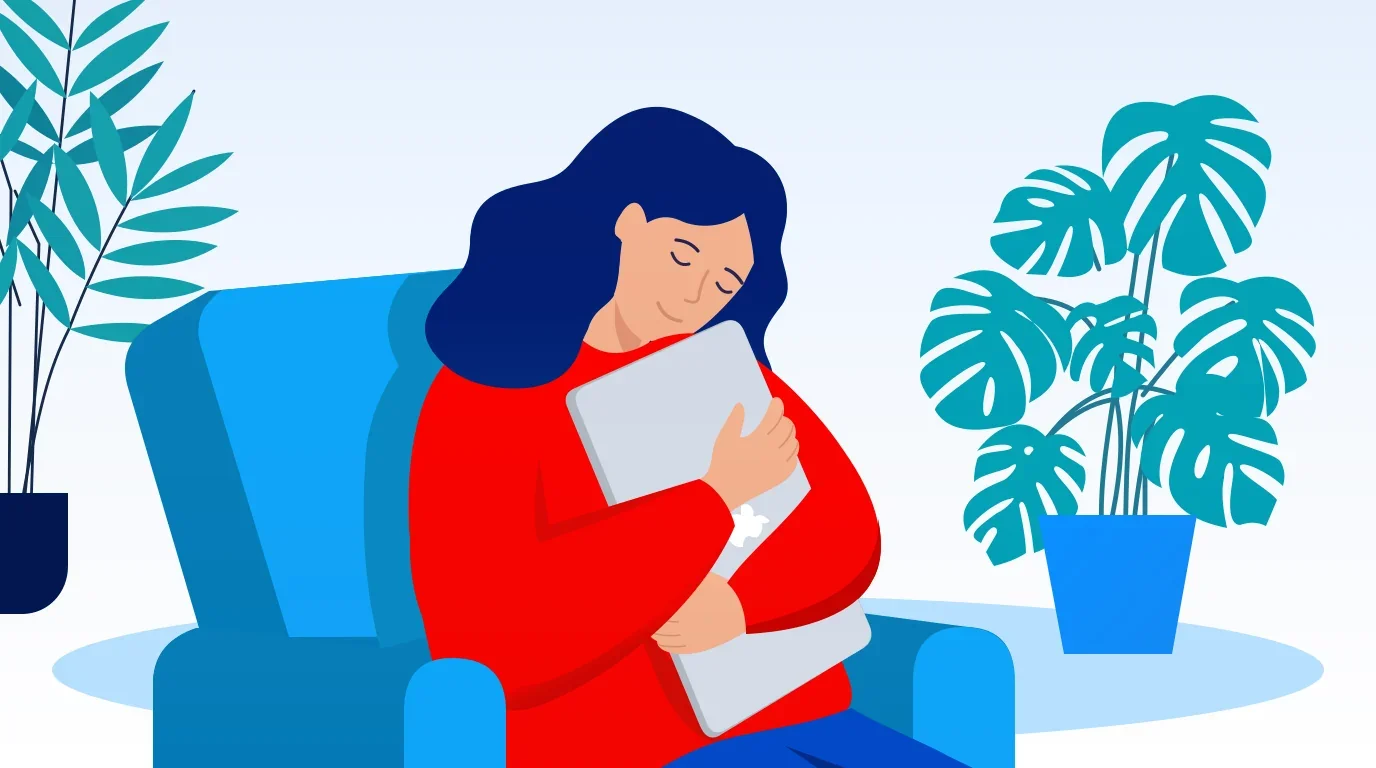
#9 GPT 6.1 Sol · medium
64.6 Punteggio $2.3 18 min non superata Agentico
-
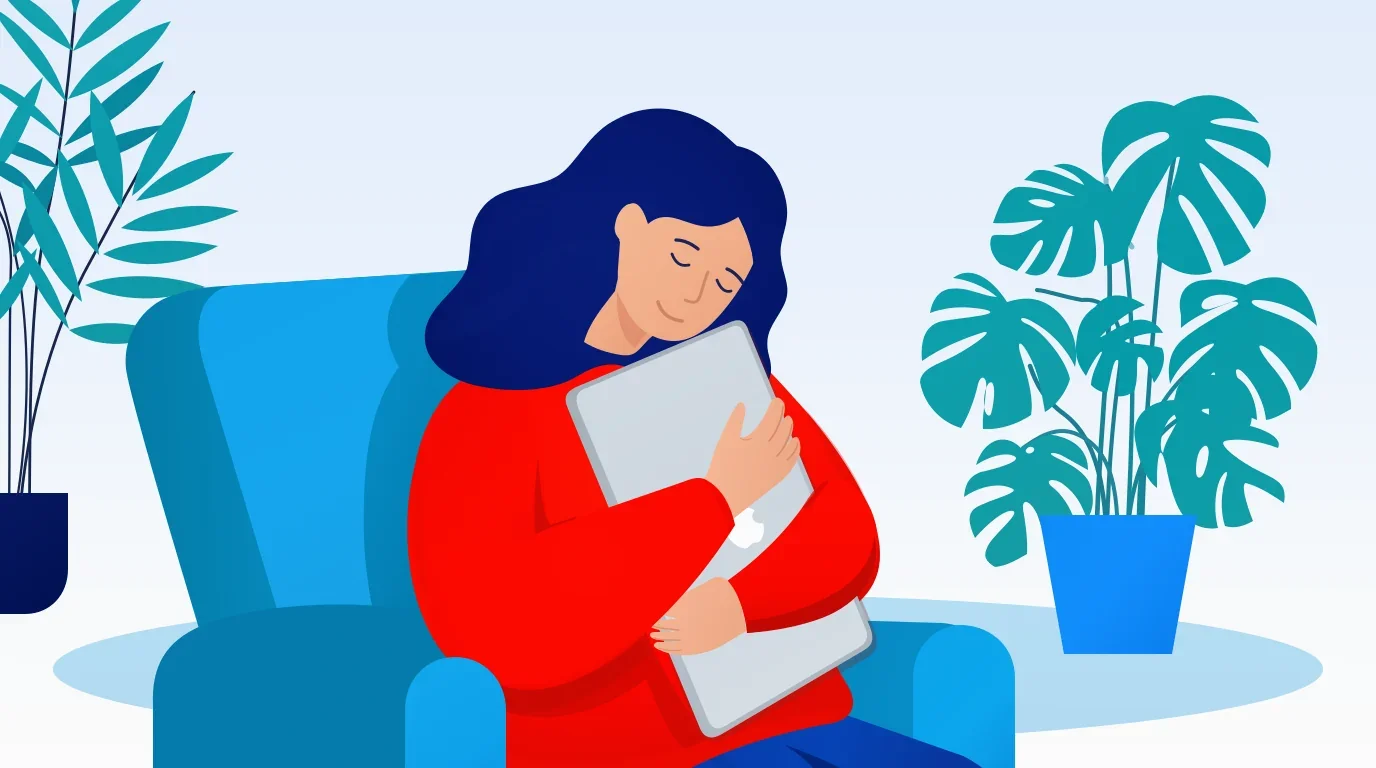
#10 GPT 6.1 Sol · xhigh
49.6 Punteggio $0.31 11 min non superata Single-shot
-
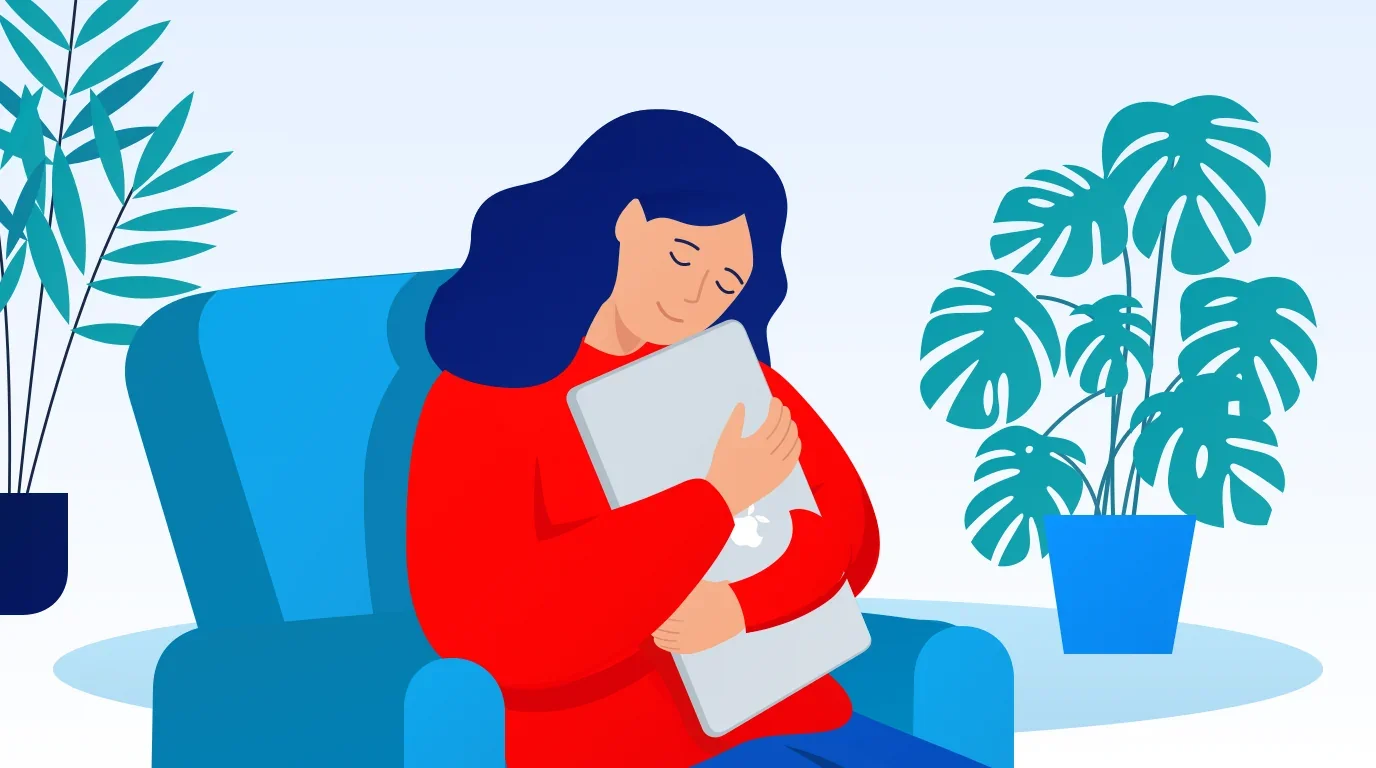
#11 GPT 6.1 Sol · medium
49.2 Punteggio $0.13 4 min non superata Single-shot
-
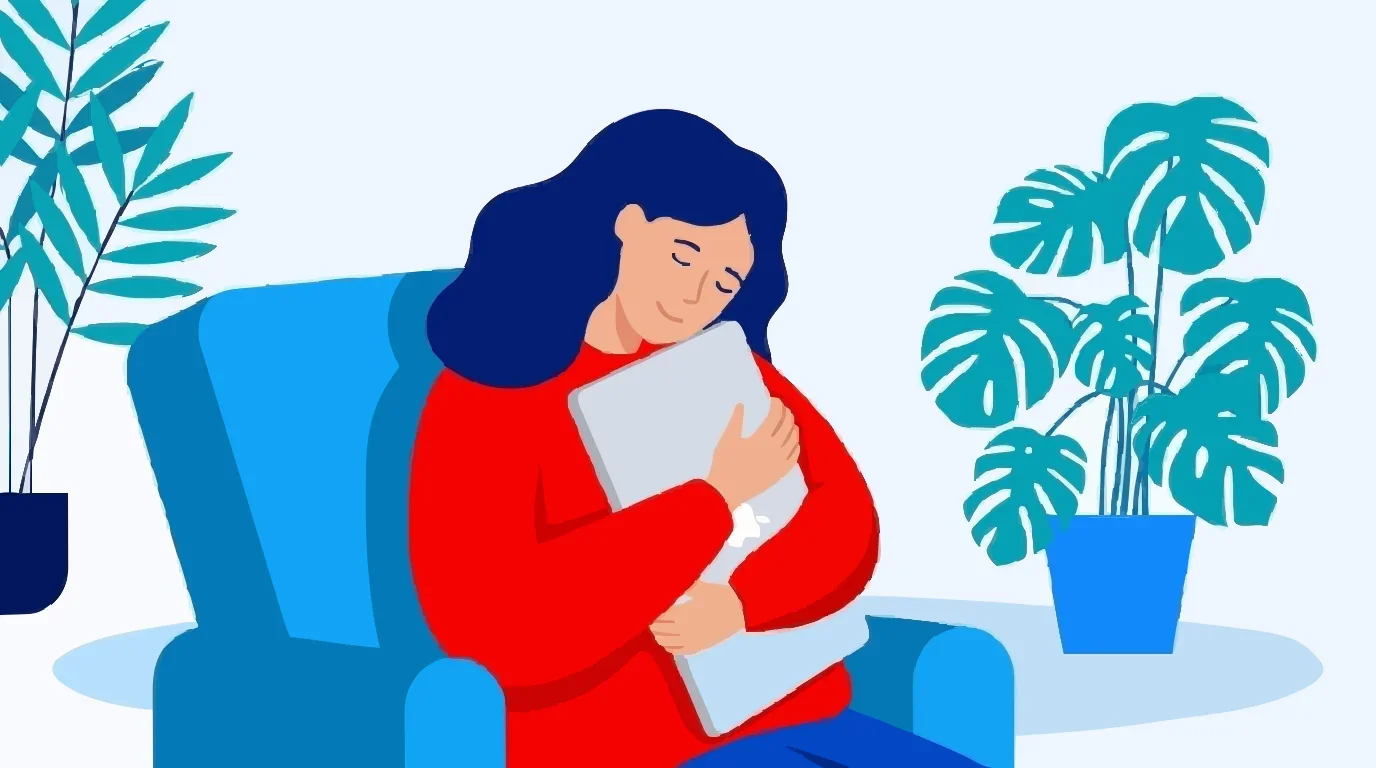
#12 vtracer 0.6.15, default settings
50.2 Punteggio $0.00 0 min superata Strumento
-
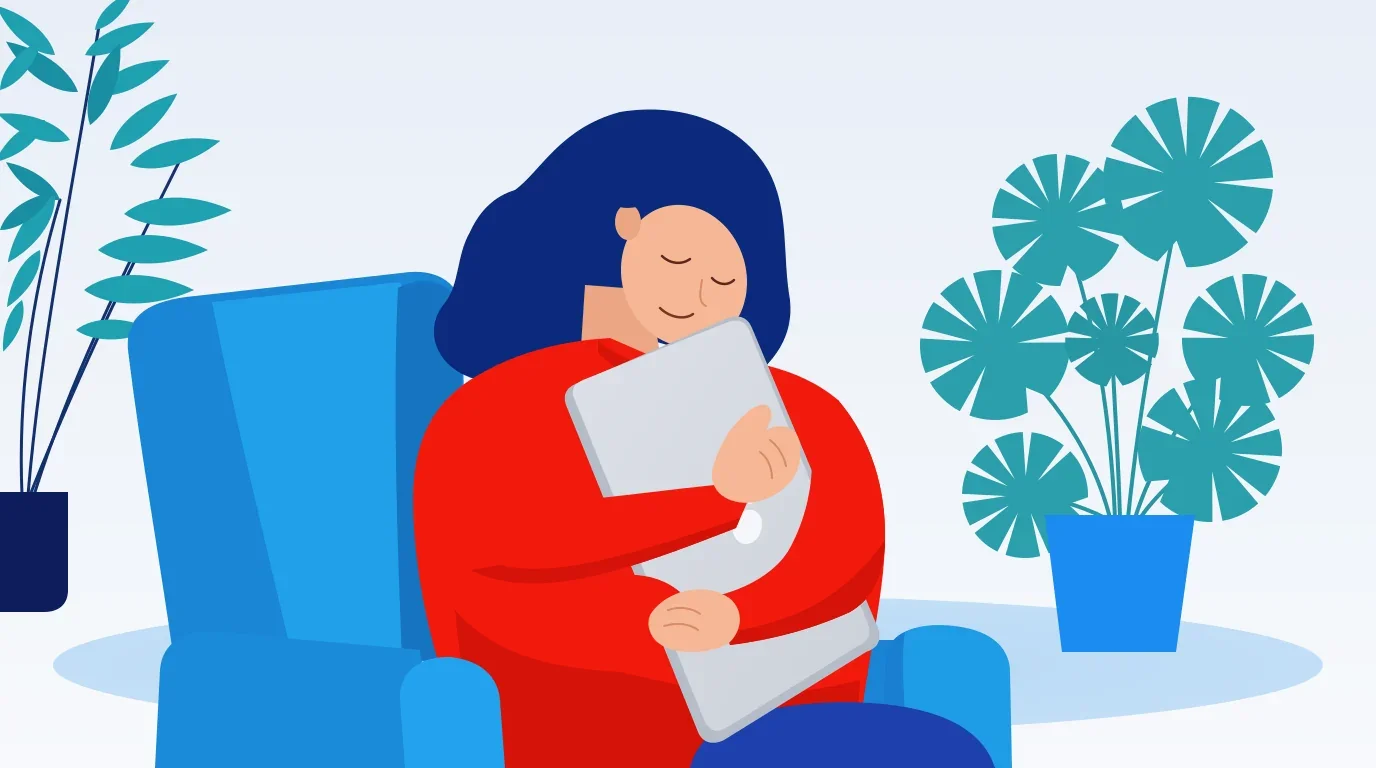
#13 Claude Opus 5.5 · medium
36.5 Punteggio $1.6 7.7 min non superata Ciclo fisso
-
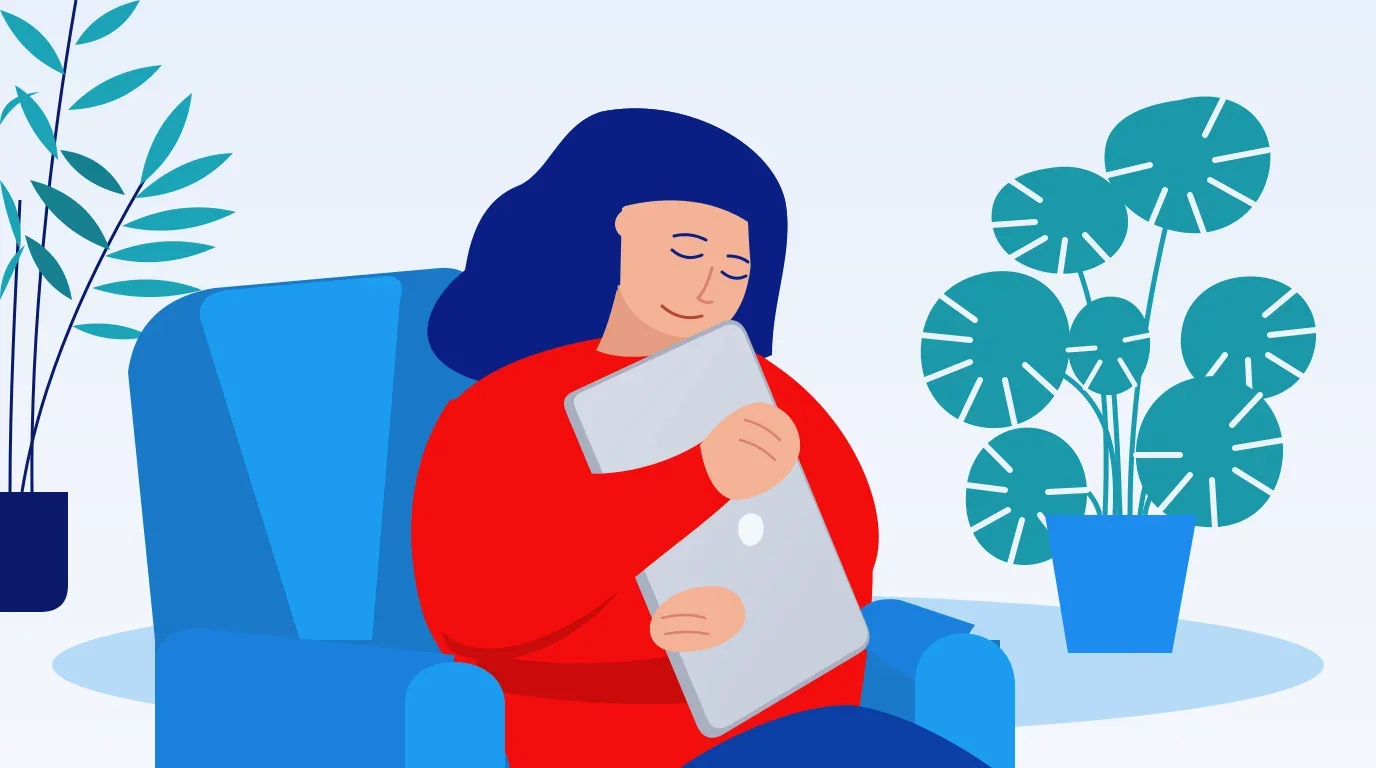
#14 Claude Fable 5.1 · medium
35.4 Punteggio $0.68 2.5 min non superata Single-shot
-
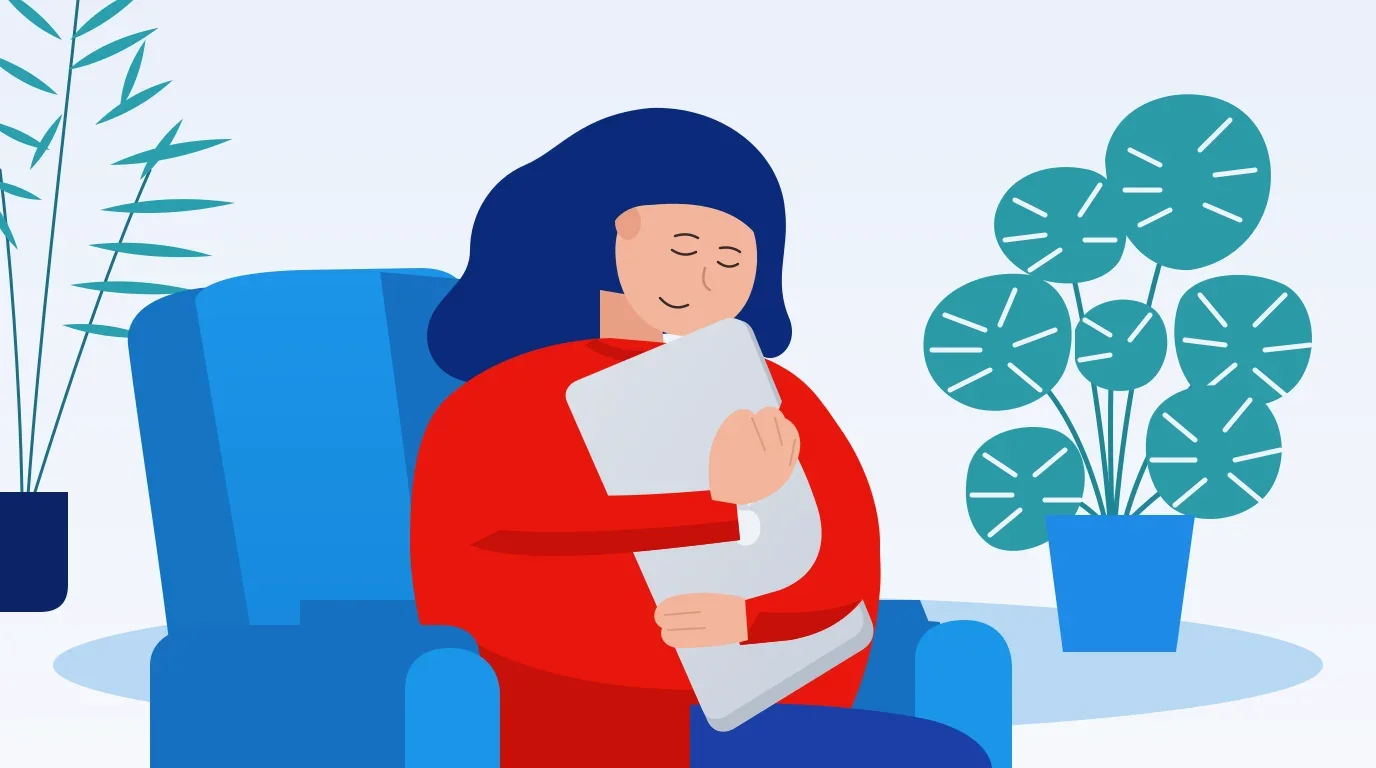
#15 Claude Opus 5.5 · medium
36.0 Punteggio $0.26 2.2 min non superata Single-shot
-
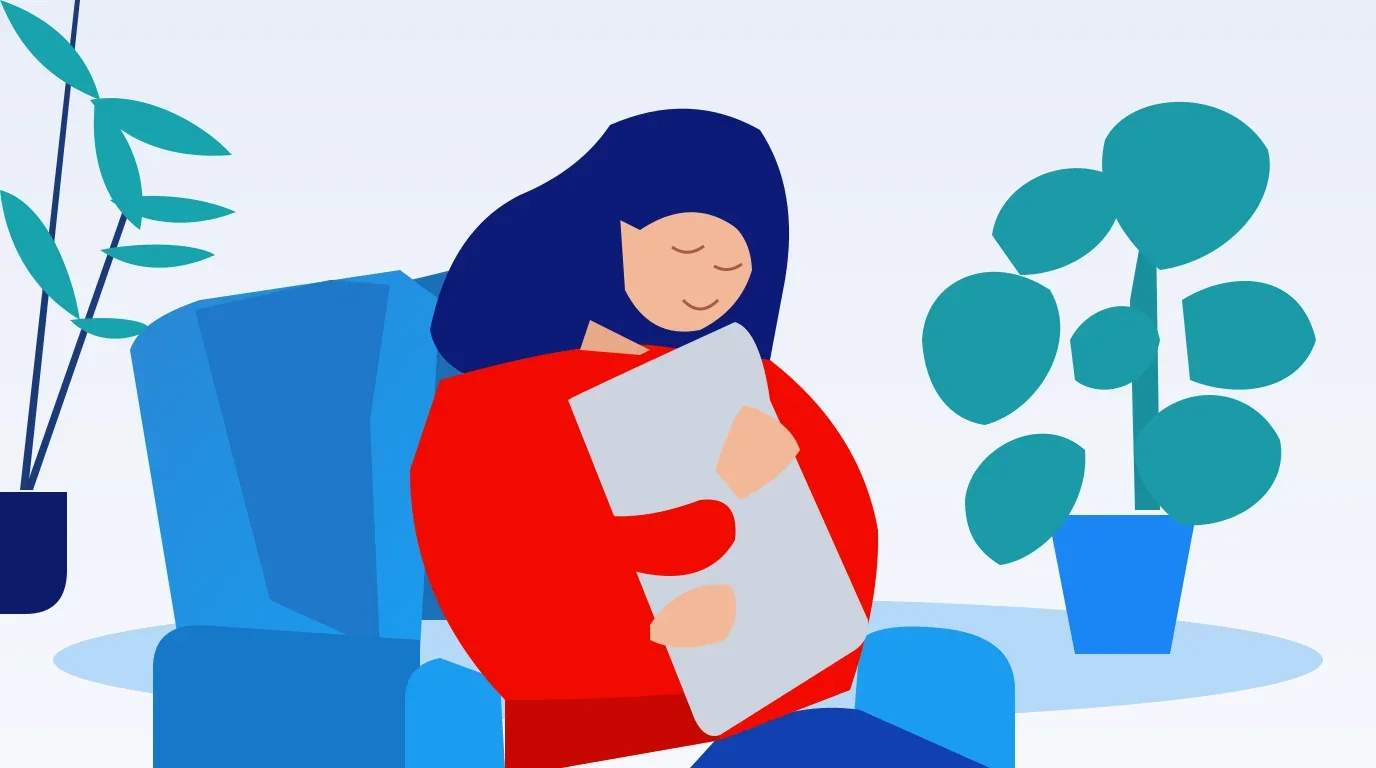
#16 Claude Sonnet 5.5 · medium
31.0 Punteggio $0.23 2.2 min non superata Ciclo fisso
-
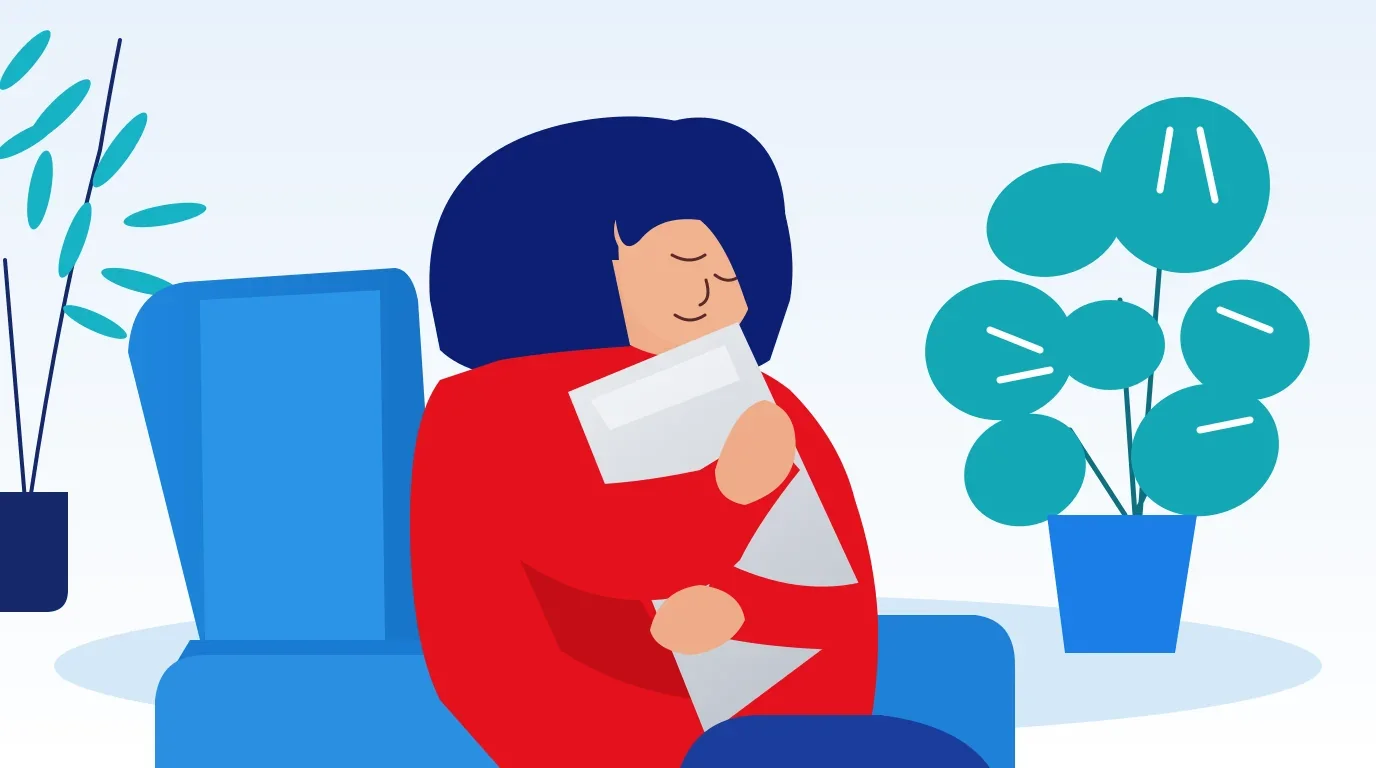
#17 Claude Haiku 5.5 · medium
32.6 Punteggio $0.00 0.6 min non superata Single-shot
-
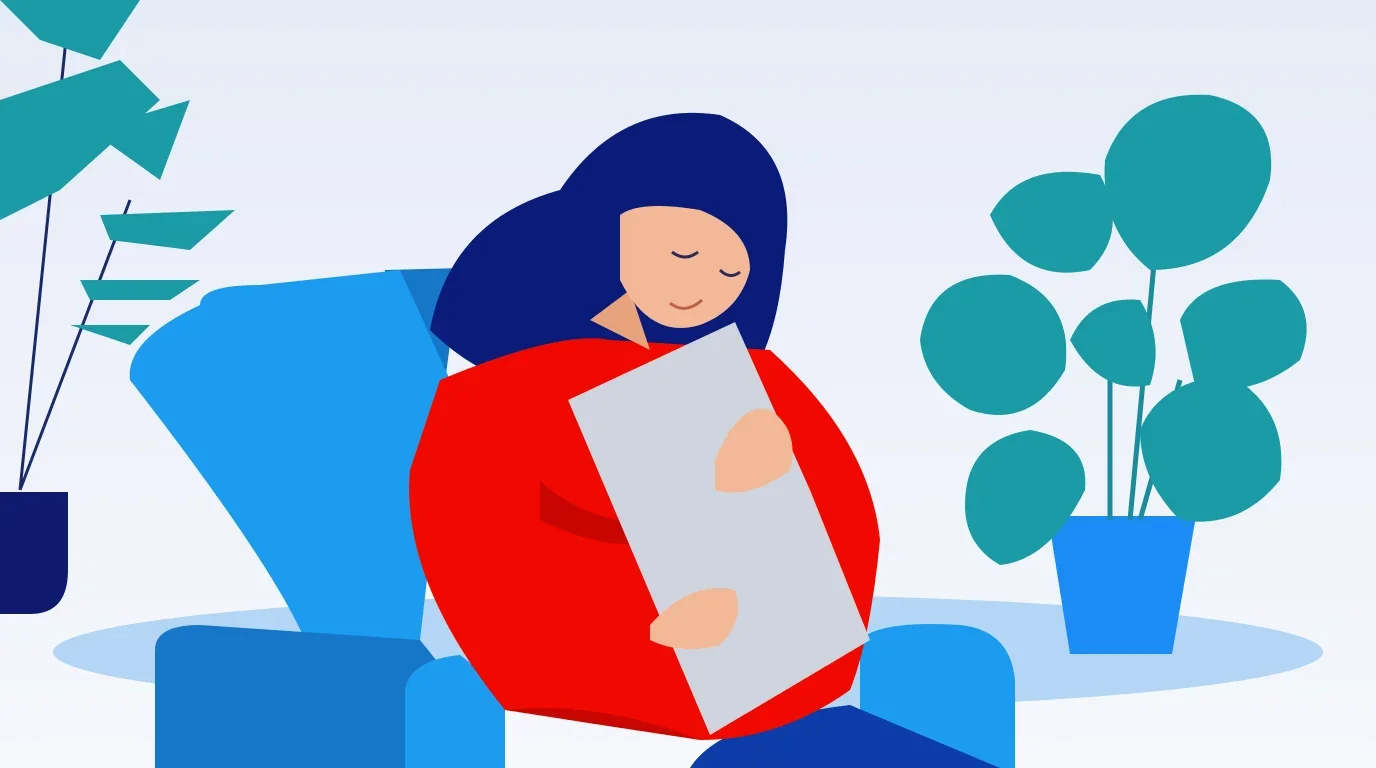
#18 Claude Sonnet 5.5 · medium
30.1 Punteggio $0.04 0.5 min non superata Single-shot
-
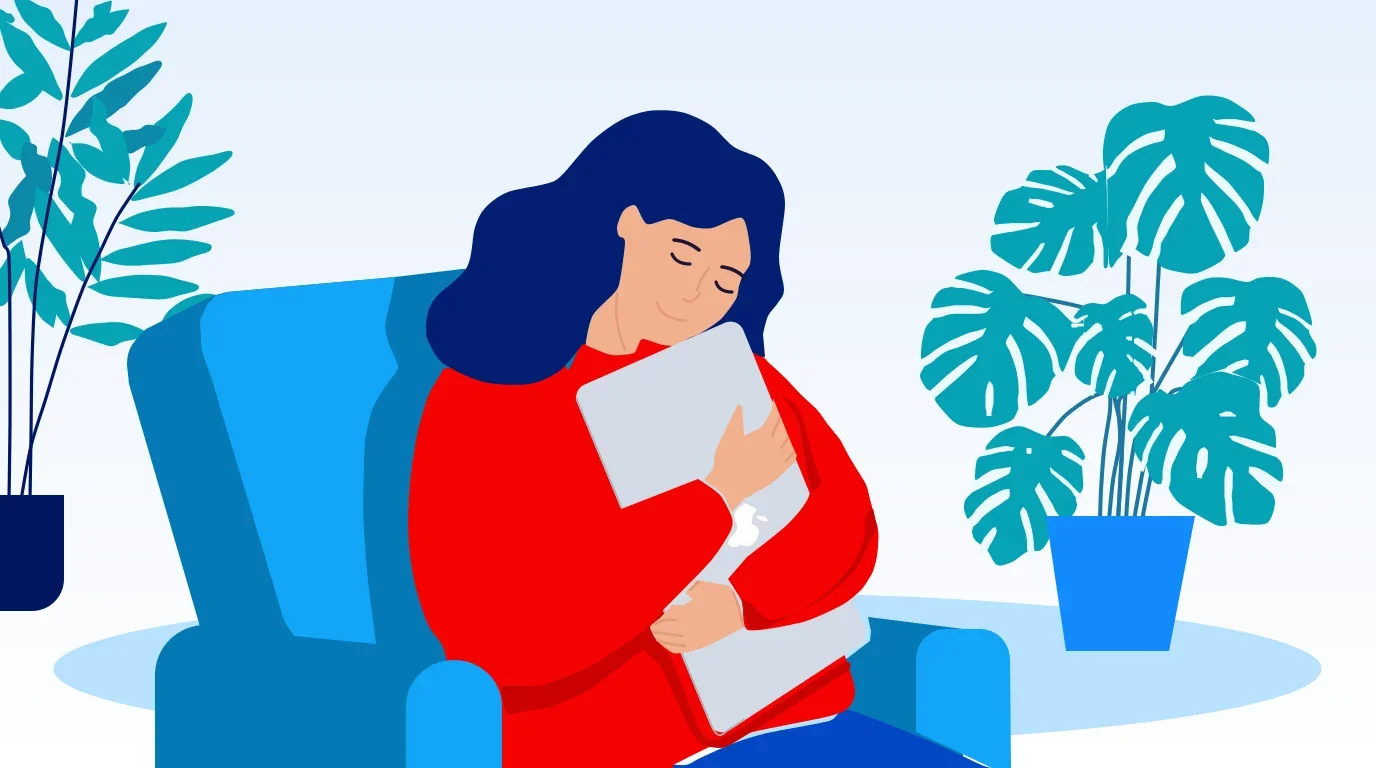
Claude Fable 5.1 · xhigh Parziale: 1 di 2 immagini
63.1 Punteggio $42.9 88 min non superata Agentico
-
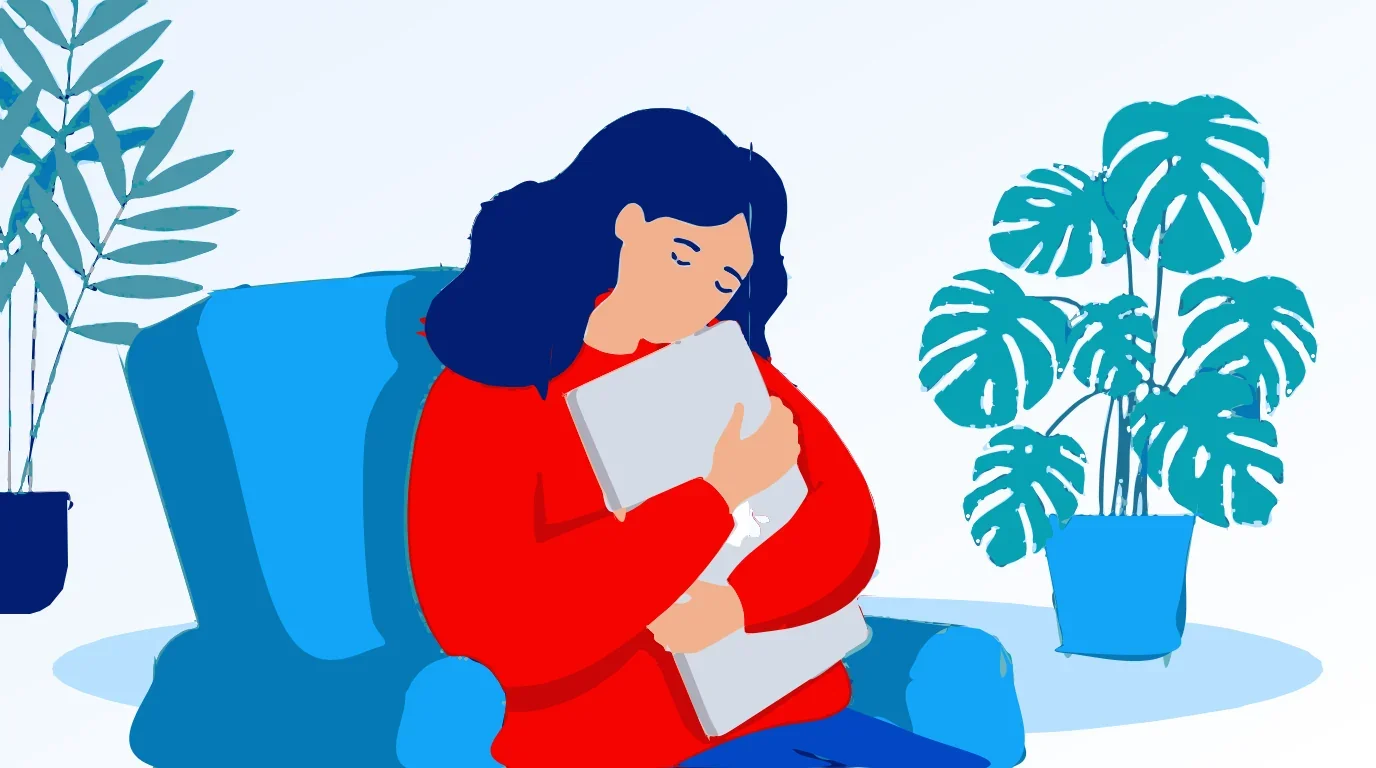
Gemini 3.1 Pro · max Parziale: 1 di 2 immagini
46.7 Punteggio $1.6 11 min superata Agentico
Originale contro Claude Opus 5.5 · max
Originale Claude Opus 5.5 · max Ritagli ingranditi
Viso
Mani
Struttura nel dettaglio
I controlli automatici di struttura per partecipante, modelli e strumenti insieme. Un trattino è un controllo che questa edizione non ha eseguito.
Come funziona un'esecuzione del benchmark?
Ogni partecipante riceve lo stesso prompt congelato e le stesse immagini, secondo il protocollo 1.0.1. Un'esecuzione è una sessione nuova nell'agente del fornitore, con il prompt come unico input e nessun messaggio intermedio. L'esecuzione itera finché la soglia di parità è superata e la revisione dei dettagli è pulita, oppure finché raggiunge il limite di tre ore o 25 cicli valutati, e poi lascia il suo stato migliore.
- Un agente per fornitore, dichiarato. I modelli Claude girano in Claude Code 2.1.291 (Haiku 5.5 nella 2.1.294, la prima versione che conosce il modello), GPT 6.1 Sol in Codex CLI 0.160.0 sul fast tier, Gemini in Gemini CLI 0.62.0 con una chiave API. Si misura il modello insieme al suo agente, e la classifica nomina entrambi.
- Le esecuzioni interrotte vengono scartate e ripetute. Un'esecuzione fermata dall'esterno (limite d'uso, processo terminato, errore di rete) non viene valutata, e il suo costo non compare da nessuna parte. La ripetizione prende il numero successivo.
- I sub-agenti sono ammessi dove l'agente li offre. I loro token contano, e il dataset registra che l'esecuzione ha delegato.
- Una macchina, un toolkit. Tutte le esecuzioni agentiche girano sullo stesso Mac, e il toolkit di valutazione è fissato tramite hash e non cambia mai durante un'edizione.
Quali sono le quattro categorie?
La categoria dice come un partecipante ha prodotto il suo SVG. Il grafico disegna ogni categoria con un proprio simbolo, e la classifica la mostra in una colonna.
| Categoria | Come nasce l'SVG | Chi ne fa parte |
|---|---|---|
| Agentica | Il modello lavora nell'agente del suo fornitore, scrive ed esegue codice, renderizza e confronta il suo SVG e itera entro i limiti. | Claude Fable, Opus e Sonnet, GPT 6.1 Sol e Gemini 3.1 Pro; Claude Haiku e l'ibrido Sol + Opus arrivano con un aggiornamento |
| Chiamata singola | Una chiamata con immagine e prompt, senza strumenti. La risposta è l'SVG. | Claude Opus, Sonnet, Fable e Haiku, GPT 6.1 Sol |
| Ciclo fisso | Quattro cicli in cui il modello vede il suo render e il riscontro di parità e riscrive l'SVG, senza strumenti. Conta il ciclo migliore. | Claude Opus 5.5 e Sonnet 5.5 |
| Strumento | L'output di uno strumento di vettorializzazione, valutato come ogni altro SVG. | Recraft Vectorize, Quiver AI Arrow 2 e Arrow 2 Telos, vtracer |
Quali immagini compongono la suite?
Due illustrazioni create con Samsa, una per livello di difficoltà. Ognuna ha un inventario: l'elenco degli oggetti che una vettorializzazione completa deve contenere, scritto da Samsa e congelato per l'edizione.
- Laptop, livello 1 (piatto): campiture piatte, nessuna texture, forme organiche sovrapposte, un volto e delle mani. 1376 × 768 pixel, 32 oggetti in inventario.
- E-bike, livello 2 (con texture): grana pellicola, puntinato, sfumature, 56 raggi, un volto, parti nascoste dietro la gamba lontana e la pedivella. 2400 × 1792 pixel, 53 oggetti in inventario.
- Una scena di livello 3 è prevista per un'edizione successiva.
Come viene valutata un'esecuzione?
Ogni esecuzione riceve tre punteggi parziali da 0 a 100, combinati nel Samsa Vectorization Score. Il valore di un partecipante per immagine è la mediana delle sue esecuzioni, la posizione complessiva la media di queste mediane. Un partecipante misurato su una sola immagine compare come parziale, senza posizione complessiva. Costo e tempo sono assi accanto al punteggio, mai dentro.
| Parte | Peso | Che cosa misura |
|---|---|---|
| Fedeltà | 50 % | Differenza di colore media, somiglianza strutturale, la peggiore finestra locale e, sulla e-bike, la corrispondenza della grana, rispetto all'originale, entrambe le immagini su fondo bianco. La soglia di parità a otto criteri compare come badge e non entra nel punteggio. |
| Struttura | 35 % | 60 % automatica: livelli con un nome, copertura dell'inventario, completezza delle forme nascoste ed economia dei tracciati, con penalità per immagini raster incorporate, tracciati di ritaglio che simulano l'occlusione e trasformazioni fissate. 40 % giudicata: significato degli oggetti, completezza sotto occlusione, modificabilità, ordine dei livelli e qualità dei tracciati. |
| Dettaglio | 15 % | Due ingrandimenti standard per immagine (volto e mani sul laptop, volto e trasmissione sulla e-bike), giudicati rispetto allo stesso ingrandimento dell'originale per somiglianza e cura. |
Le parti giudicate vengono da due modelli di visione di fornitori diversi, Claude Opus 5.5 e GPT 6.1 Sol, che vedono output anonimizzati e mescolati. I loro prompt sono pubblicati con i risultati.
Come si contano costo e tempo?
- Il costo è un equivalente API: i token di un'esecuzione per classe (input, output compreso il ragionamento, scrittura e lettura della cache), moltiplicati per il prezzo di listino del fornitore nel giorno dell'esecuzione. Il listino usato è salvato con ogni esecuzione (6 ottobre 2026). È quanto costerebbe l'esecuzione tramite API, non una fattura.
- Le esecuzioni Codex sul fast tier registrano il costo fast tier e l'equivalente standard. Haiku 5.5 è calcolato per richiesta sulle sue due tariffe legate alla lunghezza del prompt.
- Uno strumento conta al suo prezzo pubblicato per conversione, e il suo tempo viene da una prova cronometrata.
- Il tempo è il tempo reale dall'avvio dell'agente al suo rapporto finale.
- Le righe con più esecuzioni mostrano la mediana e l'intervallo. Una riga con una sola esecuzione mostra solo il valore, perché un'esecuzione non ha variazione.
Che cosa è cambiato con il protocollo 1.0.1?
Gli output con una tela diversa dall'originale ora si allineano in base al contenuto, non alla cornice. Il sistema di valutazione renderizza l'SVG, prende il riquadro di ciò che ha disegnato, lo porta sul riquadro del contenuto dell'originale con un'unica scala e completa con trasparenza. Se le proporzioni dei due riquadri differiscono di oltre il 10 %, si adatta l'intera tela. La regola vale per tutti i partecipanti. È stata introdotta perché gli export di Quiver AI hanno un margine di circa il 2,4 % che con la vecchia regola costava loro quasi tutta la fedeltà: un difetto di inquadratura, non di vettorializzazione.
Quali sono i limiti?
- Due immagini. La classifica dice come i partecipanti gestiscono un'illustrazione piatta e una con texture, non foto, loghi o disegni tecnici.
- Modello più agente. Ogni modello gira nell'agente del suo fornitore, quindi l'agente fa parte della misura. Potrà seguire una categoria indipendente dall'agente.
- Esecuzioni singole dove indicato. Claude Fable 5.1 con xhigh e Claude Opus 5.5 con max sono riferimenti con un'esecuzione per immagine, per il loro costo, e anche i livelli di effort più bassi sono stati eseguiti una volta. Gemini 3.1 Pro è stato eseguito una volta, sul laptop, con un tetto API di 20 $. Claude Opus 5.5 con effort high ha per ora due esecuzioni per immagine, e Claude Sonnet 5.5 con xhigh due sulla e-bike; le terze esecuzioni sono in corso e saranno aggiunte con un aggiornamento. Claude Fable 5.1 con effort xhigh non ha ancora un'esecuzione sulla e-bike: è stata interrotta da un limite d'uso, scartata secondo il protocollo e sarà ripetuta per l'aggiornamento.
- Il controllo di completezza da solo premia pochi oggetti grandi, ed è così che disegna Arrow 2 Telos. Il punteggio di struttura nel suo insieme mette comunque i file ricostruiti davanti a Telos e Telos davanti ai tracciati, ma leggi quel punteggio parziale tenendone conto.
- I giudici sono modelli. Vedono output anonimizzati e i loro prompt sono pubblicati, ma non sono designer. Samsa controlla a mano gli ingrandimenti prima della pubblicazione.
- Samsa usa modelli di Anthropic, e uno dei due giudici è un modello di OpenAI. Il punteggio di fedeltà e la metà automatica del punteggio di struttura non hanno bisogno di un giudice, e ogni metrica grezza è pubblicata perché il risultato si possa verificare.
Come posso proporre un modello o uno strumento?
Esegui il prompt congelato su entrambe le immagini secondo il protocollo, oppure, per uno strumento, manda gli SVG delle due immagini con il prezzo e una prova cronometrata. Samsa li valuta con lo stesso toolkit e li aggiunge nel prossimo aggiornamento. Scrivici per proporne uno.
Registro delle modifiche
-
Edizione pubblicata.
Domande frequenti: benchmark vettorializzazione
Che cosa misura il benchmark vettorializzazione?
Un solo compito: trasformare un'illustrazione raster in un SVG che un designer può modificare. Ogni esecuzione viene valutata sulla fedeltà all'originale (50 %), sulla struttura, cioè livelli con un nome, completi ed economici (35 %), e sul dettaglio dei punti chiave come volti e mani (15 %). La somma ponderata è il Samsa Vectorization Score. Costo e tempo per immagine stanno accanto e non lo cambiano mai.
Quale AI vettorializza meglio un'illustrazione?
Nell'edizione 2026.10 è in testa Claude Opus 5.5 con effort max con 82.1, davanti a Claude Sonnet 5.5 con effort xhigh (79.5). GPT 6.1 Sol con effort xhigh ha ottenuto 73.9 a una frazione del costo. Tutte le configurazioni di testa hanno lavorato come agente che renderizza e corregge il proprio SVG; nessun prompt singolo, a nessun modello, ci si è avvicinato.
Un solo prompt a un modello AI può trasformare un'immagine in un SVG modificabile?
Non alla parità, in questo benchmark. Le chiamate singole a modelli Claude e GPT hanno restituito in pochi minuti SVG puliti e con nomi chiari, per pochi centesimi o circa un dollaro. Ma nessuna delle 48 esecuzioni a chiamata singola o a ciclo fisso ha superato la soglia di parità: sono versioni stilizzate dell'immagine, non copie. Mostrare al modello il suo render per quattro cicli non ha chiuso il divario. La parità ha richiesto un agente che misura e corregge.
Perché gli strumenti di tracciatura hanno un punteggio basso se il loro SVG sembra giusto?
Perché sembrare giusto è solo metà del lavoro. Un tracciatore divide l'immagine in forme piatte per colore: sulla e-bike vtracer ha prodotto 9328 forme senza nome. La fedeltà è alta, ma nessuna forma è un oggetto e mancano tutte le parti nascoste. Il punteggio di struttura, il 35 % del totale, misura proprio ciò che serve a un designer per modificare il file, e lì i tracciatori perdono quasi tutto.
Come conta il benchmark costo e tempo?
Il costo sono i token di un'esecuzione moltiplicati per il prezzo di listino del fornitore nel giorno dell'esecuzione, per classe di token, con il listino salvato insieme all'esecuzione. È un equivalente API, non una fattura. Uno strumento conta al suo prezzo pubblicato per conversione. Il tempo va dall'avvio al rapporto finale. Entrambi sono mediane sulle esecuzioni di un partecipante, con l'intervallo quando ce n'è più di una.
Il benchmark vettorializzazione è indipendente?
Nessun benchmark condotto da un'azienda è del tutto indipendente, e Samsa usa modelli di Anthropic. Lo rendono verificabile: un prompt congelato per tutti, la valutazione automatica della fedeltà, due giudici di fornitori diversi su output anonimizzati, i prompt dei giudici pubblicati e ogni metrica grezza pubblicata con la sua esecuzione. Chiunque può ripetere il protocollo e confrontare.
Posso proporre un modello o uno strumento?
Sì. Esegui il prompt congelato su entrambe le immagini secondo il protocollo, oppure manda gli SVG di uno strumento per le due immagini con il prezzo e una prova cronometrata. Samsa valuta la proposta con lo stesso toolkit e la aggiunge nel prossimo aggiornamento. Usa la pagina dei contatti per scriverci.
Ogni quanto viene aggiornato il benchmark?
Quando esce un modello o uno strumento rilevante. Le righe si aggiungono e non si modificano mai: un partecipante misurato di nuovo riceve una nuova edizione, i listini restano con le loro esecuzioni, e il registro delle modifiche di questa pagina data ogni cambiamento. Claude Haiku 5.5, uscito mentre le esecuzioni dell'edizione 2026.10 erano in corso, è entrato così.
Crea immagini per il tuo brand ed esportale in SVG
Il generatore di immagini di Samsa impara il tuo brand. Scarica le immagini come SVG a livelli e passale ai tuoi designer.