Samsa Samsa

Immagini coerenti con il brand: prompt, immagine di riferimento o modello addestrato?

Ci sono tre modi per ottenere immagini IA coerenti con il tuo brand. Il prompt descrive il look a parole: veloce, ma ogni risultato è una nuova interpretazione. L’immagine di riferimento mostra all’IA un esempio da seguire per una singola generazione. Il tuo modello addestrato impara uno stile, un prodotto, una persona o una scena da un’immagine (ne consigliamo da due a cinque) e lo mantiene costante per tutto il team. La maggior parte dei team li combina.

Che cosa significa «coerente con il brand» per un’immagine IA?

Un’immagine IA è coerente con il brand quando ciò che rende riconoscibile il tuo marchio esce uguale in ogni immagine. Prima di scegliere un metodo, quindi, chiediti che cosa deve restare costante. La risposta rientra in una di due categorie.

  • Un look. I tuoi colori, un certo tipo di luce, foto o illustrazione, un’atmosfera. Un look si può descrivere: parole e immagini di esempio ti portano già lontano.
  • Un’identità. Qualcosa di preciso che si deve riconoscere: il tuo stile di illustrazione, il tuo prodotto con la sua confezione, una persona in particolare, il tuo negozio o il tuo ufficio. Un’identità deve corrispondere, non solo somigliare.

Nel lavoro di tutti i giorni servono quasi sempre entrambi. Un visual di campagna con il tuo prodotto, in linea con la tua immagine coordinata, richiede il look (colori, luce) e due identità (il prodotto e lo stile di illustrazione). Tieni a mente questa distinzione: è qui che i tre approcci si separano. Samsa offre tutti e tre gli approcci, e questa guida li mette a confronto, compreso quando un modello addestrato è troppo.

Perché un generatore generico si allontana dal tuo brand? Un modello generico sa com’è fatta una bottiglia d’acqua, non com’è fatta la tua. Alcuni ricercatori hanno descritto questo limite nel 2022: i grandi modelli testo-immagine producevano immagini varie e di alta qualità a partire da un prompt, ma non sapevano riprodurre l’aspetto di un soggetto preciso partendo da una serie di immagini di riferimento. In più, le parole sono uno strumento grossolano per definire un’immagine. Un articolo di ricerca del 2023 sui prompt visivi lo dice chiaramente: ottenere l’immagine desiderata con il solo prompt testuale è molto difficile e spesso richiede un prompt engineering complesso.

Approccio 1: fin dove arriva un prompt?

Un prompt ti dà un look coerente, a patto che il look si possa mettere in parole e che tutto il team lo scriva allo stesso modo. È il modo più rapido per cominciare e non richiede alcuna preparazione.

Che cosa può fissare un prompt?

Tutto ciò che si può descrivere: il soggetto, l’inquadratura, la luce, l’atmosfera, uno stile con un nome preciso come «illustrazione vettoriale piatta» o «fotografia reportage dai toni caldi». In un generatore di immagini IA pensato per i brand, alcune funzioni rendono il prompt meno fragile. In Samsa salvi una volta i colori del brand (primario, secondario e d’accento) e li selezioni quando generi, invece di ribattere ogni volta i codici colore. Un migliora-prompt trasforma un’idea breve in una descrizione dettagliata dell’immagine. E puoi scrivere il prompt in italiano, tedesco, francese o inglese, cosa utile per un team diviso tra Lugano, Zurigo e Ginevra.

Dove si ferma il prompt?

Ogni generazione è una nuova interpretazione delle tue parole. Per un’atmosfera va bene, per tutto ciò che è preciso è un problema. Descrivi il tuo prodotto e il modello ne inventa uno plausibile. Descrivi la tua CEO e ottieni una sconosciuta plausibile. Lancia due volte lo stesso prompt e i dettagli si spostano.

Il secondo limite è il team. Dieci persone scrivono dieci versioni dello stesso prompt e tornano indietro dieci look leggermente diversi. Finché ci si affida solo al prompt, la coerenza dipende da come scrive ciascuno, non dallo strumento.

Come rendere i prompt più coerenti?

Mettetevi d’accordo su un modello di prompt comune. Sei campi coprono la maggior parte delle immagini di brand:

Un modello di prompt condiviso per le immagini di brand
CampoChe cosa decide il team
SoggettoChe cosa c’è nell’immagine, in una frase
StileFoto o illustrazione, e di che tipo: reportage, studio, vettoriale piatto
LuceMomento della giornata, dura o morbida, calda o fredda
InquadraturaTaglio, distanza della camera, dove resta spazio per un titolo
ColoriLa palette del brand, o i colori del brand salvati nello strumento
Da evitareCiò che non deve mai comparire: loghi di terzi, testo nell’immagine, un colore fuori palette

Ideale per: esplorare idee, immagini singole, sfondi e scene generiche, e ogni brief senza un prodotto, una persona o un luogo ricorrente.

Approccio 2: che cosa aggiunge un’immagine di riferimento?

Un’immagine di riferimento mostra all’IA che cosa intendi invece di descriverlo, una generazione alla volta. Alleghi un’immagine esistente al prompt e il risultato ne segue il look, i colori o la composizione.

Due tipi di immagini di esempio

In questa guida, un’immagine di riferimento è un’immagine che dai all’IA al momento della generazione, per un solo risultato. Le immagini con cui addestri un modello sono immagini di addestramento. Alcune pagine di prodotto, compresa la pagina di addestramento di Samsa, chiamano anche le immagini di addestramento «immagini di riferimento»; lì intendono il secondo tipo.

Che cosa cattura un’immagine di riferimento?

Ciò che è difficile dire a parole: una palette precisa, la grana di una foto, l’equilibrio di un layout. L’articolo del 2023 che presenta un metodo per i prompt visivi cita il vecchio detto secondo cui un’immagine vale più di mille parole. È tutto il senso di questo approccio: se hai già un visual di campagna che funziona, mostrarlo è meglio che descriverlo.

Dove si ferma un’immagine di riferimento?

  • Guida un risultato, non impara niente. La generazione successiva riparte da zero, a meno che tu non alleghi di nuovo l’immagine.
  • Nel team, il risultato dipende dall’immagine che sceglie ciascuno. Due persone, due riferimenti, due look.
  • Orienta verso un esempio, ma non insegna al modello il tuo prodotto. Se un prodotto o un volto deve essere riconoscibile in ogni immagine, l’approccio 3 è lo strumento giusto.
  • Ti servono i diritti sull’immagine. Carica solo immagini che ti appartengono o di cui hai la licenza.

In Samsa caricare le tue immagini non costa crediti. Puoi usarle come riferimento, modificarle o crearne delle varianti.

Ideale per: riprendere un visual di campagna esistente e creare varianti singole di un’immagine che hai già. È anche la risposta rapida se vuoi un’immagine IA partendo da una tua foto, una volta sola. Se il soggetto di quella foto deve tornare ancora e ancora, continua a leggere.

Approccio 3: che cosa mantiene costante un modello addestrato?

Un modello addestrato mantiene uguale in ogni immagine un elemento preciso: uno stile, un prodotto, una persona o una scena. Gli mostri una volta qualche immagine di quell’elemento e da quel momento chiunque nel tuo team può inserirlo in una nuova immagine chiamandolo per nome.

L’idea non è nuova. L’articolo DreamBooth del 2022 ha mostrato che, affinando un modello testo-immagine preaddestrato su poche immagini di un soggetto, il modello riesce a creare nuove immagini fotorealistiche di quel soggetto in scene diverse. Da allora modelli e metodi sono cambiati, il principio no: l’identità si impara, non si descrive.

Quali modelli puoi addestrare?

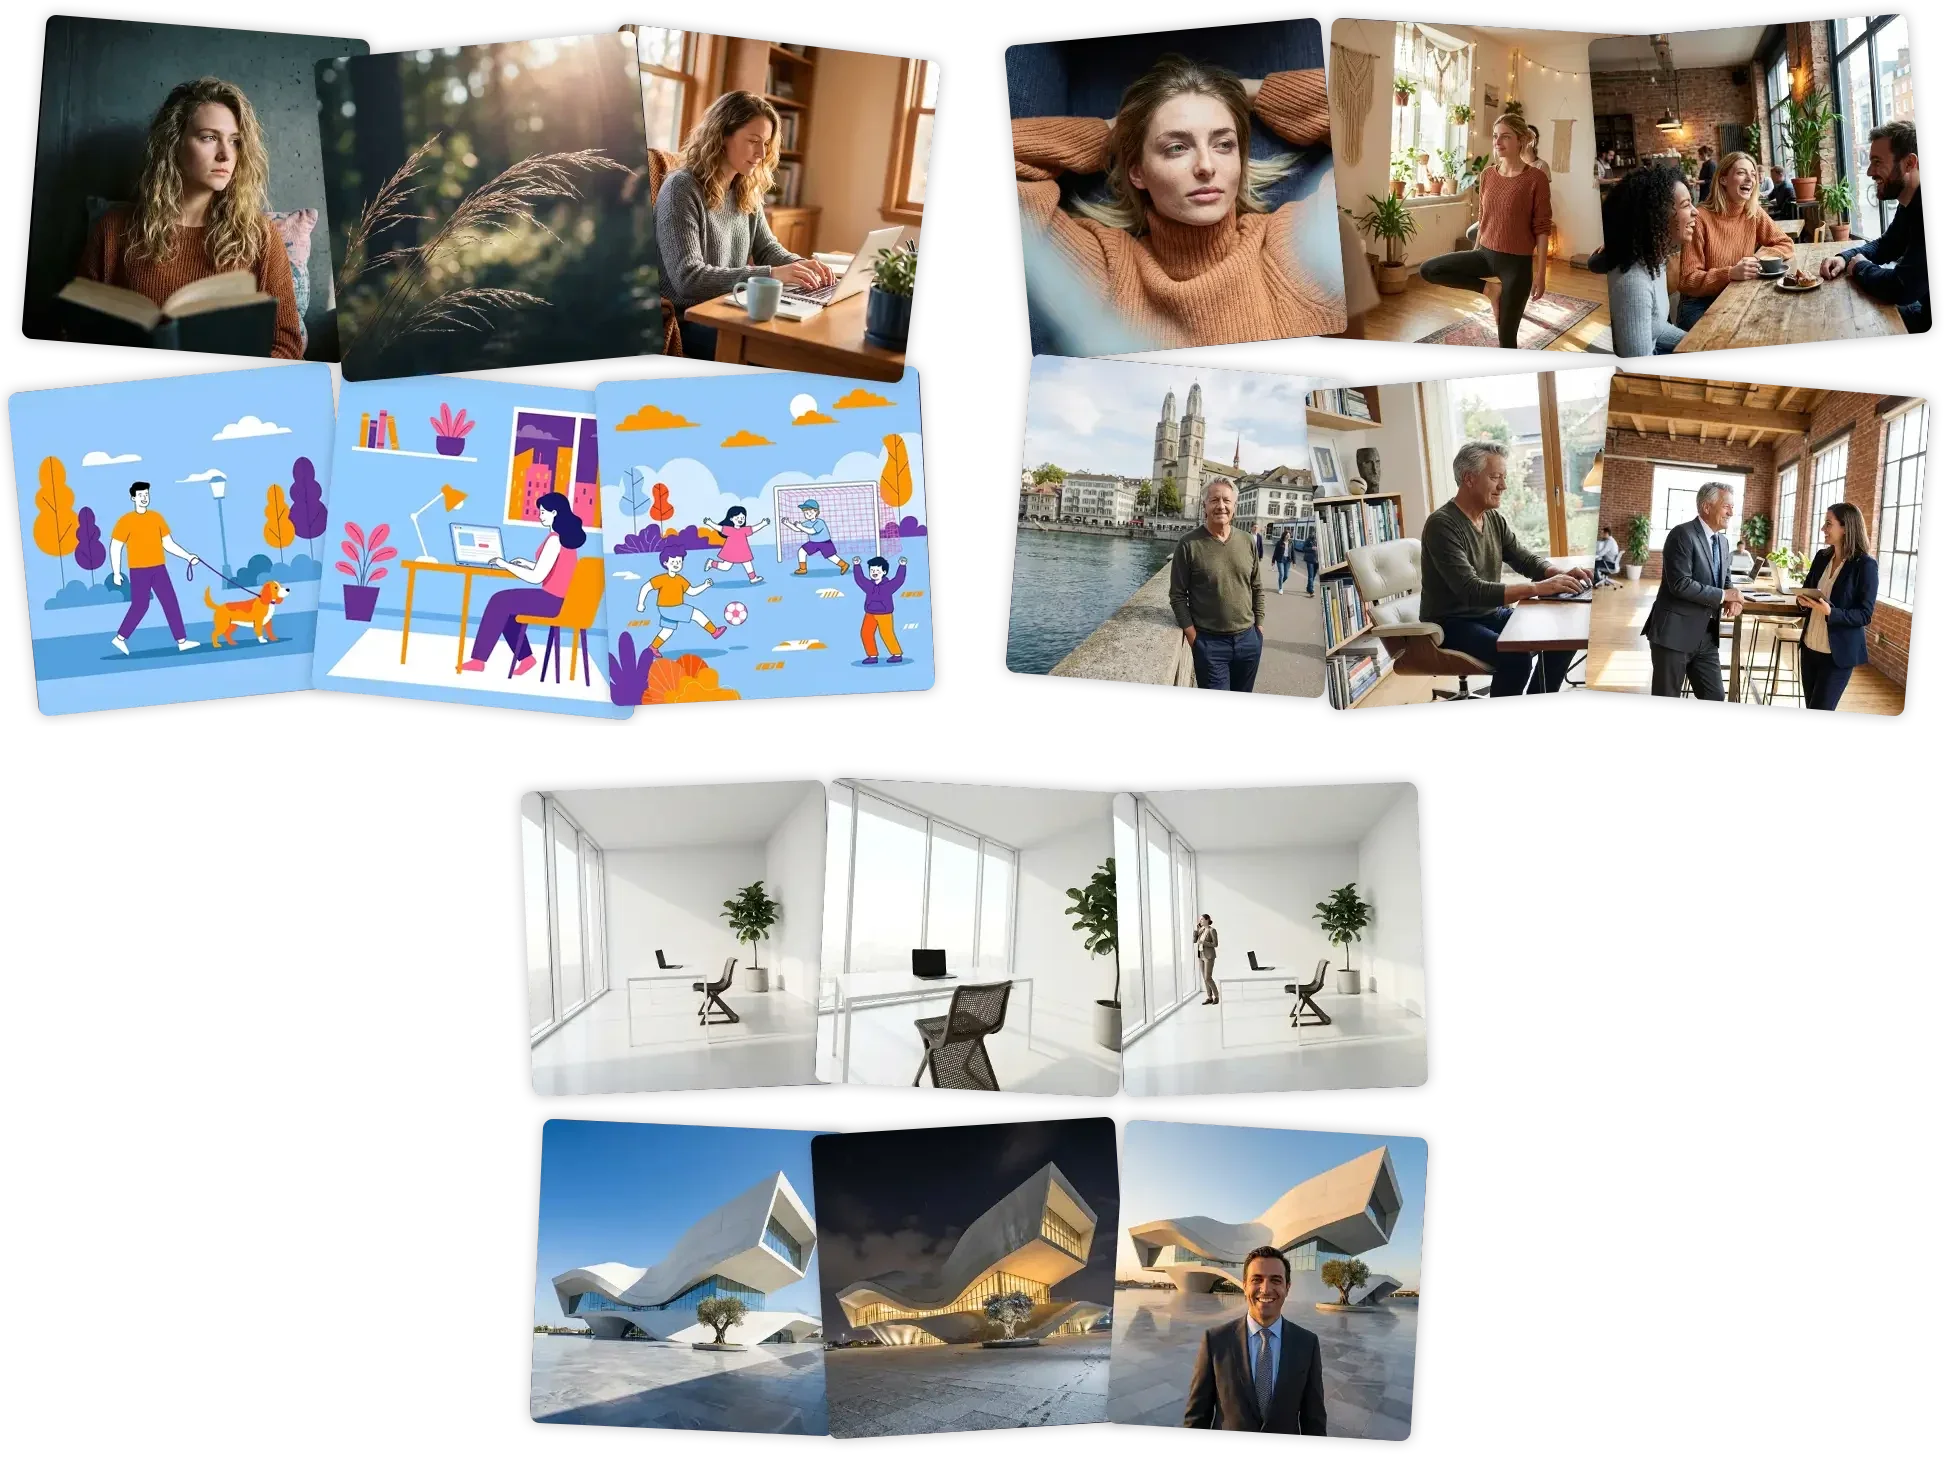
Samsa addestra quattro tipi di modello, uno per ogni tipo di identità che un brand ripete:

  • Stile: uno stile di illustrazione, un linguaggio fotografico o un design system.
  • Prodotti: una bottiglia, una confezione, un apparecchio.
  • Persone: una fondatrice, un ambassador o un personaggio del brand.
  • Scene: il tuo ufficio, il tuo negozio o un altro luogo che fa parte del tuo brand.
Sei immagini in due stili, due persone mostrate ciascuna in tre ambienti, un ufficio e un edificio in più varianti
Esempi dalla pagina di addestramento di Samsa, tutti generati con Samsa: due stili (in alto a sinistra), due persone (in alto a destra) e due scene (in basso). Ogni identità resta riconoscibile da un’immagine all’altra.

Che cosa ti serve per addestrare un modello IA?

Un’immagine basta per addestrare un modello; ne consigliamo da due a cinque, per ogni tipo di modello. Scegli immagini in cui il prodotto, la persona, lo stile o il luogo si vedono bene, perché il modello impara ciò che mostrano le immagini di addestramento. Per un prodotto, un modello di prodotto da una sola foto è un punto di partenza realistico. Nella checklist per preparare le immagini di addestramento trovi quali immagini scegliere per ogni tipo di modello e che cosa controllare prima di caricarle.

In Samsa l’addestramento richiede circa 15 secondi, e l’addestramento è gratuito e illimitato in ogni piano. Generare immagini con il modello consuma crediti, come ogni altra generazione.

Fine-tuning e LoRA

Incontrerai entrambi i termini appena ti informi sui modelli personalizzati. Il fine-tuning significa continuare ad addestrare un modello esistente sulle tue immagini. LoRA (Low-Rank Adaptation) viene da un articolo del 2021 sui modelli linguistici: congela i pesi del modello di partenza e addestra invece un piccolo numero di parametri aggiunti, riducendo di molto ciò che va addestrato. Sono tecniche generali, non una descrizione di come Samsa addestra i suoi modelli.

Puoi combinare più modelli in un’unica immagine?

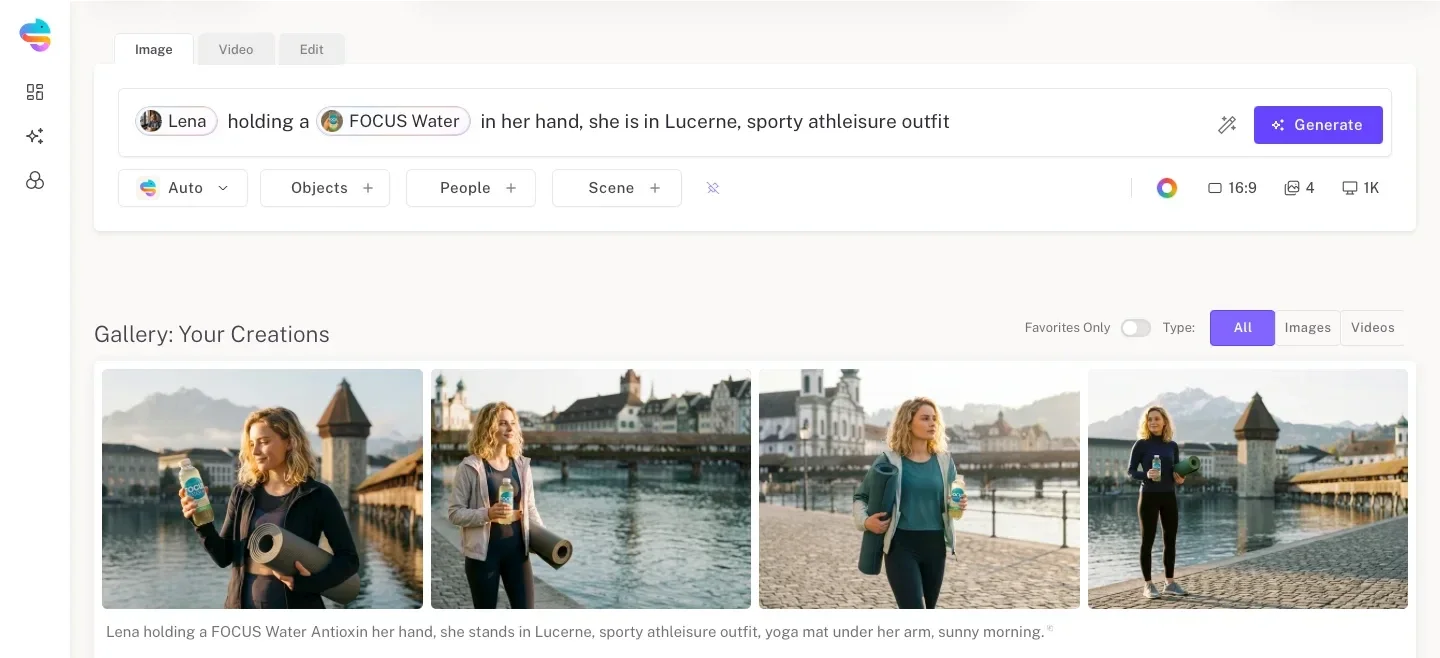
Sì. Con i Model References citi più modelli addestrati in un solo prompt, per esempio una persona, un prodotto e uno stile, e questi si ritrovano in un’unica generazione. Lo screenshot qui sotto mostra un prompt che nomina un modello di persona e un modello di prodotto. Tutti e quattro i risultati mostrano la stessa donna con la stessa bottiglia, in quattro inquadrature diverse a Lucerna.

Prompt di Samsa che nomina un modello di persona e uno di prodotto, sopra quattro immagini generate della stessa donna con la stessa bottiglia a Lucerna
Due modelli addestrati in un prompt: la persona e il prodotto restano gli stessi, posa e inquadratura cambiano. Screenshot dell’app Samsa; la persona e tutte e quattro le immagini sono generate con Samsa.

Chi può usare un modello addestrato?

Chiunque nel team vi abbia accesso. È qui che un modello addestrato supera gli altri due approcci: l’identità sta nel modello, non nel modo di scrivere o nella scelta del riferimento di ciascuno. Lo stagista e la art director partono dallo stesso prodotto e dallo stesso stile. Samsa si descrive come un’IA che impara il tuo branding e crea immagini e video coerenti, senza bisogno di competenze di design. Se il tuo problema è un prodotto, un volto o uno stile che torna di continuo, addestra modelli IA sul tuo brand.

Quando un modello addestrato è troppo?

Un modello addestrato è troppo quando non deve tornare niente di preciso. Lascia perdere l’addestramento se uno di questi casi descrive il tuo lavoro:

  • Ti serve un’immagine, una volta, per un singolo post o una slide.
  • Il look appartiene a una sola campagna e cambierà la prossima stagione.
  • Stai ancora esplorando direzioni e non sai ancora che cosa vuoi.
  • Nel brief non ci sono prodotti, persone, luoghi o stili di illustrazione ricorrenti.
  • Produci da solo una manciata di immagini all’anno.

In questi casi un buon prompt, magari con un’immagine di riferimento, fa il lavoro, e un modello sarebbe solo una cosa in più da curare.

L’obiezione ovvia: se l’addestramento è gratuito, perché non addestrare comunque? Perché i crediti non sono l’unico costo. Qualcuno deve scegliere le immagini di addestramento, controllare i primi risultati e riaddestrare quando il prodotto o lo stile cambiano. Questo impegno ripaga quando lo stesso prodotto, volto o stile ricompare settimana dopo settimana. Per una singola immagine no.

Del resto Samsa è pensata per un pubblico preciso: i team di marketing e branding che producono visual di brand ogni settimana. Se crei qualche immagine all’anno per un progetto personale, non ti serve un modello addestrato, e probabilmente nemmeno Samsa.

Come si confrontano i tre approcci?

In una frase: il prompt fissa un look, l’immagine di riferimento un esempio per un solo risultato, e il modello addestrato uno stile, un prodotto, una persona o una scena precisi per tutto il team.

Prompt, immagine di riferimento e modello addestrato a confronto
CriterioPromptImmagine di riferimentoModello addestrato
Che cosa dai all’IAParole, più i colori del brandUn’immagine di esempio per generazioneUn’immagine per l’addestramento (consigliate da due a cinque)
Che cosa resta costanteUn look descrittoIl look o la composizione dell’esempio, per quel solo risultatoUno stile, un prodotto, una persona o una scena precisi
Nel teamDipende da come scrive ciascunoDipende dall’immagine che sceglie ciascunoLo stesso modello per tutti
PreparazioneNessunaNessuna, ma ti servono i diritti sull’immagineCirca 15 secondi di addestramento in Samsa; gratuito e illimitato in ogni piano
Ideale perEsplorazione, immagini singole, scene genericheRiprendere un visual esistenteElementi di brand ricorrenti, produzione settimanale
Dove si inceppaUn prodotto o un volto preciso viene reinventato ogni voltaNon impara niente; un risultato alla voltaTroppo per immagini singole e look di breve durata

Leggi la tabella per righe, non per colonne. Se la riga che conta per te è «Nel team», la risposta è il modello addestrato. Se è «Preparazione», parti da un prompt e vedi fin dove arrivi.

Quale approccio scegliere? Il test in quattro domande

Rispondi alle quattro domande in ordine e fermati alla prima che risolve la questione.

  1. Deve tornare un prodotto, una persona, un luogo o uno stile di illustrazione preciso? No: scrivi un prompt e aggiungi i colori del brand. Sì: passa alla domanda 2.
  2. Una volta, o ancora e ancora? Una volta: usa un’immagine di riferimento. Ancora e ancora: passa alla domanda 3.
  3. Più persone creeranno queste immagini? Sì: addestra un modello, così tutti partono dallo stesso. No, ma il soggetto torna spesso: un modello ti evita comunque di rispiegare la stessa cosa in ogni prompt.
  4. Più elementi del brand devono stare in un’unica immagine? Addestra un modello per ciascuno e combinali in un solo prompt.

L’errore più comune che vedo nei team: cercano di far entrare il loro stile di brand in prompt sempre più lunghi. Un prompt descrive un look, ma non lo ricorda. Appena due persone del team generano immagini, il brand appare doppio. Se ti servono immagini per lo stesso brand ogni settimana, addestra lo stile una volta. Basta già una sola immagine di riferimento, e con due-cinque diventa davvero buono. E se ti serve solo un’immagine ogni tanto, con una buona immagine di riferimento spesso arrivi più lontano che con un modello tuo.

Niklas Jung, Fondatore e CEO, Samsa

La maggior parte dei team di brand risponde sì alla prima domanda almeno per una parte del lavoro. Per questo la risposta onesta raramente è un solo approccio.

Come combinano i team i tre approcci nella pratica?

Nella pratica gli approcci si sovrappongono. I modelli addestrati portano le identità, il prompt porta la situazione, i colori del brand portano la palette, e un’immagine di riferimento orienta una singola composizione quando serve.

Prendi una richiesta tipica: il tuo prodotto sul tavolino di un bar, nel tuo stile di illustrazione, per un post sui social. Il modello di prodotto e il modello di stile fanno sì che siano proprio la tua bottiglia e il tuo stile. Il prompt dice: tavolino di un bar, luce del mattino, spazio per un titolo in alto. La palette salvata tiene i colori dentro il brand. E se il post deve riprendere il layout del mese scorso, alleghi quel post come riferimento, solo per questa immagine.

Ogni livello fa un solo lavoro, e per questo resta semplice. Nessuno deve descrivere il prodotto a parole, nessuno deve cercare un riferimento solo per azzeccare i colori. È la differenza tra immagini e video IA coerenti con il brand come routine e immagini riuscite per caso.

Che cosa devi sapere su diritti ed etichettatura IA?

Puoi usare commercialmente le immagini generate con Samsa in ogni piano, a condizione di detenere i diritti sulle immagini di addestramento. La stessa attenzione vale per le immagini di riferimento: carica solo immagini che ti appartengono o di cui hai la licenza, e chiedi il consenso a una persona reale prima di addestrare un modello su di lei.

Samsa contrassegna le immagini generate con le Content Credentials C2PA e una filigrana invisibile, così restano riconoscibili come generate dall’IA. Le esportazioni vettoriali (SVG) non sono ancora coperte da questa marcatura.

Domande frequenti: immagini coerenti con il brand

Quante immagini servono per addestrare un modello di brand?

Un’immagine basta per addestrare un modello. Per risultati migliori usa da due a cinque buone immagini del prodotto, della persona, dello stile o della scena da mantenere costante. La regola vale per ogni tipo di modello. Scegli immagini in cui il soggetto si vede bene, perché il modello impara ciò che mostrano le immagini di addestramento.

L’addestramento di un modello ha un costo aggiuntivo?

No. In Samsa l’addestramento dei modelli è gratuito e illimitato in ogni piano, quindi puoi addestrare un modello per ogni prodotto, persona, stile o scena senza pagare per addestramento. Generare immagini con questi modelli consuma crediti, come ogni altra generazione. Creare l’account è gratuito, ma non ci sono crediti omaggio né periodi di prova. I dettagli sono nella pagina dei prezzi.

Posso combinare il mio prodotto, una persona e il mio stile in un’unica immagine?

Sì. Con i Model References di Samsa citi più modelli addestrati in un solo prompt, per esempio un prodotto, una persona e uno stile, e li combini in un’unica generazione. Ogni modello mantiene costante la sua parte, mentre il prompt descrive la scena intorno. È il modo abituale per costruire un visual di campagna con più elementi del brand.

Posso usare commercialmente le immagini generate con l’IA?

Sì, in ogni piano di Samsa, a condizione di detenere i diritti sulle immagini con cui hai addestrato i tuoi modelli. Se addestri su foto che non ti appartengono e di cui non hai la licenza, Samsa non può concederti i diritti di utilizzo commerciale. La stessa attenzione vale per le immagini di riferimento che carichi: usa immagini tue o che hai il diritto di usare.

Mi serve un modello addestrato per un’immagine singola?

Di solito no. Per un’immagine singola basta un prompt chiaro con i colori del brand, e un’immagine di riferimento aiuta se vuoi riprendere un visual esistente. Addestra un modello quando un prodotto, una persona, un luogo o uno stile preciso deve tornare in molte immagini, o quando più persone del team devono creare la stessa cosa.

Come creo immagini IA partendo da una mia foto?

In due modi. Usa la foto come immagine di riferimento se vuoi un solo risultato che ne segua il look o la composizione. Addestra un modello con la foto se il suo soggetto, per esempio il tuo prodotto o il tuo ufficio, deve ricomparire in molte nuove immagini. Una foto basta per addestrare un modello; ne consigliamo da due a cinque.

Addestra un modello su ciò che torna in tutte le tue immagini

Crea il tuo account (gratuito). L’addestramento è gratuito e illimitato in ogni piano; generare immagini consuma crediti.

Addestra il tuo primo modello

# Immagini coerenti con il brand: prompt, immagine di riferimento o modello addestrato?

> Prompt, immagine di riferimento o modello addestrato: come creare immagini IA coerenti con il brand, cosa tiene fermo ciascuno e quando addestrare è troppo.

Language: Italiano · Machine index: [https://samsa.ai/llms.txt](/llms.txt)

---

Ci sono tre modi per ottenere immagini IA coerenti con il tuo brand. Il prompt descrive il look a parole: veloce, ma ogni risultato è una nuova interpretazione. L’immagine di riferimento mostra all’IA un esempio da seguire per una singola generazione. Il tuo modello addestrato impara uno stile, un prodotto, una persona o una scena da un’immagine (ne consigliamo da due a cinque) e lo mantiene costante per tutto il team. La maggior parte dei team li combina.

Niklas Jung · Fondatore e CEO, Samsa Pubblicato il 2026-09-30 · 15 min di lettura

---

## Che cosa significa «coerente con il brand» per un’immagine IA?

Un’immagine IA è coerente con il brand quando ciò che rende riconoscibile il tuo marchio esce uguale in ogni immagine. Prima di scegliere un metodo, quindi, chiediti che cosa deve restare costante. La risposta rientra in una di due categorie.

- Un look. I tuoi colori, un certo tipo di luce, foto o illustrazione, un’atmosfera. Un look si può descrivere: parole e immagini di esempio ti portano già lontano.

- Un’identità. Qualcosa di preciso che si deve riconoscere: il tuo stile di illustrazione, il tuo prodotto con la sua confezione, una persona in particolare, il tuo negozio o il tuo ufficio. Un’identità deve corrispondere, non solo somigliare.

Nel lavoro di tutti i giorni servono quasi sempre entrambi. Un visual di campagna con il tuo prodotto, in linea con la tua immagine coordinata, richiede il look (colori, luce) e due identità (il prodotto e lo stile di illustrazione). Tieni a mente questa distinzione: è qui che i tre approcci si separano. Samsa offre tutti e tre gli approcci, e questa guida li mette a confronto, compreso quando un modello addestrato è troppo.

Perché un generatore generico si allontana dal tuo brand? Un modello generico sa com’è fatta una bottiglia d’acqua, non com’è fatta la tua. Alcuni ricercatori hanno descritto questo limite nel 2022: i grandi modelli testo-immagine producevano immagini varie e di alta qualità a partire da un prompt, ma non sapevano riprodurre l’aspetto di un soggetto preciso partendo da una serie di immagini di riferimento. In più, le parole sono uno strumento grossolano per definire un’immagine. Un articolo di ricerca del 2023 sui prompt visivi lo dice chiaramente: ottenere l’immagine desiderata con il solo prompt testuale è molto difficile e spesso richiede un prompt engineering complesso.

---

## Approccio 1: fin dove arriva un prompt?

Un prompt ti dà un look coerente, a patto che il look si possa mettere in parole e che tutto il team lo scriva allo stesso modo. È il modo più rapido per cominciare e non richiede alcuna preparazione.

### Che cosa può fissare un prompt?

Tutto ciò che si può descrivere: il soggetto, l’inquadratura, la luce, l’atmosfera, uno stile con un nome preciso come «illustrazione vettoriale piatta» o «fotografia reportage dai toni caldi». In un [generatore di immagini IA](/it/immagine/) pensato per i brand, alcune funzioni rendono il prompt meno fragile. In Samsa salvi una volta i colori del brand (primario, secondario e d’accento) e li selezioni quando generi, invece di ribattere ogni volta i codici colore. Un migliora-prompt trasforma un’idea breve in una descrizione dettagliata dell’immagine. E puoi scrivere il prompt in italiano, tedesco, francese o inglese, cosa utile per un team diviso tra Lugano, Zurigo e Ginevra.

### Dove si ferma il prompt?

Ogni generazione è una nuova interpretazione delle tue parole. Per un’atmosfera va bene, per tutto ciò che è preciso è un problema. Descrivi il tuo prodotto e il modello ne inventa uno plausibile. Descrivi la tua CEO e ottieni una sconosciuta plausibile. Lancia due volte lo stesso prompt e i dettagli si spostano.

Il secondo limite è il team. Dieci persone scrivono dieci versioni dello stesso prompt e tornano indietro dieci look leggermente diversi. Finché ci si affida solo al prompt, la coerenza dipende da come scrive ciascuno, non dallo strumento.

### Come rendere i prompt più coerenti?

Mettetevi d’accordo su un modello di prompt comune. Sei campi coprono la maggior parte delle immagini di brand:

**Un modello di prompt condiviso per le immagini di brand**

| Campo | Che cosa decide il team |

| --- | --- |

| Soggetto | Che cosa c’è nell’immagine, in una frase |

| Stile | Foto o illustrazione, e di che tipo: reportage, studio, vettoriale piatto |

| Luce | Momento della giornata, dura o morbida, calda o fredda |

| Inquadratura | Taglio, distanza della camera, dove resta spazio per un titolo |

| Colori | La palette del brand, o i colori del brand salvati nello strumento |

| Da evitare | Ciò che non deve mai comparire: loghi di terzi, testo nell’immagine, un colore fuori palette |

Ideale per: esplorare idee, immagini singole, sfondi e scene generiche, e ogni brief senza un prodotto, una persona o un luogo ricorrente.

---

## Approccio 2: che cosa aggiunge un’immagine di riferimento?

Un’immagine di riferimento mostra all’IA che cosa intendi invece di descriverlo, una generazione alla volta. Alleghi un’immagine esistente al prompt e il risultato ne segue il look, i colori o la composizione.

> **Due tipi di immagini di esempio** In questa guida, un’immagine di riferimento è un’immagine che dai all’IA al momento della generazione, per un solo risultato. Le immagini con cui addestri un modello sono immagini di addestramento. Alcune pagine di prodotto, compresa la pagina di addestramento di Samsa, chiamano anche le immagini di addestramento «immagini di riferimento»; lì intendono il secondo tipo.

### Che cosa cattura un’immagine di riferimento?

Ciò che è difficile dire a parole: una palette precisa, la grana di una foto, l’equilibrio di un layout. L’articolo del 2023 che presenta un metodo per i prompt visivi cita il vecchio detto secondo cui un’immagine vale più di mille parole. È tutto il senso di questo approccio: se hai già un visual di campagna che funziona, mostrarlo è meglio che descriverlo.

### Dove si ferma un’immagine di riferimento?

- Guida un risultato, non impara niente. La generazione successiva riparte da zero, a meno che tu non alleghi di nuovo l’immagine.

- Nel team, il risultato dipende dall’immagine che sceglie ciascuno. Due persone, due riferimenti, due look.

- Orienta verso un esempio, ma non insegna al modello il tuo prodotto. Se un prodotto o un volto deve essere riconoscibile in ogni immagine, l’approccio 3 è lo strumento giusto.

- Ti servono i diritti sull’immagine. Carica solo immagini che ti appartengono o di cui hai la licenza.

In Samsa caricare le tue immagini non costa crediti. Puoi usarle come riferimento, modificarle o crearne delle varianti.

Ideale per: riprendere un visual di campagna esistente e creare varianti singole di un’immagine che hai già. È anche la risposta rapida se vuoi un’immagine IA partendo da una tua foto, una volta sola. Se il soggetto di quella foto deve tornare ancora e ancora, continua a leggere.

---

## Approccio 3: che cosa mantiene costante un modello addestrato?

Un modello addestrato mantiene uguale in ogni immagine un elemento preciso: uno stile, un prodotto, una persona o una scena. Gli mostri una volta qualche immagine di quell’elemento e da quel momento chiunque nel tuo team può inserirlo in una nuova immagine chiamandolo per nome.

L’idea non è nuova. L’articolo DreamBooth del 2022 ha mostrato che, affinando un modello testo-immagine preaddestrato su poche immagini di un soggetto, il modello riesce a creare nuove immagini fotorealistiche di quel soggetto in scene diverse. Da allora modelli e metodi sono cambiati, il principio no: l’identità si impara, non si descrive.

### Quali modelli puoi addestrare?

Samsa addestra quattro tipi di modello, uno per ogni tipo di identità che un brand ripete:

- Stile: uno stile di illustrazione, un linguaggio fotografico o un design system.

- Prodotti: una bottiglia, una confezione, un apparecchio.

- Persone: una fondatrice, un ambassador o un personaggio del brand.

- Scene: il tuo ufficio, il tuo negozio o un altro luogo che fa parte del tuo brand.
*(image: Sei immagini in due stili, due persone mostrate ciascuna in tre ambienti, un ufficio e un edificio in più varianti)*

Esempi dalla pagina di addestramento di Samsa, tutti generati con Samsa: due stili (in alto a sinistra), due persone (in alto a destra) e due scene (in basso). Ogni identità resta riconoscibile da un’immagine all’altra.

### Che cosa ti serve per addestrare un modello IA?

Un’immagine basta per addestrare un modello; ne consigliamo da due a cinque, per ogni tipo di modello. Scegli immagini in cui il prodotto, la persona, lo stile o il luogo si vedono bene, perché il modello impara ciò che mostrano le immagini di addestramento. Per un prodotto, un [modello di prodotto da una sola foto](/it/fotografia-di-prodotto/) è un punto di partenza realistico. Nella [checklist per preparare le immagini di addestramento](https://samsa.ai/it/guide/addestrare-ia-con-le-proprie-immagini/) trovi quali immagini scegliere per ogni tipo di modello e che cosa controllare prima di caricarle.

In Samsa l’addestramento richiede circa 15 secondi, e [l’addestramento è gratuito e illimitato in ogni piano](/it/prezzi/). Generare immagini con il modello consuma crediti, come ogni altra generazione.

> **Fine-tuning e LoRA** Incontrerai entrambi i termini appena ti informi sui modelli personalizzati. Il fine-tuning significa continuare ad addestrare un modello esistente sulle tue immagini. LoRA (Low-Rank Adaptation) viene da un articolo del 2021 sui modelli linguistici: congela i pesi del modello di partenza e addestra invece un piccolo numero di parametri aggiunti, riducendo di molto ciò che va addestrato. Sono tecniche generali, non una descrizione di come Samsa addestra i suoi modelli.

### Puoi combinare più modelli in un’unica immagine?

Sì. Con i Model References citi più modelli addestrati in un solo prompt, per esempio una persona, un prodotto e uno stile, e questi si ritrovano in un’unica generazione. Lo screenshot qui sotto mostra un prompt che nomina un modello di persona e un modello di prodotto. Tutti e quattro i risultati mostrano la stessa donna con la stessa bottiglia, in quattro inquadrature diverse a Lucerna.
*(image: Prompt di Samsa che nomina un modello di persona e uno di prodotto, sopra quattro immagini generate della stessa donna con la stessa bottiglia a Lucerna)*

Due modelli addestrati in un prompt: la persona e il prodotto restano gli stessi, posa e inquadratura cambiano. Screenshot dell’app Samsa; la persona e tutte e quattro le immagini sono generate con Samsa.

### Chi può usare un modello addestrato?

Chiunque nel team vi abbia accesso. È qui che un modello addestrato supera gli altri due approcci: l’identità sta nel modello, non nel modo di scrivere o nella scelta del riferimento di ciascuno. Lo stagista e la art director partono dallo stesso prodotto e dallo stesso stile. Samsa si descrive come un’IA che impara il tuo branding e crea immagini e video coerenti, senza bisogno di competenze di design. Se il tuo problema è un prodotto, un volto o uno stile che torna di continuo, [addestra modelli IA sul tuo brand](/it/formare/).

---

## Quando un modello addestrato è troppo?

Un modello addestrato è troppo quando non deve tornare niente di preciso. Lascia perdere l’addestramento se uno di questi casi descrive il tuo lavoro:

- Ti serve un’immagine, una volta, per un singolo post o una slide.

- Il look appartiene a una sola campagna e cambierà la prossima stagione.

- Stai ancora esplorando direzioni e non sai ancora che cosa vuoi.

- Nel brief non ci sono prodotti, persone, luoghi o stili di illustrazione ricorrenti.

- Produci da solo una manciata di immagini all’anno.

In questi casi un buon prompt, magari con un’immagine di riferimento, fa il lavoro, e un modello sarebbe solo una cosa in più da curare.

L’obiezione ovvia: se l’addestramento è gratuito, perché non addestrare comunque? Perché i crediti non sono l’unico costo. Qualcuno deve scegliere le immagini di addestramento, controllare i primi risultati e riaddestrare quando il prodotto o lo stile cambiano. Questo impegno ripaga quando lo stesso prodotto, volto o stile ricompare settimana dopo settimana. Per una singola immagine no.

Del resto Samsa è pensata per un pubblico preciso: i team di marketing e branding che producono visual di brand ogni settimana. Se crei qualche immagine all’anno per un progetto personale, non ti serve un modello addestrato, e probabilmente nemmeno Samsa.

---

## Come si confrontano i tre approcci?

In una frase: il prompt fissa un look, l’immagine di riferimento un esempio per un solo risultato, e il modello addestrato uno stile, un prodotto, una persona o una scena precisi per tutto il team.

**Prompt, immagine di riferimento e modello addestrato a confronto**

| Criterio | Prompt | Immagine di riferimento | Modello addestrato |

| --- | --- | --- | --- |

| Che cosa dai all’IA | Parole, più i colori del brand | Un’immagine di esempio per generazione | Un’immagine per l’addestramento (consigliate da due a cinque) |

| Che cosa resta costante | Un look descritto | Il look o la composizione dell’esempio, per quel solo risultato | Uno stile, un prodotto, una persona o una scena precisi |

| Nel team | Dipende da come scrive ciascuno | Dipende dall’immagine che sceglie ciascuno | Lo stesso modello per tutti |

| Preparazione | Nessuna | Nessuna, ma ti servono i diritti sull’immagine | Circa 15 secondi di addestramento in Samsa; gratuito e illimitato in ogni piano |

| Ideale per | Esplorazione, immagini singole, scene generiche | Riprendere un visual esistente | Elementi di brand ricorrenti, produzione settimanale |

| Dove si inceppa | Un prodotto o un volto preciso viene reinventato ogni volta | Non impara niente; un risultato alla volta | Troppo per immagini singole e look di breve durata |

Leggi la tabella per righe, non per colonne. Se la riga che conta per te è «Nel team», la risposta è il modello addestrato. Se è «Preparazione», parti da un prompt e vedi fin dove arrivi.

---

## Quale approccio scegliere? Il test in quattro domande

Rispondi alle quattro domande in ordine e fermati alla prima che risolve la questione.

1. Deve tornare un prodotto, una persona, un luogo o uno stile di illustrazione preciso? No: scrivi un prompt e aggiungi i colori del brand. Sì: passa alla domanda 2.

2. Una volta, o ancora e ancora? Una volta: usa un’immagine di riferimento. Ancora e ancora: passa alla domanda 3.

3. Più persone creeranno queste immagini? Sì: addestra un modello, così tutti partono dallo stesso. No, ma il soggetto torna spesso: un modello ti evita comunque di rispiegare la stessa cosa in ogni prompt.

4. Più elementi del brand devono stare in un’unica immagine? Addestra un modello per ciascuno e combinali in un solo prompt.

> L’errore più comune che vedo nei team: cercano di far entrare il loro stile di brand in prompt sempre più lunghi. Un prompt descrive un look, ma non lo ricorda. Appena due persone del team generano immagini, il brand appare doppio. Se ti servono immagini per lo stesso brand ogni settimana, addestra lo stile una volta. Basta già una sola immagine di riferimento, e con due-cinque diventa davvero buono. E se ti serve solo un’immagine ogni tanto, con una buona immagine di riferimento spesso arrivi più lontano che con un modello tuo.

> — Niklas Jung, Fondatore e CEO, Samsa

La maggior parte dei team di brand risponde sì alla prima domanda almeno per una parte del lavoro. Per questo la risposta onesta raramente è un solo approccio.

---

## Come combinano i team i tre approcci nella pratica?

Nella pratica gli approcci si sovrappongono. I modelli addestrati portano le identità, il prompt porta la situazione, i colori del brand portano la palette, e un’immagine di riferimento orienta una singola composizione quando serve.

Prendi una richiesta tipica: il tuo prodotto sul tavolino di un bar, nel tuo stile di illustrazione, per un post sui social. Il modello di prodotto e il modello di stile fanno sì che siano proprio la tua bottiglia e il tuo stile. Il prompt dice: tavolino di un bar, luce del mattino, spazio per un titolo in alto. La palette salvata tiene i colori dentro il brand. E se il post deve riprendere il layout del mese scorso, alleghi quel post come riferimento, solo per questa immagine.

Ogni livello fa un solo lavoro, e per questo resta semplice. Nessuno deve descrivere il prodotto a parole, nessuno deve cercare un riferimento solo per azzeccare i colori. È la differenza tra [immagini e video IA coerenti con il brand](/it/) come routine e immagini riuscite per caso.

---

## Che cosa devi sapere su diritti ed etichettatura IA?

Puoi usare commercialmente le immagini generate con Samsa in ogni piano, a condizione di detenere i diritti sulle immagini di addestramento. La stessa attenzione vale per le immagini di riferimento: carica solo immagini che ti appartengono o di cui hai la licenza, e chiedi il consenso a una persona reale prima di addestrare un modello su di lei.

Samsa contrassegna le immagini generate con le Content Credentials C2PA e una filigrana invisibile, così restano riconoscibili come generate dall’IA. Le esportazioni vettoriali (SVG) non sono ancora coperte da questa marcatura.

---

## Domande frequenti: immagini coerenti con il brand

### Quante immagini servono per addestrare un modello di brand?

Un’immagine basta per addestrare un modello. Per risultati migliori usa da due a cinque buone immagini del prodotto, della persona, dello stile o della scena da mantenere costante. La regola vale per ogni tipo di modello. Scegli immagini in cui il soggetto si vede bene, perché il modello impara ciò che mostrano le immagini di addestramento.

### L’addestramento di un modello ha un costo aggiuntivo?

No. In Samsa l’addestramento dei modelli è gratuito e illimitato in ogni piano, quindi puoi addestrare un modello per ogni prodotto, persona, stile o scena senza pagare per addestramento. Generare immagini con questi modelli consuma crediti, come ogni altra generazione. Creare l’account è gratuito, ma non ci sono crediti omaggio né periodi di prova. I dettagli sono nella [pagina dei prezzi](/it/prezzi/).

### Posso combinare il mio prodotto, una persona e il mio stile in un’unica immagine?

Sì. Con i Model References di Samsa citi più modelli addestrati in un solo prompt, per esempio un prodotto, una persona e uno stile, e li combini in un’unica generazione. Ogni modello mantiene costante la sua parte, mentre il prompt descrive la scena intorno. È il modo abituale per costruire un visual di campagna con più elementi del brand.

### Posso usare commercialmente le immagini generate con l’IA?

Sì, in ogni piano di Samsa, a condizione di detenere i diritti sulle immagini con cui hai addestrato i tuoi modelli. Se addestri su foto che non ti appartengono e di cui non hai la licenza, Samsa non può concederti i diritti di utilizzo commerciale. La stessa attenzione vale per le immagini di riferimento che carichi: usa immagini tue o che hai il diritto di usare.

### Mi serve un modello addestrato per un’immagine singola?

Di solito no. Per un’immagine singola basta un prompt chiaro con i colori del brand, e un’immagine di riferimento aiuta se vuoi riprendere un visual esistente. Addestra un modello quando un prodotto, una persona, un luogo o uno stile preciso deve tornare in molte immagini, o quando più persone del team devono creare la stessa cosa.

### Come creo immagini IA partendo da una mia foto?

In due modi. Usa la foto come immagine di riferimento se vuoi un solo risultato che ne segua il look o la composizione. Addestra un modello con la foto se il suo soggetto, per esempio il tuo prodotto o il tuo ufficio, deve ricomparire in molte nuove immagini. Una foto basta per addestrare un modello; ne consigliamo da due a cinque.

---

## Fonti

1. [IP-Adapter: Text Compatible Image Prompt Adapter for Text-to-Image Diffusion Models](https://arxiv.org/abs/2308.06721) — arXiv, consultato il 2026-09-30

2. [DreamBooth: Fine Tuning Text-to-Image Diffusion Models for Subject-Driven Generation](https://arxiv.org/abs/2208.12242) — arXiv, consultato il 2026-09-30

3. [LoRA: Low-Rank Adaptation of Large Language Models](https://arxiv.org/abs/2106.09685) — arXiv, consultato il 2026-09-30

---

**Addestra un modello su ciò che torna in tutte le tue immagini** Crea il tuo account (gratuito). L’addestramento è gratuito e illimitato in ogni piano; generare immagini consuma crediti. [Addestra il tuo primo modello](/it/formare/)