Samsa.AI Samsa.AI

Images IA cohérentes avec sa marque : prompt, image de référence ou modèle entraîné ?

Trois approches mènent à des images IA cohérentes avec ta marque. Le prompt décrit le look avec des mots : rapide, mais chaque résultat est une nouvelle interprétation. L’image de référence montre à l’IA un exemple à suivre pour une seule génération. Ton propre modèle entraîné apprend un style, un produit, une personne ou une scène à partir d’une image (deux à cinq recommandées) et le garde constant pour toute ton équipe. La plupart des équipes combinent les trois.

Que veut dire « cohérent avec ta marque » pour une image IA ?

Une image IA est cohérente avec ta marque quand ce qui rend ta marque reconnaissable ressort à l’identique d’une image à l’autre. Avant de choisir une méthode, pose-toi donc une question : qu’est-ce qui doit rester constant ? La réponse tombe dans l’une de deux catégories.

  • Un look. Tes couleurs, un type de lumière, la photo ou l’illustration, une ambiance. Un look se décrit : les mots et les images d’exemple te mènent déjà loin.
  • Une identité. Un élément précis que l’on doit reconnaître : ton style d’illustration, ton produit avec son emballage, une personne en particulier, ta boutique ou ton bureau. Une identité doit correspondre, pas seulement ressembler.

Dans la pratique, il faut presque toujours les deux. Un visuel de campagne avec ton produit, conforme à ta charte graphique, demande le look (couleurs, lumière) et deux identités (le produit et le style d’illustration). Garde cette distinction en tête : c’est précisément là que les trois approches diffèrent. Samsa propose les trois, et ce guide les compare côte à côte, y compris pour savoir quand un modèle entraîné est de trop.

Pourquoi un générateur généraliste s’éloigne-t-il de ta marque ? Un modèle généraliste sait à quoi ressemble une bouteille d’eau, pas à quoi ressemble ta bouteille d’eau. Des chercheurs ont décrit ce manque dès 2022 : les grands modèles texte-image produisaient des images variées et de grande qualité à partir d’un prompt, mais ne savaient pas reproduire l’apparence d’un sujet précis à partir d’une série d’images de référence. Les mots, en plus, restent un outil grossier pour définir une image. Un article de recherche de 2023 sur les prompts visuels le dit sans détour : obtenir l’image voulue avec un simple prompt texte est très délicat et demande souvent un travail de prompt engineering complexe.

Approche 1 : jusqu’où va un prompt ?

Un prompt te donne un look cohérent, à condition que ce look se décrive avec des mots et que toute l’équipe le formule de la même façon. C’est le point de départ le plus rapide, sans aucune préparation.

Que peut fixer un prompt ?

Tout ce qui se décrit : le sujet, le cadrage, la lumière, l’ambiance, un style nommé comme « illustration vectorielle en aplats » ou « photo reportage chaleureuse ». Dans un générateur d’images IA pensé pour les marques, quelques fonctions rendent le prompt moins fragile. Dans Samsa, tu enregistres une fois tes couleurs de marque (principale, secondaire et d’accent) et tu les sélectionnes au moment de générer, au lieu de retaper des codes couleur. Un améliorateur de prompt transforme une idée courte en description d’image détaillée. Et tu peux écrire ton prompt en français, en allemand, en italien ou en anglais, ce qui simplifie la vie d’une équipe répartie entre Genève, Zurich et Lugano.

Où le prompt atteint-il ses limites ?

Chaque génération est une nouvelle interprétation de tes mots. Pour une ambiance, ça va ; pour tout ce qui est précis, c’est un problème. Décris ton produit, et le modèle invente un produit plausible. Décris ta directrice, et tu obtiens une inconnue plausible. Lance deux fois le même prompt, et les détails bougent.

La deuxième limite, c’est l’équipe. Dix personnes écrivent dix versions du même prompt, et dix looks légèrement différents reviennent. Tant qu’on ne fait que prompter, la cohérence dépend de la formulation de chacun, pas de l’outil.

Comment rendre tes prompts plus cohérents ?

Mettez-vous d’accord sur un modèle de prompt commun. Six champs couvrent la plupart des images de marque :

Un modèle de prompt partagé pour les images de marque
ChampCe que l’équipe fixe
SujetCe que montre l’image, en une phrase
StylePhoto ou illustration, et laquelle : reportage, studio, vectoriel en aplats
LumièreMoment de la journée, dure ou douce, chaude ou froide
CadragePlan, distance de la caméra, espace libre pour un titre
CouleursLa palette de la charte graphique, ou les couleurs de marque enregistrées dans l’outil
À éviterCe qui ne doit jamais apparaître : logos tiers, texte dans l’image, couleur hors charte

Idéal pour : explorer des idées, les images ponctuelles, les arrière-plans et scènes génériques, et tout brief sans produit, personne ou lieu récurrent.

Approche 2 : qu’apporte une image de référence ?

Une image de référence montre à l’IA ce que tu veux au lieu de le décrire, pour une génération à la fois. Tu joins une image existante à ton prompt, et le résultat s’inspire de son look, de ses couleurs ou de sa composition.

Deux sortes d’images d’exemple

Dans ce guide, une image de référence est une image que tu donnes à l’IA au moment de générer, pour un seul résultat. Les images sur lesquelles tu entraînes un modèle sont des images d’entraînement. Certaines pages produit, y compris la page d’entraînement de Samsa, appellent aussi les images d’entraînement « images de référence » ; elles parlent alors de la seconde sorte.

Que retient une image de référence ?

Ce qui se dit mal avec des mots : une palette précise, le grain d’une photo, l’équilibre d’une mise en page. L’article de 2023 qui présente une méthode de prompt visuel cite le vieil adage selon lequel une image vaut mille mots. C’est tout l’intérêt de cette approche : si tu as déjà un visuel de campagne qui fonctionne, le montrer vaut mieux que le décrire.

Où l’image de référence atteint-elle ses limites ?

  • Elle guide un résultat, rien n’est appris. La génération suivante repart de zéro, sauf si tu joins à nouveau l’image.
  • Dans une équipe, le résultat dépend de l’image choisie par chacun. Deux personnes, deux références, deux looks.
  • Elle oriente vers un exemple, sans apprendre ton produit au modèle. Si un produit ou un visage doit être reconnaissable sur chaque image, l’approche 3 est le meilleur outil.
  • Il te faut les droits sur l’image. Importe uniquement des images qui t’appartiennent ou dont tu as la licence.

Dans Samsa, importer tes propres images ne coûte aucun crédit. Tu peux t’en servir comme références, les retoucher ou en créer des variantes.

Idéal pour : reprendre un visuel de campagne existant et décliner ponctuellement un visuel que tu as déjà. C’est aussi la réponse rapide si tu te demandes comment générer une image IA à partir d’une autre image, pour un seul résultat. Si le sujet de cette image doit revenir encore et encore, lis la suite.

Approche 3 : que garde constant un modèle entraîné ?

Un modèle entraîné garde un élément précis identique sur chaque image : un style, un produit, une personne ou une scène. Tu lui montres une fois quelques images de cet élément, et ensuite n’importe qui dans ton équipe peut le placer dans une nouvelle image en l’appelant par son nom.

L’idée n’est pas nouvelle. L’article DreamBooth de 2022 a montré qu’en affinant un modèle texte-image pré-entraîné sur quelques images seulement d’un sujet, on peut générer de nouvelles images photoréalistes de ce sujet dans d’autres scènes. Les modèles et les méthodes ont évolué depuis, le principe reste : l’identité s’apprend, elle ne se décrit pas.

Quels modèles peux-tu entraîner ?

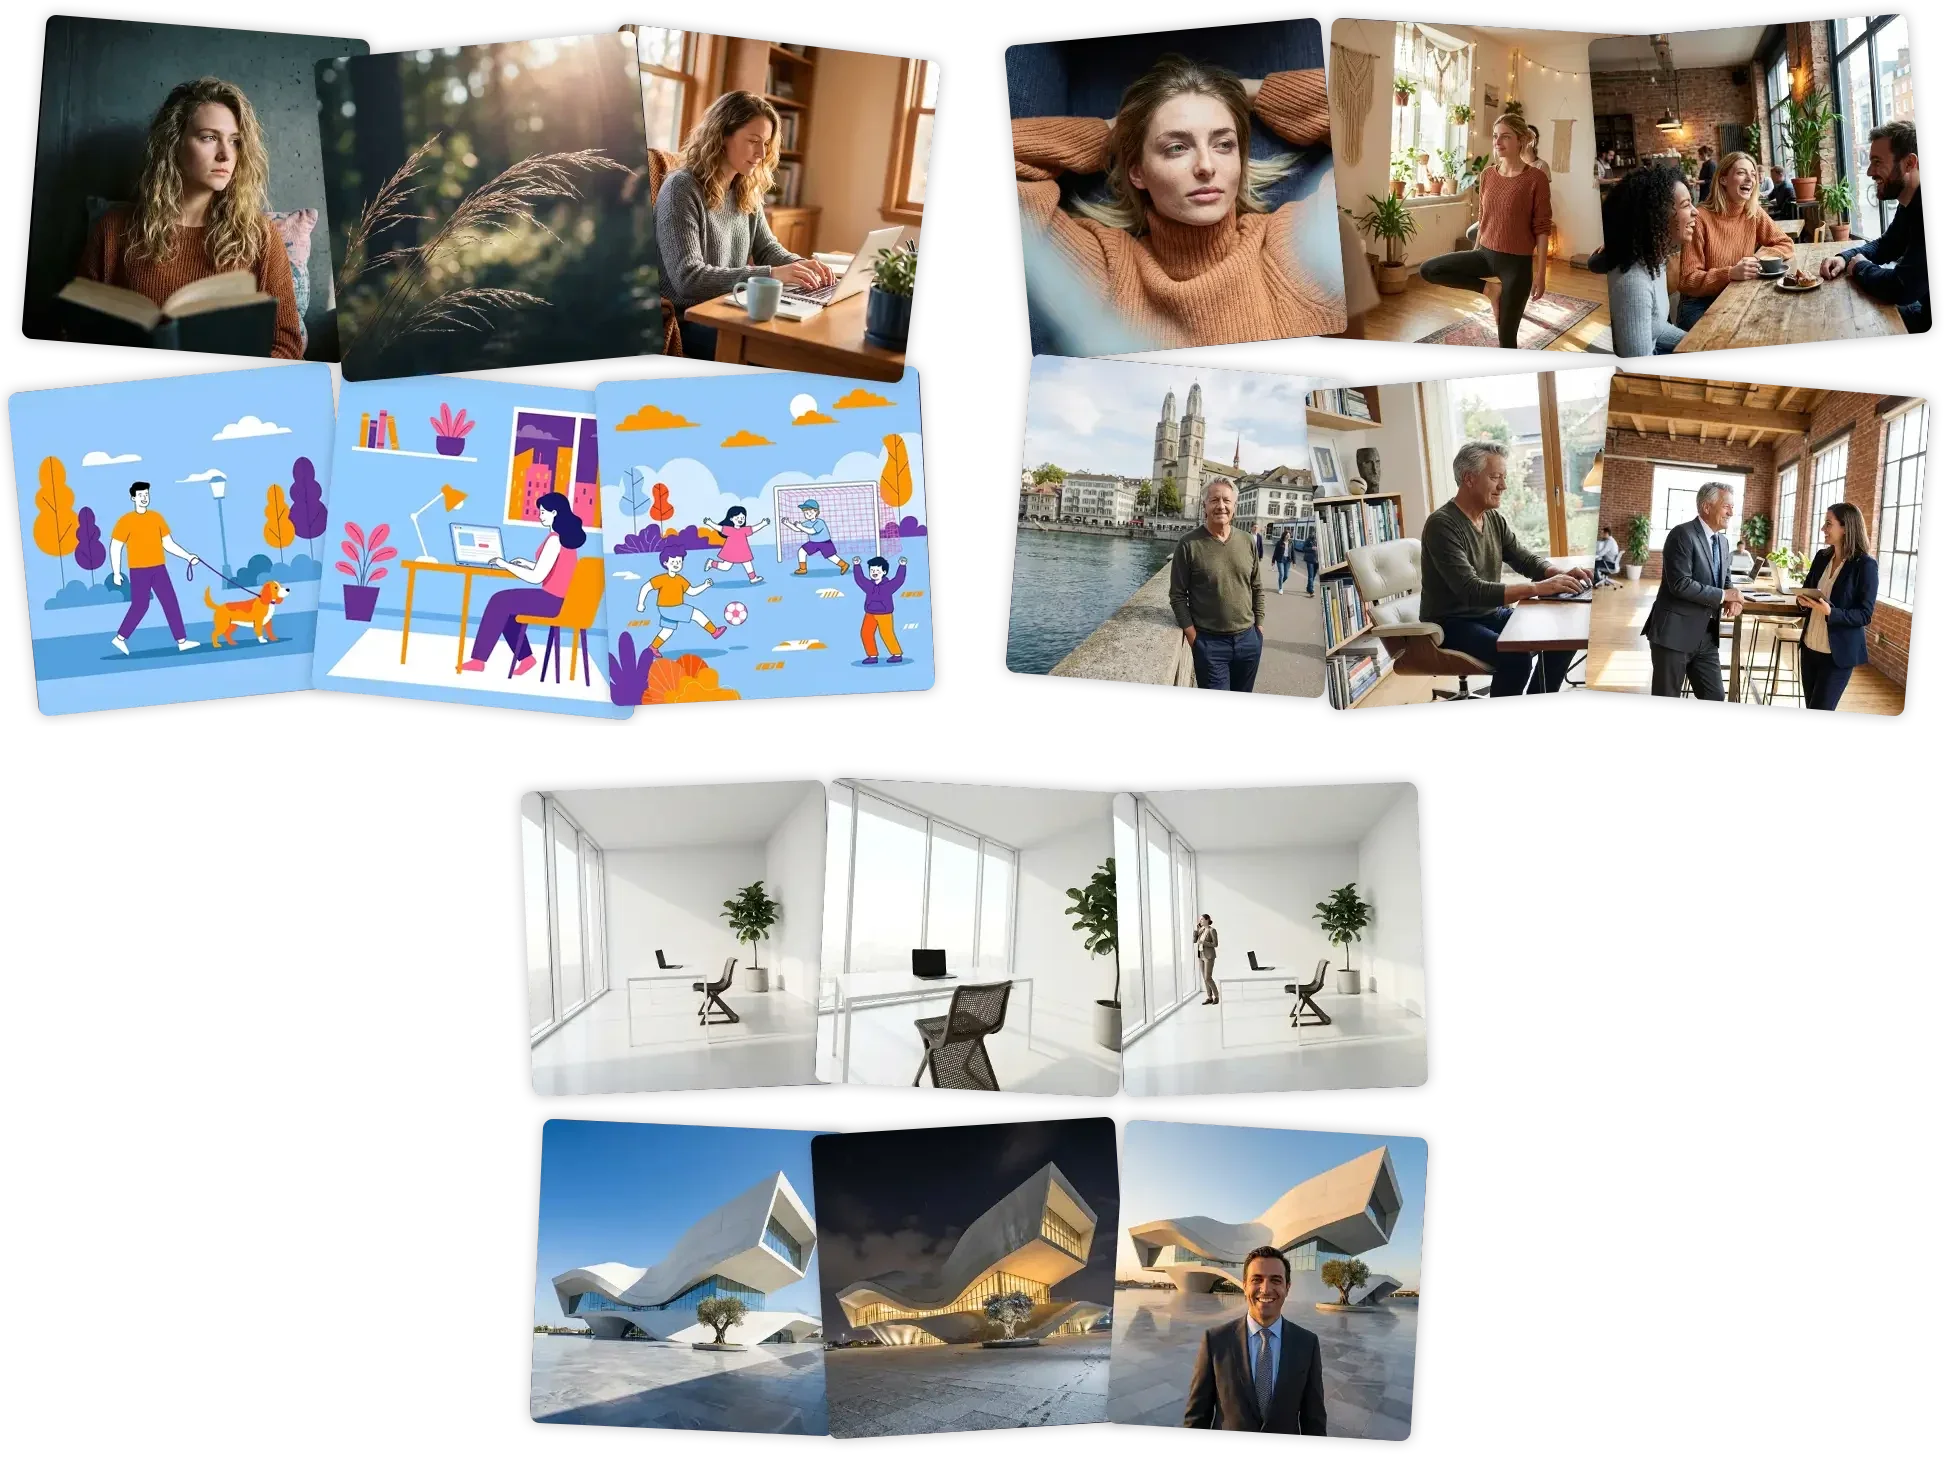
Samsa entraîne quatre types de modèles, un pour chaque sorte d’identité qu’une marque répète :

  • Style : un style d’illustration, une signature photo ou un design system.
  • Produits : une bouteille, un emballage, un appareil.
  • Personnes : une fondatrice, un ambassadeur ou une mascotte de marque.
  • Scènes : ton bureau, ta boutique ou un autre lieu qui fait partie de ta marque.
Six images dans deux styles, deux personnes montrées chacune dans trois décors, un bureau et un bâtiment en plusieurs variantes
Exemples de la page d’entraînement de Samsa, tous générés avec Samsa : deux styles (en haut à gauche), deux personnes (en haut à droite) et deux scènes (en bas). Chaque identité reste reconnaissable d’une image à l’autre.

De quoi as-tu besoin pour entraîner un modèle IA sur tes images ?

Une image suffit pour entraîner un modèle ; deux à cinq sont recommandées, quel que soit le type de modèle. Choisis des images où le produit, la personne, le style ou le lieu se voit bien, car le modèle apprend ce que montrent les images d’entraînement. Pour un produit, un modèle de produit à partir d’une seule photo est un point de départ réaliste. La checklist pour préparer tes images d’entraînement détaille les images qui conviennent à chaque type de modèle et ce qu’il faut vérifier avant de les importer.

Dans Samsa, l’entraînement prend environ 15 secondes, et l’entraînement est gratuit et illimité dans chaque formule. Générer des images avec le modèle consomme des crédits, comme toute autre génération.

Fine-tuning et LoRA

Tu croiseras ces deux termes dès que tu te renseignes sur les modèles personnalisés. Le fine-tuning consiste à poursuivre l’entraînement d’un modèle existant sur tes propres images. LoRA (Low-Rank Adaptation) vient d’un article de 2021 sur les modèles de langage : elle gèle les poids du modèle d’origine et entraîne à la place un petit nombre de paramètres ajoutés, ce qui réduit fortement ce qu’il faut entraîner. Ce sont des techniques générales, pas une description de la façon dont Samsa entraîne ses modèles.

Peux-tu combiner plusieurs modèles dans une seule image ?

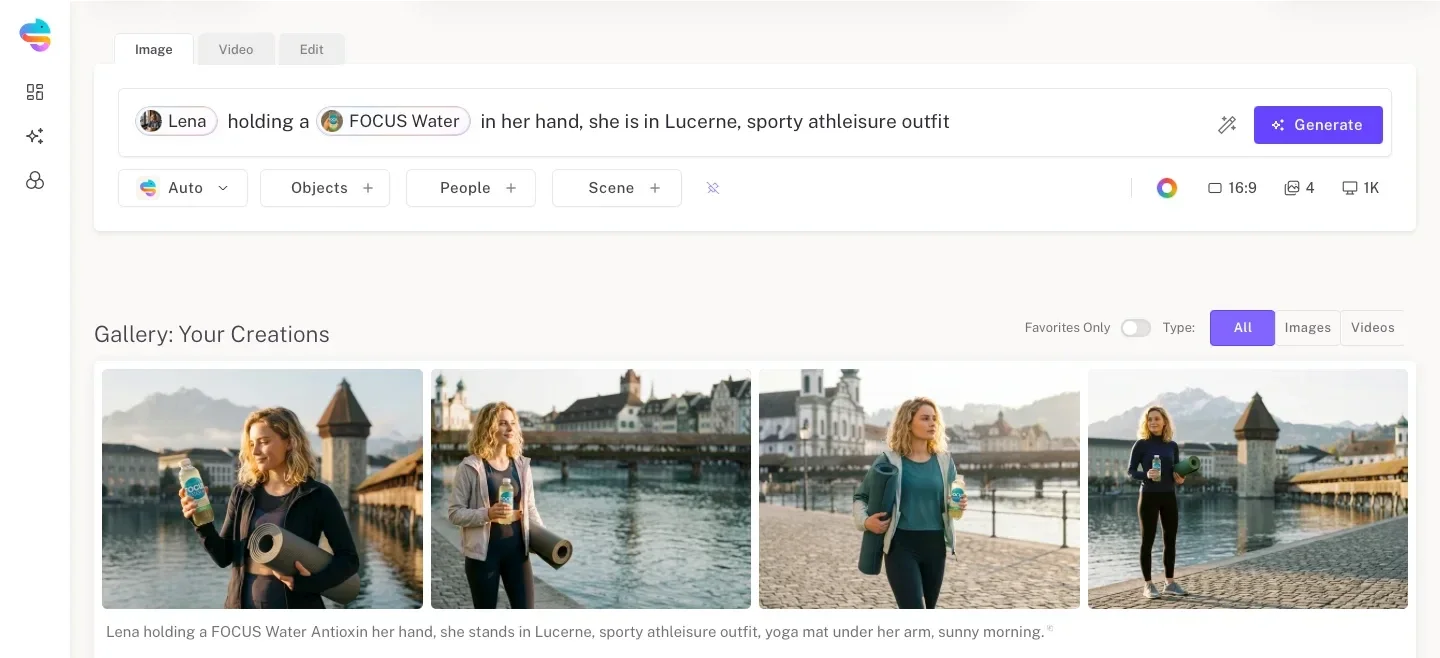
Oui. Avec les Model References, tu mentionnes plusieurs modèles entraînés dans un même prompt, par exemple une personne, un produit et un style, et ils se retrouvent dans une seule génération. La capture ci-dessous montre un prompt qui cite un modèle de personne et un modèle de produit. Les quatre résultats montrent la même femme avec la même bouteille, dans quatre cadrages différents à Lucerne.

Prompt Samsa citant un modèle de personne et un modèle de produit, au-dessus de quatre images générées de la même femme tenant la même bouteille à Lucerne
Deux modèles entraînés dans un prompt : la personne et le produit restent les mêmes, la pose et le cadrage changent. Capture de l’app Samsa ; la personne et les quatre images sont générées avec Samsa.

Qui peut utiliser un modèle entraîné ?

Toute personne de l’équipe qui y a accès. C’est là qu’un modèle entraîné prend l’avantage sur les deux autres approches : l’identité se trouve dans le modèle, pas dans la formulation ou le choix de référence de chacun. Le stagiaire et la directrice artistique partent du même produit et du même style. Samsa se décrit comme une IA qui apprend ton branding et crée des images et vidéos cohérentes, sans compétence en design. Si ton problème, c’est un produit, un visage ou un style qui revient sans cesse : entraîne des modèles IA sur ta marque.

Quand un modèle entraîné est-il de trop ?

Un modèle entraîné est de trop quand rien de précis ne doit revenir. Laisse tomber l’entraînement si l’un de ces cas décrit ta tâche :

  • Il te faut une image, une fois, pour un post ou une slide.
  • Le look appartient à une seule campagne et changera la saison prochaine.
  • Tu explores encore des pistes et tu ne sais pas encore ce que tu veux.
  • Le brief ne contient ni produit, ni personne, ni lieu, ni style d’illustration récurrent.
  • Tu produis seul une poignée d’images par an.

Dans ces cas, un bon prompt, éventuellement avec une image de référence, fait le travail, et un modèle serait une chose de plus à entretenir.

L’objection évidente : si l’entraînement est gratuit, pourquoi ne pas entraîner quand même ? Parce que les crédits ne sont pas le seul coût. Quelqu’un doit choisir les images d’entraînement, vérifier les premiers résultats et réentraîner quand le produit ou le style change. Cet effort est rentable quand le même produit, visage ou style revient semaine après semaine. Pour une image isolée, il ne l’est pas.

Samsa est d’ailleurs conçu pour ce public : les équipes marketing et branding qui produisent des visuels de marque chaque semaine. Si tu crées quelques images par an pour un projet perso, tu n’as pas besoin d’un modèle entraîné, et sans doute pas de Samsa non plus.

Comment les trois approches se comparent-elles ?

En une phrase : le prompt fixe un look, l’image de référence un exemple pour un seul résultat, et le modèle entraîné un style, un produit, une personne ou une scène précis pour toute l’équipe.

Prompt, image de référence et modèle entraîné comparés
CritèrePromptImage de référenceModèle entraîné
Ce que tu donnes à l’IADes mots, plus tes couleurs de marqueUne image d’exemple par générationUne image pour l’entraînement (deux à cinq recommandées)
Ce qui reste constantUn look décritLe look ou la composition de l’exemple, pour ce seul résultatUn style, un produit, une personne ou une scène précis
En équipeDépend de la formulation de chacunDépend de l’image choisie par chacunLe même modèle pour tous
PréparationAucuneAucune, mais il te faut les droits sur l’imageEnviron 15 secondes d’entraînement dans Samsa ; gratuit et illimité dans chaque formule
Idéal pourExploration, images ponctuelles, scènes génériquesReprendre un visuel existantÉléments de marque récurrents, production hebdomadaire
Où ça coinceUn produit ou un visage précis est réinventé à chaque foisRien n’est appris ; un résultat à la foisDe trop pour les images isolées et les looks éphémères

Lis le tableau par ligne, pas par colonne. Si la ligne qui compte pour toi est « En équipe », la réponse est le modèle entraîné. Si c’est « Préparation », commence par un prompt et vois jusqu’où il te mène.

Quelle approche choisir ? Le test en quatre questions

Réponds aux quatre questions dans l’ordre et arrête-toi à la première qui tranche.

  1. Un produit, une personne, un lieu ou un style d’illustration précis doit-il revenir ? Non : écris un prompt et ajoute tes couleurs de marque. Oui : passe à la question 2.
  2. Une fois, ou encore et encore ? Une fois : prends une image de référence. Encore et encore : passe à la question 3.
  3. Plusieurs personnes vont-elles créer ces images ? Oui : entraîne un modèle, pour que tout le monde parte du même. Non, mais le sujet revient souvent : un modèle t’évite quand même de réexpliquer la même chose dans chaque prompt.
  4. Plusieurs éléments de marque doivent-ils apparaître dans une image ? Entraîne un modèle pour chacun et combine-les dans un seul prompt.

L’erreur la plus fréquente que je vois dans les équipes : elles essaient de faire entrer leur style de marque dans des prompts toujours plus longs. Un prompt décrit un look, mais il ne le mémorise pas. Dès que deux personnes de l’équipe génèrent des images, la marque se retrouve en double. Si tu as besoin d’images pour la même marque chaque semaine, entraîne le style une fois. Une seule image de référence suffit déjà, et avec deux à cinq, ça devient vraiment bon. Et si tu n’as besoin que d’une image de temps en temps, une bonne image de référence te mène souvent plus loin qu’un modèle à toi.

Niklas Jung, Fondateur et CEO, Samsa

La plupart des équipes de marque répondent oui à la première question pour au moins une partie de leur travail. C’est pourquoi la réponse honnête est rarement une seule approche.

Comment les équipes combinent-elles les trois au quotidien ?

Au quotidien, les approches s’empilent. Les modèles entraînés portent les identités, le prompt porte la situation, les couleurs de marque portent la palette, et une image de référence oriente une composition précise quand il le faut.

Prenons une demande typique : ton produit sur une table de café, dans ton style d’illustration, pour un post sur les réseaux. Le modèle de produit et le modèle de style font en sorte que ce soit bien ta bouteille et ton style. Le prompt dit : table de café, lumière du matin, espace pour un titre en haut. La palette enregistrée garde les couleurs dans ta charte. Et si le post doit reprendre la mise en page du mois dernier, tu joins ce post comme référence, pour cette seule image.

Chaque couche fait un seul travail, et reste donc simple. Personne ne doit décrire le produit avec des mots, personne ne doit chercher une référence juste pour que les couleurs soient justes. C’est la différence entre des images et vidéos IA fidèles à ta marque comme routine, et des images réussies par chance.

Qu’en est-il des droits et du marquage IA ?

Tu peux utiliser commercialement les images générées avec Samsa dans chaque formule, à condition de détenir les droits sur les images d’entraînement. La même prudence vaut pour les images de référence : importe uniquement des images qui t’appartiennent ou dont tu as la licence, et obtiens le consentement d’une personne réelle avant d’entraîner un modèle sur elle.

Samsa marque les images générées avec des Content Credentials C2PA et un filigrane invisible, pour qu’elles restent identifiables comme générées par IA. Les exports vectoriels (SVG) ne sont pas encore couverts par ce marquage.

Questions fréquentes : images IA cohérentes avec sa marque

Combien d’images faut-il pour entraîner un modèle de marque ?

Une image suffit pour entraîner un modèle. Pour de meilleurs résultats, utilise deux à cinq bonnes images du produit, de la personne, du style ou de la scène à garder constant. La règle est la même pour chaque type de modèle. Choisis des images où le sujet se voit bien, car le modèle apprend ce que montrent les images d’entraînement.

L’entraînement d’un modèle coûte-t-il un supplément ?

Non. Dans Samsa, l’entraînement de modèles est gratuit et illimité dans chaque formule : tu peux entraîner un modèle par produit, personne, style ou scène sans payer par entraînement. Générer des images avec ces modèles consomme des crédits, comme toute autre génération. La création du compte est gratuite, mais il n’y a ni crédits offerts ni période d’essai. Les détails sont sur la page des prix.

Quelle IA peut combiner deux images ou plus, par exemple un produit et une personne ?

Il te faut un outil qui combine des modèles entraînés dans un même prompt. Dans Samsa, les Model References te permettent de mentionner plusieurs modèles entraînés dans un seul prompt, par exemple un produit, une personne et un style, et de les combiner en une seule génération. Chaque modèle garde sa partie constante, le prompt décrit la scène autour. C’est la façon habituelle de créer un visuel de campagne qui réunit plusieurs éléments de marque.

Puis-je utiliser commercialement des images générées par IA ?

Oui, dans chaque formule Samsa, à condition de détenir les droits sur les images avec lesquelles tu as entraîné tes modèles. Si tu entraînes sur des photos qui ne t’appartiennent pas et dont tu n’as pas la licence, Samsa ne peut pas t’accorder de droits d’utilisation commerciale. La même prudence vaut pour les images de référence importées : utilise des images qui t’appartiennent ou que tu as le droit d’utiliser.

Ai-je besoin d’un modèle entraîné pour une image ponctuelle ?

En général, non. Pour une image isolée, un prompt clair avec tes couleurs de marque suffit, et une image de référence aide si tu veux reprendre un visuel existant. Entraîne un modèle quand un produit, une personne, un lieu ou un style précis doit revenir sur de nombreuses images, ou quand plusieurs personnes de ton équipe créent la même chose.

Comment générer une image IA à partir d’une autre image ?

De deux façons. Utilise l’image comme image de référence si tu veux un seul résultat qui s’inspire de son look ou de sa composition. Entraîne un modèle avec elle si son sujet, par exemple ton produit ou ton bureau, doit réapparaître dans de nombreuses nouvelles images. Une image suffit pour entraîner un modèle ; deux à cinq sont recommandées.

Entraîne un modèle sur ce qui revient dans toutes tes images

Crée ton compte (gratuit). L’entraînement est gratuit et illimité dans chaque formule ; générer des images consomme des crédits.

Entraîne ton premier modèle

# Images IA cohérentes avec sa marque : prompt, image de référence ou modèle entraîné ?

> Créer des images IA cohérentes avec sa marque : prompt, image de référence ou modèle entraîné, ce que chacun fixe et quand l’entraînement est de trop.

Language: Français · Machine index: [https://samsa.ai/llms.txt](/llms.txt)

---

Trois approches mènent à des images IA cohérentes avec ta marque. Le prompt décrit le look avec des mots : rapide, mais chaque résultat est une nouvelle interprétation. L’image de référence montre à l’IA un exemple à suivre pour une seule génération. Ton propre modèle entraîné apprend un style, un produit, une personne ou une scène à partir d’une image (deux à cinq recommandées) et le garde constant pour toute ton équipe. La plupart des équipes combinent les trois.

Niklas Jung · Fondateur et CEO, Samsa Publié le 2026-09-30 · 16 min de lecture

---

## Que veut dire « cohérent avec ta marque » pour une image IA ?

Une image IA est cohérente avec ta marque quand ce qui rend ta marque reconnaissable ressort à l’identique d’une image à l’autre. Avant de choisir une méthode, pose-toi donc une question : qu’est-ce qui doit rester constant ? La réponse tombe dans l’une de deux catégories.

- Un look. Tes couleurs, un type de lumière, la photo ou l’illustration, une ambiance. Un look se décrit : les mots et les images d’exemple te mènent déjà loin.

- Une identité. Un élément précis que l’on doit reconnaître : ton style d’illustration, ton produit avec son emballage, une personne en particulier, ta boutique ou ton bureau. Une identité doit correspondre, pas seulement ressembler.

Dans la pratique, il faut presque toujours les deux. Un visuel de campagne avec ton produit, conforme à ta charte graphique, demande le look (couleurs, lumière) et deux identités (le produit et le style d’illustration). Garde cette distinction en tête : c’est précisément là que les trois approches diffèrent. Samsa propose les trois, et ce guide les compare côte à côte, y compris pour savoir quand un modèle entraîné est de trop.

Pourquoi un générateur généraliste s’éloigne-t-il de ta marque ? Un modèle généraliste sait à quoi ressemble une bouteille d’eau, pas à quoi ressemble ta bouteille d’eau. Des chercheurs ont décrit ce manque dès 2022 : les grands modèles texte-image produisaient des images variées et de grande qualité à partir d’un prompt, mais ne savaient pas reproduire l’apparence d’un sujet précis à partir d’une série d’images de référence. Les mots, en plus, restent un outil grossier pour définir une image. Un article de recherche de 2023 sur les prompts visuels le dit sans détour : obtenir l’image voulue avec un simple prompt texte est très délicat et demande souvent un travail de prompt engineering complexe.

---

## Approche 1 : jusqu’où va un prompt ?

Un prompt te donne un look cohérent, à condition que ce look se décrive avec des mots et que toute l’équipe le formule de la même façon. C’est le point de départ le plus rapide, sans aucune préparation.

### Que peut fixer un prompt ?

Tout ce qui se décrit : le sujet, le cadrage, la lumière, l’ambiance, un style nommé comme « illustration vectorielle en aplats » ou « photo reportage chaleureuse ». Dans un [générateur d’images IA](/fr/image/) pensé pour les marques, quelques fonctions rendent le prompt moins fragile. Dans Samsa, tu enregistres une fois tes couleurs de marque (principale, secondaire et d’accent) et tu les sélectionnes au moment de générer, au lieu de retaper des codes couleur. Un améliorateur de prompt transforme une idée courte en description d’image détaillée. Et tu peux écrire ton prompt en français, en allemand, en italien ou en anglais, ce qui simplifie la vie d’une équipe répartie entre Genève, Zurich et Lugano.

### Où le prompt atteint-il ses limites ?

Chaque génération est une nouvelle interprétation de tes mots. Pour une ambiance, ça va ; pour tout ce qui est précis, c’est un problème. Décris ton produit, et le modèle invente un produit plausible. Décris ta directrice, et tu obtiens une inconnue plausible. Lance deux fois le même prompt, et les détails bougent.

La deuxième limite, c’est l’équipe. Dix personnes écrivent dix versions du même prompt, et dix looks légèrement différents reviennent. Tant qu’on ne fait que prompter, la cohérence dépend de la formulation de chacun, pas de l’outil.

### Comment rendre tes prompts plus cohérents ?

Mettez-vous d’accord sur un modèle de prompt commun. Six champs couvrent la plupart des images de marque :

**Un modèle de prompt partagé pour les images de marque**

| Champ | Ce que l’équipe fixe |

| --- | --- |

| Sujet | Ce que montre l’image, en une phrase |

| Style | Photo ou illustration, et laquelle : reportage, studio, vectoriel en aplats |

| Lumière | Moment de la journée, dure ou douce, chaude ou froide |

| Cadrage | Plan, distance de la caméra, espace libre pour un titre |

| Couleurs | La palette de la charte graphique, ou les couleurs de marque enregistrées dans l’outil |

| À éviter | Ce qui ne doit jamais apparaître : logos tiers, texte dans l’image, couleur hors charte |

Idéal pour : explorer des idées, les images ponctuelles, les arrière-plans et scènes génériques, et tout brief sans produit, personne ou lieu récurrent.

---

## Approche 2 : qu’apporte une image de référence ?

Une image de référence montre à l’IA ce que tu veux au lieu de le décrire, pour une génération à la fois. Tu joins une image existante à ton prompt, et le résultat s’inspire de son look, de ses couleurs ou de sa composition.

> **Deux sortes d’images d’exemple** Dans ce guide, une image de référence est une image que tu donnes à l’IA au moment de générer, pour un seul résultat. Les images sur lesquelles tu entraînes un modèle sont des images d’entraînement. Certaines pages produit, y compris la page d’entraînement de Samsa, appellent aussi les images d’entraînement « images de référence » ; elles parlent alors de la seconde sorte.

### Que retient une image de référence ?

Ce qui se dit mal avec des mots : une palette précise, le grain d’une photo, l’équilibre d’une mise en page. L’article de 2023 qui présente une méthode de prompt visuel cite le vieil adage selon lequel une image vaut mille mots. C’est tout l’intérêt de cette approche : si tu as déjà un visuel de campagne qui fonctionne, le montrer vaut mieux que le décrire.

### Où l’image de référence atteint-elle ses limites ?

- Elle guide un résultat, rien n’est appris. La génération suivante repart de zéro, sauf si tu joins à nouveau l’image.

- Dans une équipe, le résultat dépend de l’image choisie par chacun. Deux personnes, deux références, deux looks.

- Elle oriente vers un exemple, sans apprendre ton produit au modèle. Si un produit ou un visage doit être reconnaissable sur chaque image, l’approche 3 est le meilleur outil.

- Il te faut les droits sur l’image. Importe uniquement des images qui t’appartiennent ou dont tu as la licence.

Dans Samsa, importer tes propres images ne coûte aucun crédit. Tu peux t’en servir comme références, les retoucher ou en créer des variantes.

Idéal pour : reprendre un visuel de campagne existant et décliner ponctuellement un visuel que tu as déjà. C’est aussi la réponse rapide si tu te demandes comment générer une image IA à partir d’une autre image, pour un seul résultat. Si le sujet de cette image doit revenir encore et encore, lis la suite.

---

## Approche 3 : que garde constant un modèle entraîné ?

Un modèle entraîné garde un élément précis identique sur chaque image : un style, un produit, une personne ou une scène. Tu lui montres une fois quelques images de cet élément, et ensuite n’importe qui dans ton équipe peut le placer dans une nouvelle image en l’appelant par son nom.

L’idée n’est pas nouvelle. L’article DreamBooth de 2022 a montré qu’en affinant un modèle texte-image pré-entraîné sur quelques images seulement d’un sujet, on peut générer de nouvelles images photoréalistes de ce sujet dans d’autres scènes. Les modèles et les méthodes ont évolué depuis, le principe reste : l’identité s’apprend, elle ne se décrit pas.

### Quels modèles peux-tu entraîner ?

Samsa entraîne quatre types de modèles, un pour chaque sorte d’identité qu’une marque répète :

- Style : un style d’illustration, une signature photo ou un design system.

- Produits : une bouteille, un emballage, un appareil.

- Personnes : une fondatrice, un ambassadeur ou une mascotte de marque.

- Scènes : ton bureau, ta boutique ou un autre lieu qui fait partie de ta marque.
*(image: Six images dans deux styles, deux personnes montrées chacune dans trois décors, un bureau et un bâtiment en plusieurs variantes)*

Exemples de la page d’entraînement de Samsa, tous générés avec Samsa : deux styles (en haut à gauche), deux personnes (en haut à droite) et deux scènes (en bas). Chaque identité reste reconnaissable d’une image à l’autre.

### De quoi as-tu besoin pour entraîner un modèle IA sur tes images ?

Une image suffit pour entraîner un modèle ; deux à cinq sont recommandées, quel que soit le type de modèle. Choisis des images où le produit, la personne, le style ou le lieu se voit bien, car le modèle apprend ce que montrent les images d’entraînement. Pour un produit, un [modèle de produit à partir d’une seule photo](/fr/photographie-de-produit/) est un point de départ réaliste. La [checklist pour préparer tes images d’entraînement](https://samsa.ai/fr/guides/entrainer-une-ia-avec-ses-images/) détaille les images qui conviennent à chaque type de modèle et ce qu’il faut vérifier avant de les importer.

Dans Samsa, l’entraînement prend environ 15 secondes, et [l’entraînement est gratuit et illimité dans chaque formule](/fr/prix/). Générer des images avec le modèle consomme des crédits, comme toute autre génération.

> **Fine-tuning et LoRA** Tu croiseras ces deux termes dès que tu te renseignes sur les modèles personnalisés. Le fine-tuning consiste à poursuivre l’entraînement d’un modèle existant sur tes propres images. LoRA (Low-Rank Adaptation) vient d’un article de 2021 sur les modèles de langage : elle gèle les poids du modèle d’origine et entraîne à la place un petit nombre de paramètres ajoutés, ce qui réduit fortement ce qu’il faut entraîner. Ce sont des techniques générales, pas une description de la façon dont Samsa entraîne ses modèles.

### Peux-tu combiner plusieurs modèles dans une seule image ?

Oui. Avec les Model References, tu mentionnes plusieurs modèles entraînés dans un même prompt, par exemple une personne, un produit et un style, et ils se retrouvent dans une seule génération. La capture ci-dessous montre un prompt qui cite un modèle de personne et un modèle de produit. Les quatre résultats montrent la même femme avec la même bouteille, dans quatre cadrages différents à Lucerne.
*(image: Prompt Samsa citant un modèle de personne et un modèle de produit, au-dessus de quatre images générées de la même femme tenant la même bouteille à Lucerne)*

Deux modèles entraînés dans un prompt : la personne et le produit restent les mêmes, la pose et le cadrage changent. Capture de l’app Samsa ; la personne et les quatre images sont générées avec Samsa.

### Qui peut utiliser un modèle entraîné ?

Toute personne de l’équipe qui y a accès. C’est là qu’un modèle entraîné prend l’avantage sur les deux autres approches : l’identité se trouve dans le modèle, pas dans la formulation ou le choix de référence de chacun. Le stagiaire et la directrice artistique partent du même produit et du même style. Samsa se décrit comme une IA qui apprend ton branding et crée des images et vidéos cohérentes, sans compétence en design. Si ton problème, c’est un produit, un visage ou un style qui revient sans cesse : [entraîne des modèles IA sur ta marque](/fr/entrainer/).

---

## Quand un modèle entraîné est-il de trop ?

Un modèle entraîné est de trop quand rien de précis ne doit revenir. Laisse tomber l’entraînement si l’un de ces cas décrit ta tâche :

- Il te faut une image, une fois, pour un post ou une slide.

- Le look appartient à une seule campagne et changera la saison prochaine.

- Tu explores encore des pistes et tu ne sais pas encore ce que tu veux.

- Le brief ne contient ni produit, ni personne, ni lieu, ni style d’illustration récurrent.

- Tu produis seul une poignée d’images par an.

Dans ces cas, un bon prompt, éventuellement avec une image de référence, fait le travail, et un modèle serait une chose de plus à entretenir.

L’objection évidente : si l’entraînement est gratuit, pourquoi ne pas entraîner quand même ? Parce que les crédits ne sont pas le seul coût. Quelqu’un doit choisir les images d’entraînement, vérifier les premiers résultats et réentraîner quand le produit ou le style change. Cet effort est rentable quand le même produit, visage ou style revient semaine après semaine. Pour une image isolée, il ne l’est pas.

Samsa est d’ailleurs conçu pour ce public : les équipes marketing et branding qui produisent des visuels de marque chaque semaine. Si tu crées quelques images par an pour un projet perso, tu n’as pas besoin d’un modèle entraîné, et sans doute pas de Samsa non plus.

---

## Comment les trois approches se comparent-elles ?

En une phrase : le prompt fixe un look, l’image de référence un exemple pour un seul résultat, et le modèle entraîné un style, un produit, une personne ou une scène précis pour toute l’équipe.

**Prompt, image de référence et modèle entraîné comparés**

| Critère | Prompt | Image de référence | Modèle entraîné |

| --- | --- | --- | --- |

| Ce que tu donnes à l’IA | Des mots, plus tes couleurs de marque | Une image d’exemple par génération | Une image pour l’entraînement (deux à cinq recommandées) |

| Ce qui reste constant | Un look décrit | Le look ou la composition de l’exemple, pour ce seul résultat | Un style, un produit, une personne ou une scène précis |

| En équipe | Dépend de la formulation de chacun | Dépend de l’image choisie par chacun | Le même modèle pour tous |

| Préparation | Aucune | Aucune, mais il te faut les droits sur l’image | Environ 15 secondes d’entraînement dans Samsa ; gratuit et illimité dans chaque formule |

| Idéal pour | Exploration, images ponctuelles, scènes génériques | Reprendre un visuel existant | Éléments de marque récurrents, production hebdomadaire |

| Où ça coince | Un produit ou un visage précis est réinventé à chaque fois | Rien n’est appris ; un résultat à la fois | De trop pour les images isolées et les looks éphémères |

Lis le tableau par ligne, pas par colonne. Si la ligne qui compte pour toi est « En équipe », la réponse est le modèle entraîné. Si c’est « Préparation », commence par un prompt et vois jusqu’où il te mène.

---

## Quelle approche choisir ? Le test en quatre questions

Réponds aux quatre questions dans l’ordre et arrête-toi à la première qui tranche.

1. Un produit, une personne, un lieu ou un style d’illustration précis doit-il revenir ? Non : écris un prompt et ajoute tes couleurs de marque. Oui : passe à la question 2.

2. Une fois, ou encore et encore ? Une fois : prends une image de référence. Encore et encore : passe à la question 3.

3. Plusieurs personnes vont-elles créer ces images ? Oui : entraîne un modèle, pour que tout le monde parte du même. Non, mais le sujet revient souvent : un modèle t’évite quand même de réexpliquer la même chose dans chaque prompt.

4. Plusieurs éléments de marque doivent-ils apparaître dans une image ? Entraîne un modèle pour chacun et combine-les dans un seul prompt.

> L’erreur la plus fréquente que je vois dans les équipes : elles essaient de faire entrer leur style de marque dans des prompts toujours plus longs. Un prompt décrit un look, mais il ne le mémorise pas. Dès que deux personnes de l’équipe génèrent des images, la marque se retrouve en double. Si tu as besoin d’images pour la même marque chaque semaine, entraîne le style une fois. Une seule image de référence suffit déjà, et avec deux à cinq, ça devient vraiment bon. Et si tu n’as besoin que d’une image de temps en temps, une bonne image de référence te mène souvent plus loin qu’un modèle à toi.

> — Niklas Jung, Fondateur et CEO, Samsa

La plupart des équipes de marque répondent oui à la première question pour au moins une partie de leur travail. C’est pourquoi la réponse honnête est rarement une seule approche.

---

## Comment les équipes combinent-elles les trois au quotidien ?

Au quotidien, les approches s’empilent. Les modèles entraînés portent les identités, le prompt porte la situation, les couleurs de marque portent la palette, et une image de référence oriente une composition précise quand il le faut.

Prenons une demande typique : ton produit sur une table de café, dans ton style d’illustration, pour un post sur les réseaux. Le modèle de produit et le modèle de style font en sorte que ce soit bien ta bouteille et ton style. Le prompt dit : table de café, lumière du matin, espace pour un titre en haut. La palette enregistrée garde les couleurs dans ta charte. Et si le post doit reprendre la mise en page du mois dernier, tu joins ce post comme référence, pour cette seule image.

Chaque couche fait un seul travail, et reste donc simple. Personne ne doit décrire le produit avec des mots, personne ne doit chercher une référence juste pour que les couleurs soient justes. C’est la différence entre des [images et vidéos IA fidèles à ta marque](/fr/) comme routine, et des images réussies par chance.

---

## Qu’en est-il des droits et du marquage IA ?

Tu peux utiliser commercialement les images générées avec Samsa dans chaque formule, à condition de détenir les droits sur les images d’entraînement. La même prudence vaut pour les images de référence : importe uniquement des images qui t’appartiennent ou dont tu as la licence, et obtiens le consentement d’une personne réelle avant d’entraîner un modèle sur elle.

Samsa marque les images générées avec des Content Credentials C2PA et un filigrane invisible, pour qu’elles restent identifiables comme générées par IA. Les exports vectoriels (SVG) ne sont pas encore couverts par ce marquage.

---

## Questions fréquentes : images IA cohérentes avec sa marque

### Combien d’images faut-il pour entraîner un modèle de marque ?

Une image suffit pour entraîner un modèle. Pour de meilleurs résultats, utilise deux à cinq bonnes images du produit, de la personne, du style ou de la scène à garder constant. La règle est la même pour chaque type de modèle. Choisis des images où le sujet se voit bien, car le modèle apprend ce que montrent les images d’entraînement.

### L’entraînement d’un modèle coûte-t-il un supplément ?

Non. Dans Samsa, l’entraînement de modèles est gratuit et illimité dans chaque formule : tu peux entraîner un modèle par produit, personne, style ou scène sans payer par entraînement. Générer des images avec ces modèles consomme des crédits, comme toute autre génération. La création du compte est gratuite, mais il n’y a ni crédits offerts ni période d’essai. Les détails sont sur [la page des prix](/fr/prix/).

### Quelle IA peut combiner deux images ou plus, par exemple un produit et une personne ?

Il te faut un outil qui combine des modèles entraînés dans un même prompt. Dans Samsa, les Model References te permettent de mentionner plusieurs modèles entraînés dans un seul prompt, par exemple un produit, une personne et un style, et de les combiner en une seule génération. Chaque modèle garde sa partie constante, le prompt décrit la scène autour. C’est la façon habituelle de créer un visuel de campagne qui réunit plusieurs éléments de marque.

### Puis-je utiliser commercialement des images générées par IA ?

Oui, dans chaque formule Samsa, à condition de détenir les droits sur les images avec lesquelles tu as entraîné tes modèles. Si tu entraînes sur des photos qui ne t’appartiennent pas et dont tu n’as pas la licence, Samsa ne peut pas t’accorder de droits d’utilisation commerciale. La même prudence vaut pour les images de référence importées : utilise des images qui t’appartiennent ou que tu as le droit d’utiliser.

### Ai-je besoin d’un modèle entraîné pour une image ponctuelle ?

En général, non. Pour une image isolée, un prompt clair avec tes couleurs de marque suffit, et une image de référence aide si tu veux reprendre un visuel existant. Entraîne un modèle quand un produit, une personne, un lieu ou un style précis doit revenir sur de nombreuses images, ou quand plusieurs personnes de ton équipe créent la même chose.

### Comment générer une image IA à partir d’une autre image ?

De deux façons. Utilise l’image comme image de référence si tu veux un seul résultat qui s’inspire de son look ou de sa composition. Entraîne un modèle avec elle si son sujet, par exemple ton produit ou ton bureau, doit réapparaître dans de nombreuses nouvelles images. Une image suffit pour entraîner un modèle ; deux à cinq sont recommandées.

---

## Sources

1. [IP-Adapter: Text Compatible Image Prompt Adapter for Text-to-Image Diffusion Models](https://arxiv.org/abs/2308.06721) — arXiv, consulté le 2026-09-30

2. [DreamBooth: Fine Tuning Text-to-Image Diffusion Models for Subject-Driven Generation](https://arxiv.org/abs/2208.12242) — arXiv, consulté le 2026-09-30

3. [LoRA: Low-Rank Adaptation of Large Language Models](https://arxiv.org/abs/2106.09685) — arXiv, consulté le 2026-09-30

---

**Entraîne un modèle sur ce qui revient dans toutes tes images** Crée ton compte (gratuit). L’entraînement est gratuit et illimité dans chaque formule ; générer des images consomme des crédits. [Entraîne ton premier modèle](/fr/entrainer/)